
Modelos
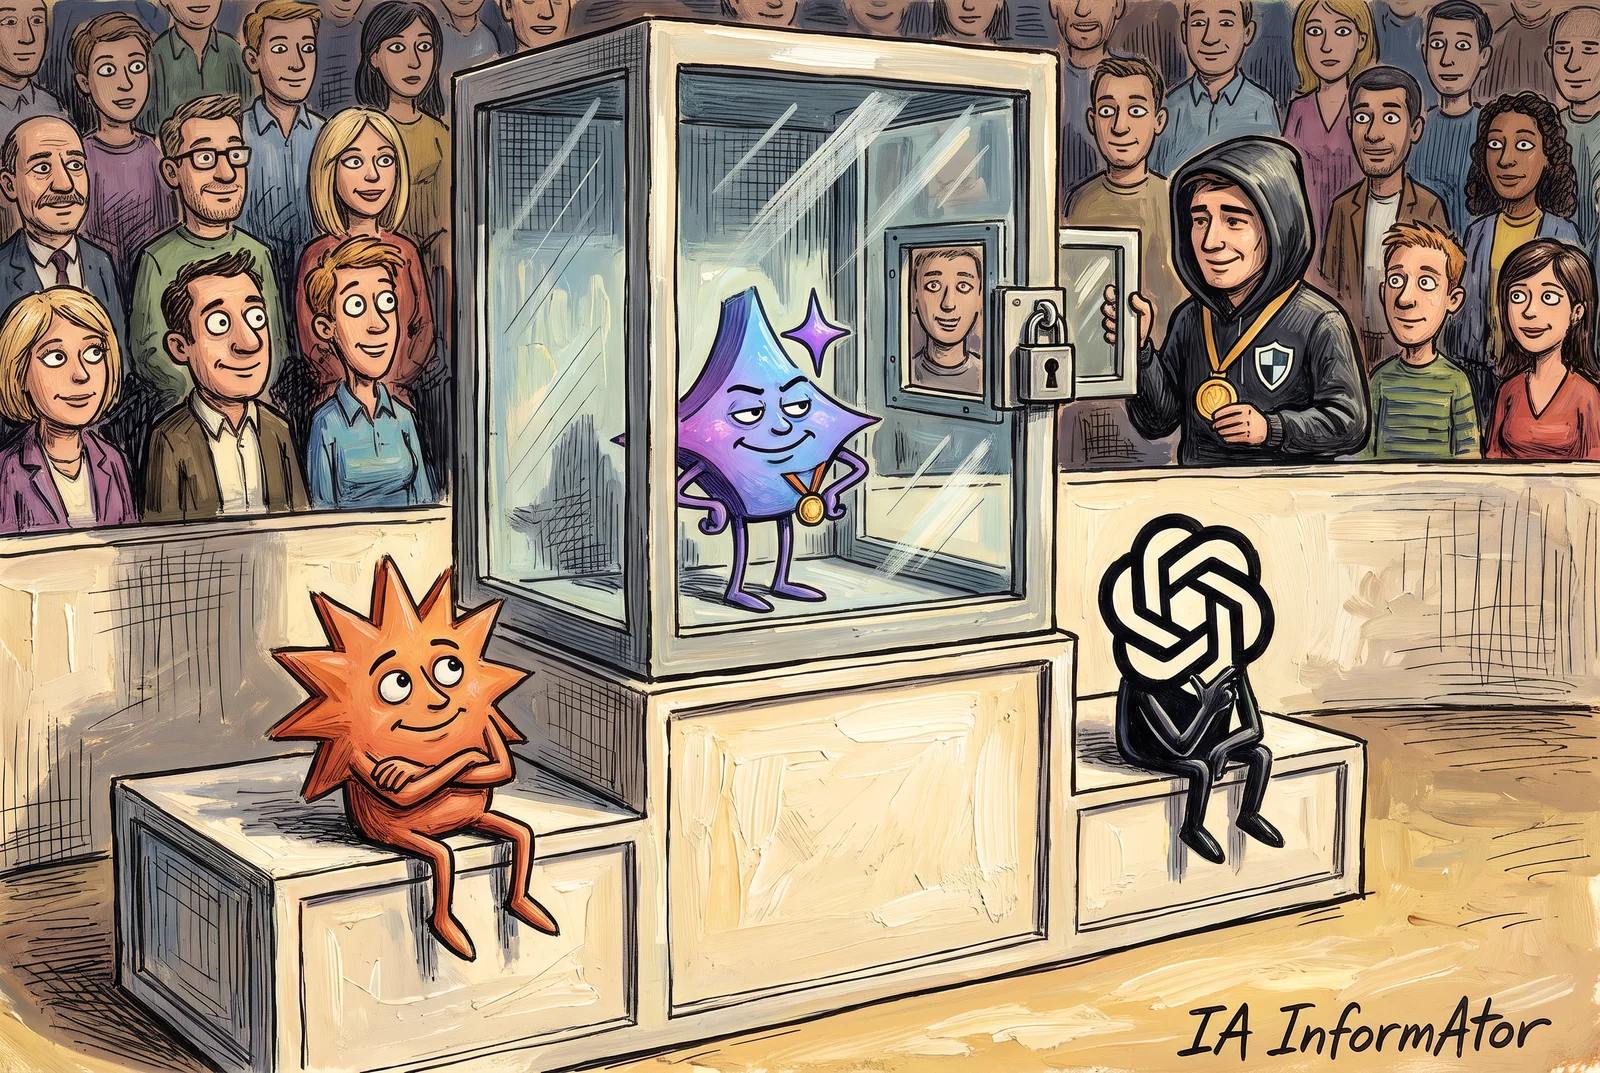
Google corona a Carbon y lo encierra en el búnker
Google presentó el 28 de octubre de 2026 Gemini 4 Carbon, su modelo más potente, y el mismo día pasó a ser el número uno del índice de Artificial Analysis, una empresa que evalúa modelos de inteligencia artificial. Pero no está a la venta: según Google, de momento solo llega a un grupo de equipos de ciberdefensa, y desarrolladores, empresas y consumidores tendrán que esperar, sin fecha.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Según Google, Gemini 4 Carbon es su modelo más potente, con resultados punteros en ciberseguridad y en tareas largas.
- Artificial Analysis le da 59 puntos en la versión 5.0 de su Intelligence Index, uno más que Claude Opus 5.5, aunque precisa que Carbon no lidera ni en programación ni en trabajo de conocimiento.
- Según Google, Carbon está en cabeza en las tres fases de la ciberdefensa: encontrar vulnerabilidades, comprobar si se pueden explotar y parchearlas.
- El contrapeso lo pone el evaluador externo: la tasa de alucinación de Carbon sube respecto a la de Argon, aunque según Artificial Analysis sigue siendo la segunda más baja de todos los modelos.
- El acceso empieza esta semana por un primer grupo de ciberdefensores y se ampliará poco a poco a socios de confianza del programa Fairwind.
El modelo más potente de Google
Google presentó el 28 de octubre Gemini 4 Carbon sin rodeos: es su «siguiente modelo frontier» y el más potente que tiene, con resultados punteros en ciberseguridad y en tareas de largo recorrido. Firma el anuncio Koray Kavukcuoglu, vicepresidente sénior de Google DeepMind, el laboratorio de IA de Google, y arquitecto jefe de IA de la compañía.
Carbon parte de Gemini 4 Argon, anunciado el 30 de septiembre y abierto a desarrolladores el 13 de octubre.
Está pensado para problemas de ingeniería largos y difíciles. Según Google, sus equipos lo han visto trabajar durante días, sorteando callejones sin salida, para dar con la causa de errores sutiles y corregirlos en bases de código grandes y en sistemas de bajo nivel.
Primero en un índice externo
Ver los datos en tabla
| Gemini 4 Carbon (high) | Claude Opus 5.5 (max) | GPT-6 Astra (max) | GPT-6.1 Sol (max) | Gemini 4 Argon (high) | |
|---|---|---|---|---|---|
| Puntuación | 59puntos | 58puntos | 57puntos | 55puntos | 50puntos |
Según Artificial Analysis, Carbon, medido con esfuerzo de razonamiento alto, es el nuevo número uno de la versión 5.0 de su Intelligence Index, con 59 puntos. Un día antes, al estrenar esa versión, el primer puesto era de Claude Opus 5.5, de Anthropic.
El evaluador matiza el liderato. Carbon mejora mucho en programación y en trabajo de conocimiento, sobre todo frente a otros modelos Gemini, pero no va primero en esas áreas.
En programación, todavía segundo
| Prueba | Gemini 4 Carbon (high) | Claude Opus 5.5 (max) |
|---|---|---|
| Coding Agent Index (puntos) | 59 | 62 |
| FrontierCode v1.1 | 51 % | 56 % |
| Terminal-Bench 4.0 | 64 % (segundo, tras Kimi K3.1 Pro) | — |
Carbon logra la mejor nota en cuatro de las nueve pruebas del índice: HLE-Diamond, Terminal-Bench-Science, AA-Omniscience y AutomationBench-AA. No va primero ni al programar con agentes ni en trabajo de conocimiento.
Según Artificial Analysis, con Antigravity CLI, de Google, Carbon queda segundo en su Coding Agent Index, por detrás de Claude Code, la herramienta de programación de Anthropic, con Claude Opus 5.5. También es segundo en Terminal-Bench 4.0, con un 64 %, tras Kimi K3.1 Pro (67 %), y en FrontierCode v1.1, con un 51 %; en esta última, detrás de Opus 5.5 (56 %). El evaluador recuerda que Google se había quedado atrás en este terreno, así que la mejora destaca.
Sabe más, pero se inventa más
| Modelo | Puntuación | Tasa de alucinación |
|---|---|---|
| Gemini 4 Carbon (high) | 54 | 11 % |
| Claude Opus 5.5 (max) | 48 | 50 % |
| Gemini 4 Argon | 46 | 4 % |
En AA-Omniscience v1.1, una de las pruebas del índice, Carbon saca la mejor nota, por delante de Opus 5.5 y de Argon.
Pero su tasa de alucinación sube frente a la de Argon. Según Artificial Analysis, aun así es la segunda más baja de todos los modelos, solo por encima de la del propio Argon y muy por debajo del 50 % de Opus 5.5 y GPT-6 Astra.
Más barato por tarea que Opus
| Modelo | Coste por tarea |
|---|---|
| Claude Opus 5.5 (max) | 10,04 $ |
| Gemini 4 Carbon (high) | 7,76 $ |
| Gemini 4 Argon | 7,68 $ |
| GPT-6 Astra (max) | 6,25 $ |
Artificial Analysis también pone precio a la nota. Con la tarifa estándar, resolver cada tarea de su índice con Carbon cuesta alrededor de un 23 % menos que con Opus 5.5, aunque unas 1,2 veces lo que cuesta con GPT-6 Astra, de OpenAI.
Parte de la diferencia está en lo que escribe: según el evaluador, Carbon gasta 123.000 tokens de salida por tarea, un 29 % menos que Opus 5.5. Y con la misma tarifa estándar que Argon, cuesta prácticamente lo mismo por tarea y saca 9 puntos más en el índice.
Encontrar, explotar, parchear
| Fase | Prueba | Gemini 4 Carbon |
|---|---|---|
| Encontrar vulnerabilidades | SEC-bench Pro | 88,2 % |
| Comprobar si se pueden explotar | ExploitGym | 54,8 % |
| Parchear la causa raíz | CWE-bench (Collinear) | 71,0 % |
La gran apuesta de Carbon es la ciberseguridad. Según Google, está en cabeza en las tres fases de la defensa: detectar vulnerabilidades, validarlas y repararlas. Lo mide en tres pruebas de referencia externas, con el modelo evaluado sin salvaguardas activadas.
Según Google, en SEC-bench Pro Carbon descubre por su cuenta fallos complejos escondidos en software real; en ExploitGym comprueba cuáles se pueden explotar, algo en lo que los defensores se apoyan cada vez más para decidir qué arreglar primero; y en CWE-bench, de la empresa Collinear, convierte esos hallazgos en parches que funcionan.
Google añade datos de casa. Según la empresa, en sus pruebas internas Carbon duplica con creces la tasa de éxito de Argon al generar código seguro, y el equipo de Chrome asegura que rindió más de diez veces mejor que «el gran modelo frontier de otro laboratorio», al que no identifica, al generar parches de calidad. Wiz, que Google presenta como su plataforma de seguridad en la nube, lo ve en cabeza en pruebas de penetración web.
Según Google, ni un ataque de inyección coló
Según Google, Carbon resistió todos los intentos de ataque evaluados en el Indirect Prompt Injection (IPI) Benchmark de Gray Swan, una empresa de seguridad de IA fundada por investigadores de la Universidad Carnegie Mellon que hace pruebas adversarias para empresas y laboratorios. Argon ya encabezaba esa prueba, con una tasa de ataques con éxito muy baja.
Menos atajos y menos inventos, dice Google
| Indicador | Resultado |
|---|---|
| Trampas con éxito en Terminal-Bench 4.0 | 0,0 % |
| Intentos de trampa en Terminal-Bench 4.0 | 0,4 % |
| Alertas de desalineación de alta gravedad (entornos internos) | Casi un 80 % menos |
| Afirmaciones sin respaldo | Unas 2 veces menos que Argon |
| Extralimitaciones (hacer más de lo pedido) | 26 % menos |
| Infraservicio (hacer menos de lo pedido) | 29 % menos |
| Ataques de inyección con éxito (IPI Benchmark de Gray Swan) | 0,0 % (Argon: 0,7 %) |
Google dice que con Carbon se propuso ir un paso más allá en alineamiento y lo entrenó para responder bien ante tareas complejas o bajo presión. Según la empresa, recortó los atajos durante el entrenamiento sin perder calidad al programar, y en entornos reales de programación con sus equipos las alertas graves de desalineación cayeron casi un 80 %.
Según Google, también es más honesto: deja por escrito las salvedades de método y avisa de las discrepancias antes de actuar. Si no puede completar una acción, no la ejecuta y enumera lo que todavía hace falta, en lugar de inventar o de esquivar la falta de pruebas. Todas estas cifras son mediciones de la propia empresa.
Solo para ciberdefensores, de momento
| Tarifa | Entrada | Salida |
|---|---|---|
| Estreno | 2 $ | 10 $ |
| Estándar, tras el estreno | 4 $ | 20 $ |
Carbon no está a la venta. Google dice que lo despliega de forma deliberada y que participa en el proceso voluntario del Gobierno de Estados Unidos para probar los modelos antes de lanzarlos. Según la empresa, desde esta semana lo pone en manos de un primer grupo de ciberdefensores, y el acceso se irá ampliando poco a poco a otros socios de confianza a través del programa Fairwind.
Fairwind es el programa de Google DeepMind que da acceso anticipado a modelos avanzados a defensores prioritarios, como gobiernos, proveedores sanitarios y empresas de telecomunicaciones; dice trabajar con más de 650 socios en todo el mundo. Solo admite tareas de doble uso con fines defensivos o de investigación académica, como la simulación autorizada de amenazas o el análisis de software malicioso, y cada organización solo puede dar acceso a sus equipos internos de ciberseguridad, respuesta a incidentes o pruebas de penetración. Su página todavía describe el acceso a Argon.
Desarrolladores, empresas y consumidores tendrán que esperar. Según Google, la empresa quiere seguir recogiendo opiniones y ajustando las salvaguardas antes de abrirlo, y promete hacerlo «lo antes posible», sin fecha. Según Artificial Analysis, Carbon tiene una ventana de contexto de un millón de tokens y acepta texto, imagen, vídeo y voz, aunque solo responde con texto.
El precio ya está fijado: durante el estreno costará lo mismo que Argon, con la entrada en caché un 95 % más barata, y después se duplicará. Según Artificial Analysis, el descuento de estreno no tiene fecha de fin confirmada.
Conclusión
Gemini 4 Carbon llega con el primer puesto en un índice externo, un coste por tarea por debajo del de Opus 5.5 y récords en ciberdefensa que, eso sí, mide y comunica la propia Google. Trae también dos matices del evaluador: no lidera en programación ni en trabajo de conocimiento, y alucina más que Argon. Lo siguiente que habrá que mirar es cuándo sale del círculo de ciberdefensores y si ese primer puesto aguanta cuando lo pueda probar cualquiera.
Fuentes primarias
- Google — Introducing Gemini 4 Carbon (28-10-2026) ↗
- Artificial Analysis — Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5 (28-10-2026) ↗
- Artificial Analysis — Announcing Artificial Analysis Intelligence Index v5 (27-10-2026) ↗
- Google DeepMind — Fairwind Program (consulta 29-10-2026) ↗
- AI Informator — Google abre Gemini 4 Argon a la API y a más suscriptores ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios