
Legal
Wikipedia: Entrenar sí, copiar sin citar no
La Wikimedia Foundation, la organización sin ánimo de lucro que opera Wikipedia, ha pedido al juez del pleito de The New York Times contra OpenAI y Microsoft que no dé la razón entera a ninguno. Según su escrito, entrenar modelos de IA con obras protegidas sería probablemente uso legítimo (fair use); copiarlas para responder en el momento, con la técnica llamada RAG (retrieval-augmented generation), probablemente no, y debería respetar la licencia de cada fuente, lo que en Wikipedia obliga a citar.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- La Wikimedia Foundation pidió el 29 de octubre de 2026 al juez Sidney H. Stein, del tribunal federal del Distrito Sur de Nueva York, permiso para presentar un escrito como amicus curiae en el caso que agrupa doce demandas contra OpenAI.
- El escrito va «en apoyo de ninguna parte»: ni de The New York Times, que demandó en 2023, ni de OpenAI y Microsoft.
- Según la fundación, entrenar un modelo de propósito general con obras protegidas es probablemente uso legítimo, y copiarlas en un sistema RAG para responder probablemente no lo es.
- Para Wikipedia pide que el RAG dé crédito a los autores como exige su licencia CC BY-SA 4.0. El juez todavía tiene que decidir si admite el escrito.
Wikimedia pide la palabra en el pleito del NYT
La Wikimedia Foundation ha presentado ante el tribunal federal del Distrito Sur de Nueva York un escrito como amicus curiae en In re: OpenAI, Inc. Copyright Infringement Litigation, el caso que reúne doce demandas contra OpenAI. La más conocida es la de The New York Times contra Microsoft y OpenAI, que el diario neoyorquino presentó en 2023.
La fundación es la organización sin ánimo de lucro, con sede en San Francisco, que opera Wikipedia y otros doce proyectos, como Wikidata, Wikimedia Commons o Wiktionary. Está registrada en Estados Unidos como entidad exenta de impuestos 501(c)(3) y se financia sobre todo con donaciones, según explica ella misma. Tiene además un interés propio en lo que pide: con Wikimedia Enterprise, su servicio de pago, vende acceso de alto volumen a los datos de sus proyectos.
El documento entró en el juzgado el 29 de octubre y la fundación lo anunció al día siguiente. Va acompañado de una petición al juez Sidney H. Stein para que lo admita, porque una orden del tribunal del 7 de agosto obliga a quien quiera intervenir así a pedir permiso. El escrito se presenta «en apoyo de ninguna parte» y declara que ni las partes ni sus abogados lo redactaron, y que nadie salvo Wikimedia pagó su preparación.
Tres posturas para dos usos
| Quién | Entrenar el modelo | Copiar para responder (RAG) |
|---|---|---|
| The New York Times | No es uso legítimo | No es uso legítimo |
| OpenAI y Microsoft | Uso legítimo | Uso legítimo |
| Wikimedia Foundation | Probablemente uso legítimo | Probablemente no; con crédito y licencia, menos riesgo de infringir |
El tribunal debe decidir, según la fundación, si usar contenido protegido para desarrollar modelos de IA es uso legítimo. The New York Times sostiene que cualquier uso de sus artículos por parte de OpenAI y Microsoft, también para entrenar, infringe sus derechos; las dos tecnológicas defienden que entrenar y desplegar modelos con datos públicos está amparado.
Wikimedia cree que las dos posturas se pasan de amplias. Su argumento es que el análisis de las herramientas de IA «no debe ser monolítico»: hay que examinar cada uso por separado, como exige, según el escrito, la sentencia del Tribunal Supremo de Estados Unidos de 2023 en el caso Andy Warhol Foundation contra Goldsmith. El texto cita de esa sentencia que «la misma copia puede ser legítima cuando se usa con un fin y no con otro».
Por eso pide al juez que descarte tanto que «todos los usos de OpenAI son legítimos» como que «ningún uso de OpenAI es legítimo».
Entrenar un modelo es hacer algo nuevo
Para Wikimedia, usar obras protegidas para entrenar un modelo de propósito general «probablemente es legítimo» según los cuatro factores. El motivo central es que la copia sirve a otro fin: un artículo de Wikipedia existe para explicar el mundo con neutralidad, y en el entrenamiento solo aporta patrones del idioma. Por eso, según el escrito, ese uso es «probablemente transformador» y no causa por sí mismo un daño de mercado, porque no sustituye a las obras.
La fundación habla desde su experiencia: según el escrito, las herramientas de aprendizaje automático (machine learning) ayudan a sus voluntarios a combatir el vandalismo, detectar infracciones de derechos de autor y datos personales que no deberían estar publicados, y decidir qué artículos necesitan más trabajo. Declarar ilegítimo cualquier desarrollo de estos modelos iría, sostiene, contra los fines de la propia ley de derechos de autor.
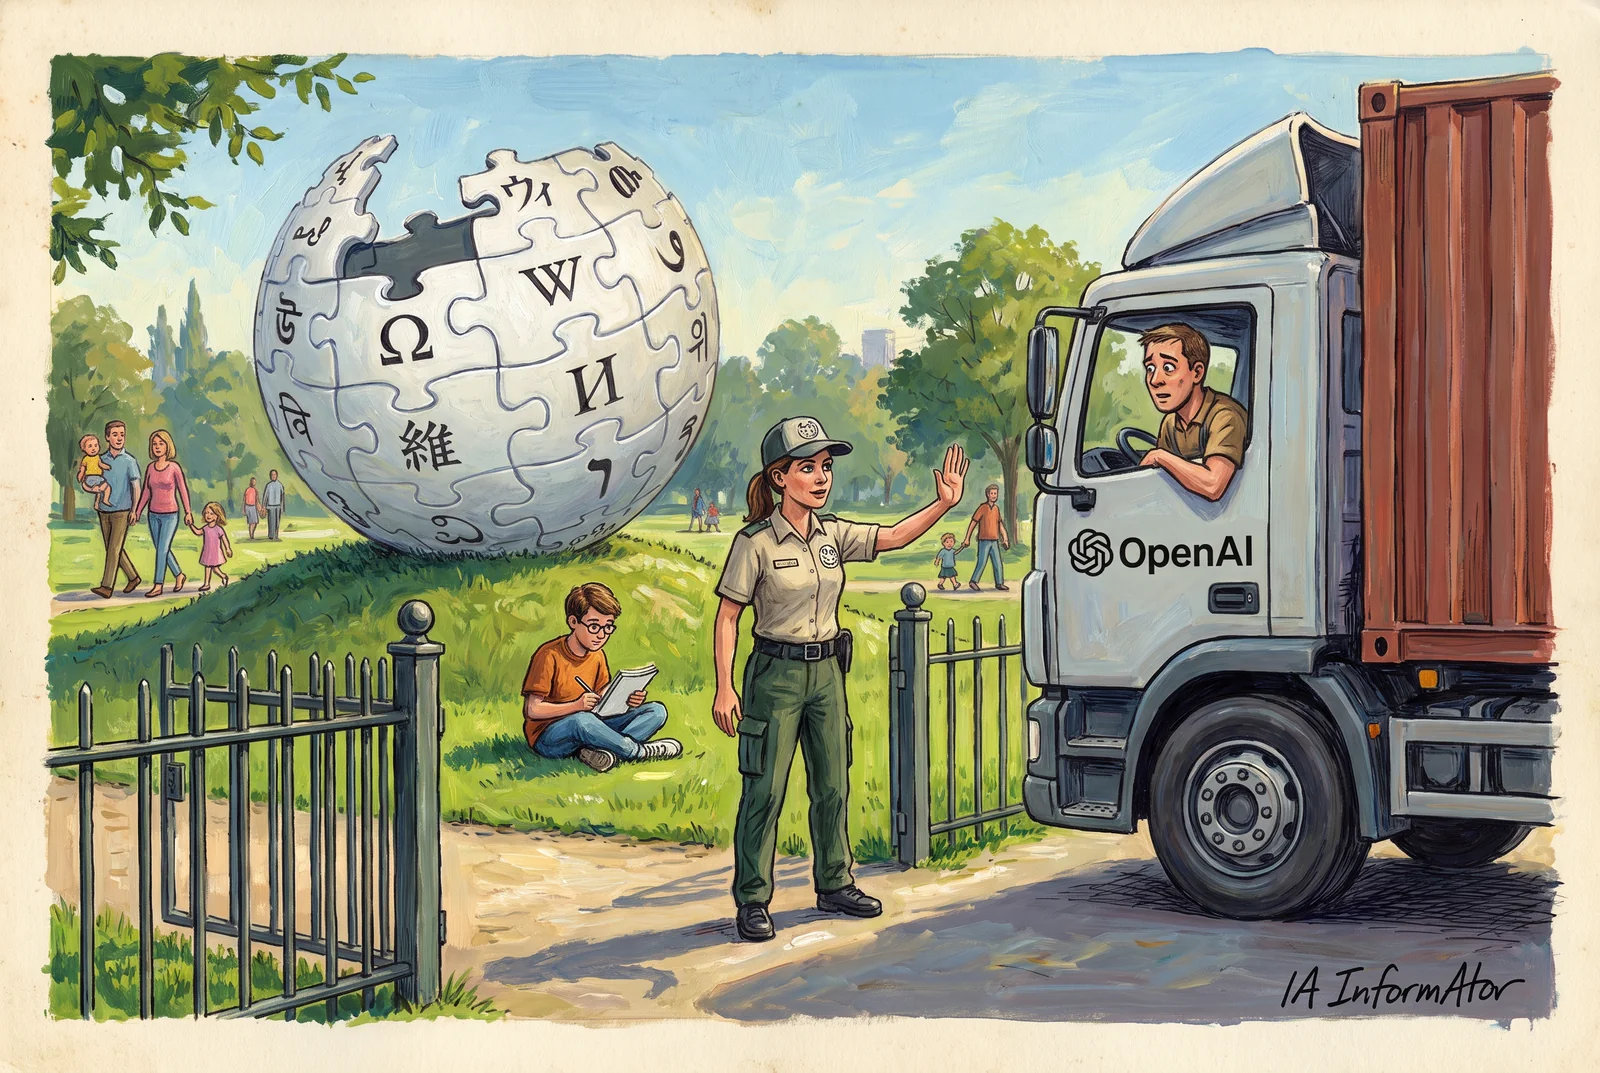
El rastreo automático de webs (scraping), añade, no es en sí un «uso» de la obra, sino la manera de conseguir copias: lo que se juzga es qué se hace después con ellas. Eso no lo vuelve inocuo: algunas formas de rastreo vulneran las condiciones de uso de las webs y pueden chocar con leyes federales como la de derechos de autor digitales (DMCA, Digital Millennium Copyright Act) o la de fraude y abuso informático (CFAA, Computer Fraud and Abuse Act). El escrito lo resume con una imagen: «un parque público puede seguir siendo libre y abierto e impedir a la vez que alguien lo atraviese con un camión de contenedores».
Responder con lo copiado suplanta al original
En este segundo uso es donde la fundación ve el problema. Según el escrito, un chatbot con RAG como ChatGPT copia texto de webs como Wikipedia o The New York Times, pega los pasajes más relevantes junto a la pregunta y a menudo reproduce buena parte del original en su respuesta. Ese uso «sustituye el propósito» de las obras, que es informar a quien busca, y a veces reproduce expresiones protegidas sin citar las fuentes.
El daño, sostiene Wikimedia, va más allá de la copia: cuando las empresas de IA no cumplen las licencias, «encierran a los lectores humanos dentro del chatbot», y quien no visita Wikipedia tampoco la edita ni hace donaciones.
No es una condena del RAG en bloque. El propio escrito reconoce que hay servicios, ChatGPT incluido, que intentan citar y enlazar sus fuentes de forma sistemática, y que cuando lo hacen, y cumplen así la licencia de Wikipedia, esos usos tienen «menos probabilidades de infringir». Tampoco los resúmenes deben tratarse «automáticamente» como ilegítimos, añade: depende de si sirven a otro fin o reemplazan a la obra.
La licencia libre de Wikipedia también pone condiciones
Esa licencia es la clave de lo que la fundación pide para sí. Quiere que el uso sin crédito de lo que aloja se limite al entrenamiento, y que el RAG y las técnicas de anclaje parecidas den la atribución que exige la CC BY-SA 4.0. Y, sea cual sea el uso, pide que el rastreo de sus proyectos respete los límites de su API pública o pase por la oferta de Wikimedia Enterprise.
Lo justifica con su escala. Wikipedia reúne más de 67 millones de artículos en 300 idiomas y la mejoran cada mes cerca de 250.000 voluntarios, según la fundación (más de 260.000, según su escrito ante el juez). El tráfico no humano de los rastreadores, explica el escrito, carga sus servidores y la ha obligado a poner salvaguardas técnicas y a dirigir a los grandes usuarios hacia su servicio de pago.
«Ampliar el acceso al conocimiento mediante la IA es un objetivo poderoso, pero debe respetar a las personas, los colaboradores y las comunidades que hacen posible un conocimiento fiable», dijo la consejera delegada de la fundación, Bernadette Meehan. Su asesor jurídico general, Stephen LaPorte, añadió que cualquier debate sobre el uso legítimo y los derechos de autor en la era de la IA «no puede limitarse a las organizaciones con ánimo de lucro».
Conclusión
El juez Stein tiene que resolver primero si admite el escrito y, después, cómo se aplica el uso legítimo a la IA, sin fecha conocida para ninguna de las dos cosas. La fundación cree que la sentencia influirá mucho en otros tribunales. Si el juez siguiera su criterio, entrenar quedaría amparado y la cuenta llegaría en el momento de responder: el chatbot que copie para contestar tendría que cumplir la licencia de cada fuente.
Fuentes primarias
- Wikimedia Foundation — The Wikimedia Foundation files to protect open knowledge in New York Times v OpenAI case (30-10-2026) ↗
- Wikimedia Foundation — Motion for Leave to File Amicus Curiae Brief and [Proposed] Amicus Curiae Brief, In re: OpenAI, Inc. Copyright Infringement Litigation (S.D.N.Y., 29-10-2026) ↗
- Diff — Why Wikimedia Is Speaking Up in a Major AI Copyright Case (30-10-2026) ↗
- Wikimedia Foundation — Who we are (consulta 31-10-2026) ↗
- AI Informator — Wikimedia pilla a los agentes de OpenAI en sus wikis (06-10-2026) ↗
- AI Informator — The Seattle Times y Newsday demandan a OpenAI y Microsoft por usar sus noticias para entrenar la IA (05-09-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios