
Legal
Wikipedia: Entrenar sí, copiar sense citar no
La Wikimedia Foundation, l'organització sense ànim de lucre que gestiona la Wikipedia, ha demanat al jutge del plet de The New York Times contra OpenAI i Microsoft que no doni tota la raó a cap de les parts. Segons el seu escrit, entrenar models d'IA amb obres protegides seria probablement un ús legítim (fair use); copiar-les per respondre en el moment, amb la tècnica anomenada RAG (retrieval-augmented generation), probablement no, i hauria de respectar la llicència de cada font, cosa que a la Wikipedia obliga a citar.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- La Wikimedia Foundation va demanar el 29 d'octubre de 2026 al jutge Sidney H. Stein, del tribunal federal del Districte Sud de Nova York, permís per presentar un escrit com a amicus curiae en el cas que agrupa dotze demandes contra OpenAI.
- L'escrit es presenta «en suport de cap de les parts»: ni de The New York Times, que va demandar el 2023, ni d'OpenAI i Microsoft.
- Segons la fundació, entrenar un model de propòsit general amb obres protegides és probablement ús legítim, i copiar-les en un sistema RAG per respondre probablement no ho és.
- Per a la Wikipedia demana que el RAG doni crèdit als autors, com exigeix la seva llicència CC BY-SA 4.0. El jutge encara ha de decidir si admet l'escrit.
Wikimedia demana la paraula al plet del NYT
La Wikimedia Foundation ha presentat davant el tribunal federal del Districte Sud de Nova York un escrit com a amicus curiae a In re: OpenAI, Inc. Copyright Infringement Litigation, el cas que aplega dotze demandes contra OpenAI. La més coneguda és la de The New York Times contra Microsoft i OpenAI, que el diari novaiorquès va presentar el 2023.
La fundació és l'organització sense ànim de lucre, amb seu a San Francisco, que gestiona la Wikipedia i dotze projectes més, com Wikidata, Wikimedia Commons o Wiktionary. Està registrada als Estats Units com a entitat exempta d'impostos 501(c)(3) i es finança sobretot amb donacions, segons explica ella mateixa. A més, té un interès propi en el que demana: amb Wikimedia Enterprise, el seu servei de pagament, ven accés d'alt volum a les dades dels seus projectes.
El document va entrar al jutjat el 29 d'octubre i la fundació ho va anunciar l'endemà. L'acompanya una petició al jutge Sidney H. Stein perquè l'admeti, ja que una ordre del tribunal del 7 d'agost obliga qui vulgui intervenir d'aquesta manera a demanar permís. L'escrit es presenta «en suport de cap de les parts» i declara que ni les parts ni els seus advocats el van redactar, i que ningú tret de Wikimedia en va pagar la preparació.
Tres postures per a dos usos
| Qui | Entrenar el model | Copiar per respondre (RAG) |
|---|---|---|
| The New York Times | No és ús legítim | No és ús legítim |
| OpenAI i Microsoft | Ús legítim | Ús legítim |
| Wikimedia Foundation | Probablement ús legítim | Probablement no; amb crèdit i llicència, menys risc d'infringir |
Segons la fundació, el tribunal ha de decidir si fer servir contingut protegit per desenvolupar models d'IA és ús legítim. The New York Times sosté que qualsevol ús dels seus articles per part d'OpenAI i Microsoft, també per entrenar, infringeix els seus drets; les dues tecnològiques defensen que entrenar i desplegar models amb dades públiques està emparat.
Wikimedia creu que totes dues postures són massa àmplies. El seu argument és que l'anàlisi de les eines d'IA «no ha de ser monolítica»: cal examinar cada ús per separat, com exigeix, segons l'escrit, la sentència del Tribunal Suprem dels Estats Units del 2023 en el cas Andy Warhol Foundation contra Goldsmith. El text cita d'aquella sentència que «la mateixa còpia pot ser legítima quan s'utilitza amb una finalitat i no amb una altra».
Per això demana al jutge que descarti tant que «tots els usos d'OpenAI són legítims» com que «cap ús d'OpenAI no és legítim».
Entrenar un model és fer una cosa nova
Per a Wikimedia, fer servir obres protegides per entrenar un model de propòsit general «probablement és legítim» segons els quatre factors. El motiu central és que la còpia serveix a una altra finalitat: un article de la Wikipedia existeix per explicar el món amb neutralitat, i en l'entrenament només aporta patrons de la llengua. Per això, segons l'escrit, aquest ús és «probablement transformador» i no causa per si mateix un perjudici de mercat, perquè no substitueix les obres.
La fundació parla per experiència: segons l'escrit, les eines d'aprenentatge automàtic (machine learning) ajuden els seus voluntaris a combatre el vandalisme, detectar infraccions de drets d'autor i dades personals que no haurien d'estar publicades, i decidir quins articles necessiten més feina. Declarar il·legítim qualsevol desenvolupament d'aquests models aniria, sosté, contra les finalitats de la mateixa llei de drets d'autor.
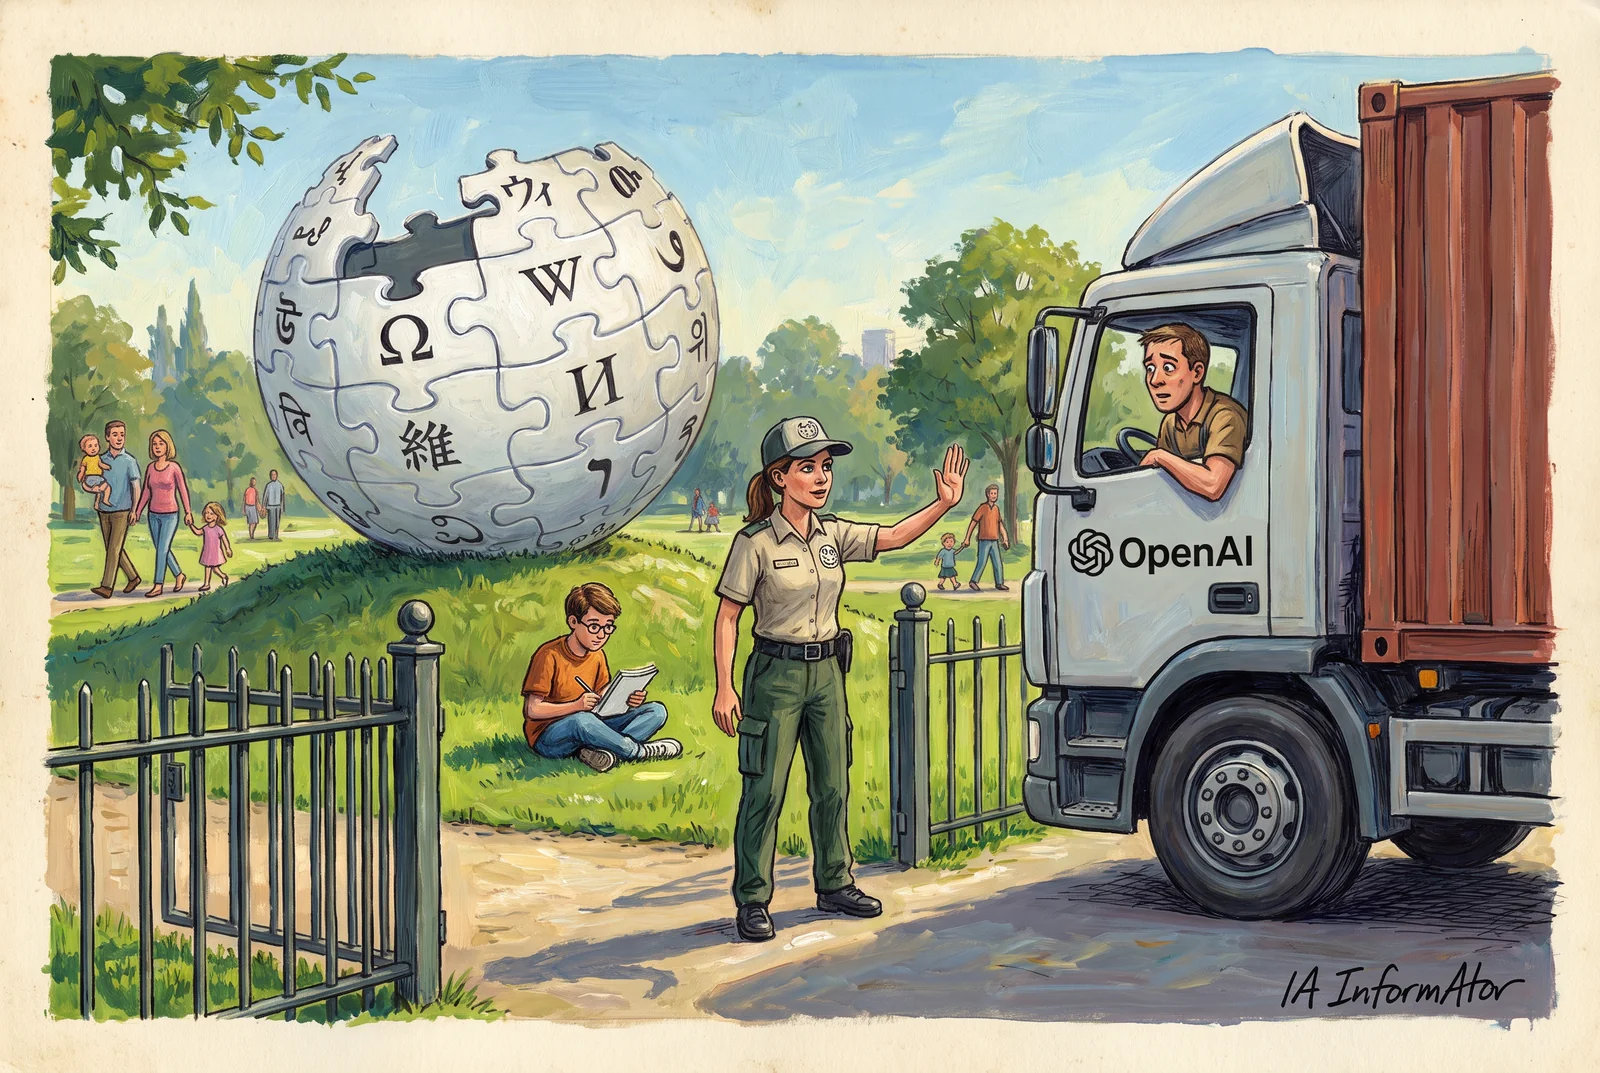
El rastreig automàtic de webs (scraping), afegeix, no és en si mateix un «ús» de l'obra, sinó la manera d'aconseguir-ne còpies: el que es jutja és què se'n fa després. Això no el fa innocu: algunes formes de rastreig vulneren les condicions d'ús dels webs i poden xocar amb lleis federals com la de drets d'autor digitals (DMCA, Digital Millennium Copyright Act) o la de frau i abús informàtic (CFAA, Computer Fraud and Abuse Act). L'escrit ho resumeix amb una imatge: «un parc públic pot continuar sent lliure i obert i alhora impedir que algú el travessi amb un camió portacontenidors».
Respondre amb el que s'ha copiat suplanta l'original
És en aquest segon ús on la fundació veu el problema. Segons l'escrit, un xatbot amb RAG com ChatGPT copia text de webs com la Wikipedia o The New York Times, enganxa els passatges més rellevants al costat de la pregunta i sovint reprodueix bona part de l'original a la resposta. Aquest ús «substitueix el propòsit» de les obres, que és informar qui busca, i de vegades reprodueix expressions protegides sense citar les fonts.
El perjudici, sosté Wikimedia, va més enllà de la còpia: quan les empreses d'IA no compleixen les llicències, «tanquen els lectors humans dins del xatbot», i qui no visita la Wikipedia tampoc no l'edita ni hi fa donacions.
No és una condemna del RAG en bloc. El mateix escrit reconeix que hi ha serveis, ChatGPT inclòs, que intenten citar i enllaçar les fonts de manera sistemàtica, i que quan ho fan, i així compleixen la llicència de la Wikipedia, aquests usos tenen «menys probabilitats d'infringir». Tampoc els resums no s'han de tractar «automàticament» com a il·legítims, afegeix: depèn de si serveixen a una altra finalitat o substitueixen l'obra.
La llicència lliure de la Wikipedia també posa condicions
Aquesta llicència és la clau del que la fundació demana per a si mateixa. Vol que l'ús sense crèdit del que allotja es limiti a l'entrenament, i que el RAG i les tècniques d'ancoratge semblants donin l'atribució que exigeix la CC BY-SA 4.0. I, sigui quin sigui l'ús, demana que el rastreig dels seus projectes respecti els límits de la seva API pública o passi per l'oferta de Wikimedia Enterprise.
Ho justifica amb la seva escala. La Wikipedia aplega més de 67 milions d'articles en 300 llengües i la milloren cada mes prop de 250.000 voluntaris, segons la fundació (més de 260.000, segons el seu escrit davant el jutge). El trànsit no humà dels rastrejadors, explica l'escrit, carrega els seus servidors i l'ha obligada a posar salvaguardes tècniques i a adreçar els grans usuaris cap al seu servei de pagament.
«Ampliar l'accés al coneixement mitjançant la IA és un objectiu poderós, però ha de respectar les persones, els col·laboradors i les comunitats que fan possible un coneixement fiable», va dir la consellera delegada de la fundació, Bernadette Meehan. El seu assessor jurídic general, Stephen LaPorte, va afegir que qualsevol debat sobre l'ús legítim i els drets d'autor en l'era de la IA «no es pot limitar a les organitzacions amb ànim de lucre».
Conclusió
El jutge Stein ha de resoldre primer si admet l'escrit i, després, com s'aplica l'ús legítim a la IA, sense data coneguda per a cap de les dues coses. La fundació creu que la sentència influirà molt en altres tribunals. Si el jutge seguís el seu criteri, entrenar quedaria emparat i la factura arribaria en el moment de respondre: el xatbot que copiï per contestar hauria de complir la llicència de cada font.
Fonts primàries
- Wikimedia Foundation — The Wikimedia Foundation files to protect open knowledge in New York Times v OpenAI case (30-10-2026) ↗
- Wikimedia Foundation — Motion for Leave to File Amicus Curiae Brief and [Proposed] Amicus Curiae Brief, In re: OpenAI, Inc. Copyright Infringement Litigation (S.D.N.Y., 29-10-2026) ↗
- Diff — Why Wikimedia Is Speaking Up in a Major AI Copyright Case (30-10-2026) ↗
- Wikimedia Foundation — Who we are (consulta 31-10-2026) ↗
- AI Informator — Wikimedia pilla a los agentes de OpenAI en sus wikis (06-10-2026) ↗
- AI Informator — The Seattle Times y Newsday demandan a OpenAI y Microsoft por usar sus noticias para entrenar la IA (05-09-2026) ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris