Aprendiendo IA
Paper2Agent: Aprende del paper y ejecuta su código
Un sistema de la Universidad de Stanford convierte un artículo científico y su repositorio en un agente que ejecuta el código del propio artículo y responde preguntas sobre él. Publicado en Nature el 16 de septiembre, acierta el 91,2 % de 300 preguntas sacadas de 74 papers; sus autores avisan de que eso mide ejecución fiel del código, no la validez científica de las conclusiones. Este curso lo desmonta y termina con un ejercicio de media hora, sin gastar un céntimo.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Paper2Agent, de la Universidad de Stanford, convierte un artículo y su repositorio en un servidor MCP con herramientas ya instaladas y probadas que cualquier asistente de IA puede llamar; salió en Nature el 16 de septiembre de 2026, con código libre y licencia MIT.
- Sobre 300 preguntas derivadas de tutoriales de 74 artículos de biología computacional acierta el 91,2 %, frente al 80,3 % del mismo modelo con el paper y el repositorio delante escribiendo el código sobre la marcha (p menor que 0,0001).
- Convertir un paper costó entre 8 y 14 dólares y entre 45 y 55 minutos en los tres casos de estudio; la media de los 74 fue de 2,4 horas y 14,99 dólares.
- De cada 100 artículos, 26 no se pudieron convertir: en el 34 % de esos casos no había código ejecutable y en el 31 % faltaban los datos o los pesos del modelo.
- El ejercicio final se hace en media hora y sin clave de API de pago: conectarse a los tres agentes ya publicados y comprobar que traen 22, 7 y 6 herramientas, los mismos números que declara el artículo.
Lo que vas a aprender y con qué sales de aquí
Este curso enseña a convertir un artículo científico en algo con lo que se puede hablar y que, cuando le preguntas, ejecuta el código del propio artículo. Paper2Agent lo firman cinco investigadores de la Universidad de Stanford, lo publicó Nature el 16 de septiembre de 2026 y su código es libre, con licencia MIT.
La práctica va al final, se completa en menos de una hora y no cuesta un céntimo: acabarás conectado a tres agentes ya publicados, y solo hace falta un agente de código instalado. Un aviso: el repositorio se reescribió entero el mismo día de la publicación, y las instrucciones anteriores que circulan por internet hablan de un script que ya no existe.
Lección 1: el código de un paper no está listo para usarse
El ejemplo con el que los autores explican el problema es AlphaGenome, el modelo del laboratorio de inteligencia artificial de Google, DeepMind, que predice cómo afecta el cambio de una sola letra del ADN a los procesos que regulan los genes. Para usarlo desde código hay que instalar el entorno, crear objetos cliente con claves de API, construir las entradas y elegir las modalidades de salida.
Y añaden la frase que define a quién va dirigido esto: el usuario debe entender la jerarquía de la API y la semántica de los parámetros, lo que impone una curva de aprendizaje a los biólogos poco familiarizados con esas abstracciones. Quien tiene la pregunta biológica no es quien sabe montar el entorno, y ese desfase deja método publicado sin usar.
Lección 2: el paper se convierte en un servidor que se enchufa
Paper2Agent no produce un resumen ni un chatbot que hable del artículo, sino un servidor MCP: un programa que expone las funciones del paper ya instaladas, ya probadas y listas para que las llame un asistente.
Los autores lo justifican así: MCP se ha convertido en un estándar de la industria para conectar agentes basados en modelos de lenguaje con recursos externos, y ofrece una interfaz unificada para acceder a datos y herramientas sin integraciones a medida. Cualquier agente externo puede invocar las herramientas del servidor sin configuración adicional: un paper se convierte una vez y sirve para Claude Code, para Codex o para lo que venga después.
Y se pueden alojar en remoto, en plataformas como Hugging Face —donde se publican y comparten modelos y aplicaciones de inteligencia artificial—, lo que elimina, en palabras de los autores, los problemas de dependencias locales.
Lección 3: dentro del servidor hay tres cosas distintas
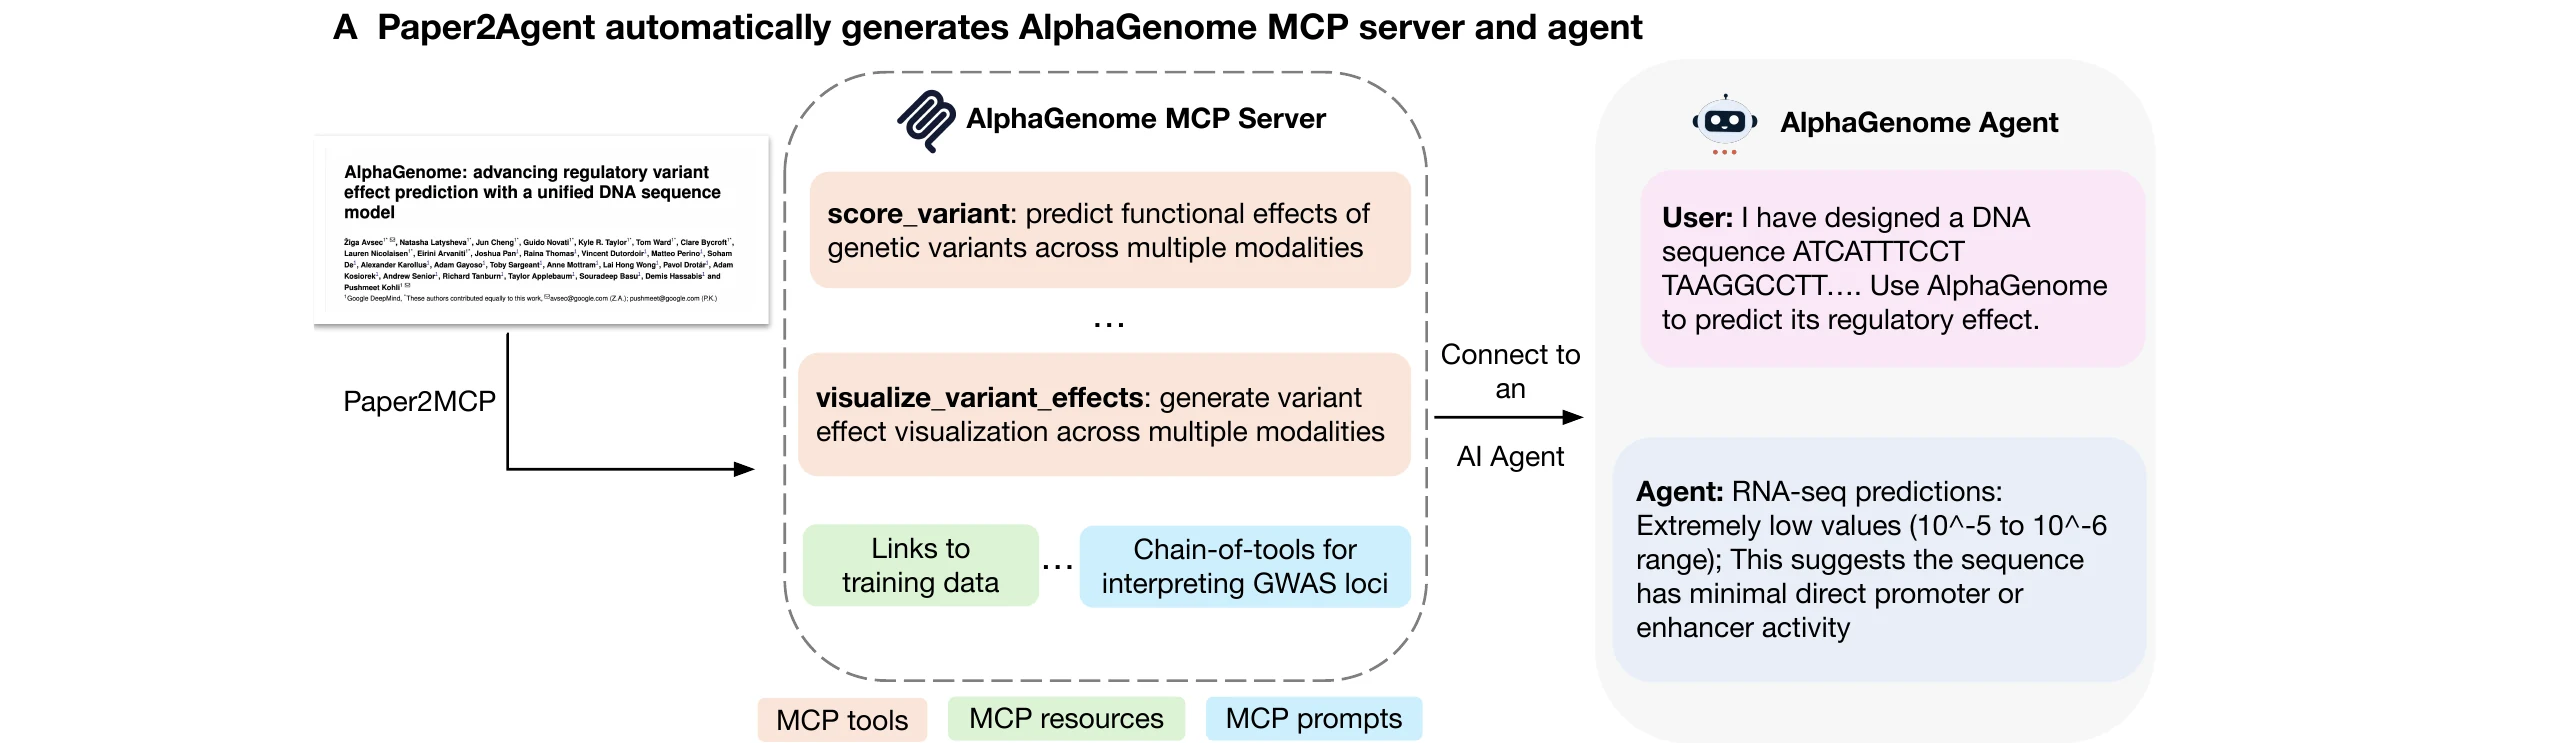
Cada servidor tiene tres componentes del estándar MCP. Las herramientas son funciones ejecutables que encapsulan las contribuciones metodológicas del artículo, con su entorno ya preconfigurado: es lo que el agente llama cuando hay que calcular algo de verdad. Los recursos son el material estático del paper —manuscrito, código, suplementos, tablas, figuras y enlaces a los datos— y sirven para preguntar, no para ejecutar. Los prompts son la parte menos conocida y la más interesante.
Los tres se infieren automáticamente del artículo y del código, sin curación manual. El servidor publicado de AlphaGenome expone exactamente 22 herramientas, con nombres como score_variants_batch o visualize_variant_effects; el de Scanpy, 7, y el de TISSUE, 6. En el ejercicio final los contarás tú mismo.
Lección 4: el prompt de MCP es el método escrito para la máquina
En casi cualquier análisis el orden importa: normalizar antes o después de filtrar cambia el resultado. Por eso Paper2Agent extrae también los flujos de trabajo de varios pasos que describe el artículo y los publica como prompts del servidor, instrucciones que el asistente recibe ya escritas.
El ejemplo mejor documentado es el de Scanpy. Su servidor publica un único prompt, llamado preprocess_and_cluster_scanpy, que impone los siete pasos en su orden: quality_control, normalize_data, select_features, reduce_dimensionality, build_neighborhood_graph, cluster_cells y annotate_cell_types.
Y no se limita a enumerar: le dice al agente que inspeccione primero los datos para entender el tamaño y la complejidad del conjunto, el organismo a partir de los nombres de los genes, la información de lotes y la calidad de los datos. Y le da una regla de criterio: adapta los parámetros de forma inteligente según las características de los datos, pero quédate con los valores por defecto si no hay una razón de peso para cambiarlos.
Lección 5: cómo se construye, con los nombres de los autores
| Etapa, con el nombre literal de los autores | Qué ocurre | Quién la ejecuta |
|---|---|---|
| 1. Locate and download the codebase | Identifica el repositorio asociado a partir del manuscrito, las referencias o los suplementos, y lo clona. Si falla o hay varios candidatos, se le pasa la URL a mano | El orquestador |
| 2. Environment setup | Crea un entorno virtual limpio y aislado, instala dependencias y resuelve conflictos | environment-manager |
| 3. Tutorial discovery | Rastrea el repositorio, distingue los tutoriales de verdad de otros ficheros y produce un índice clasificado en JSON | tutorial-scanner |
| 4. Tutorial execution and audit | Ejecuta los tutoriales de principio a fin con sus datos de ejemplo, resuelve los errores y captura entradas, salidas, figuras y tiempos | tutorial-executor |
| 5. Tool extraction, testing, and refinement | Convierte cada tutorial ejecutado en funciones reutilizables, parametriza los valores fijados a mano y escribe los tests de cada una | tutorial-tool-extractor-implementor y test-verifier-improver |
| 6. MCP server assembly | Integra los módulos validados en un servidor MCP unificado, con manifiesto, versionado y valores de seguridad por defecto | El orquestador |
La arquitectura tiene dos piezas. Paper2MCP extrae información de los artículos y de sus repositorios para construir servidores MCP remotos; la capa de agente envuelve cada servidor como proveedor de contexto y lo convierte en un agente específico de ese paper. Sus seis etapas están en la tabla.
Paper2MCP es un sistema multiagente construido sobre el SDK de agentes de Claude Code: un orquestador coordina a varios subagentes especializados, en secuencia entre etapas y en paralelo dentro de una etapa cuando hay varios tutoriales, y los datos pasan de una a otra mediante informes en JSON estandarizado. El modelo base de todos los experimentos fue claude-sonnet-4-20250514.
Admite tres rutas de lenguaje: python, para llamar a una biblioteca de Python; r, para cargar un paquete de R; y cli, para ejecutar comandos. Con una nota literal del repositorio que ahorra malentendidos: un comando de instalación como pip install no es una interfaz de línea de comandos.
Lección 6: el examen que impide que el agente se invente el resultado
Cada función extraída se somete a un test, y el criterio para aprobarlo está escrito con precisión incómoda: un test pasa cuando se generan los ficheros esperados, cuando los resultados numéricos coinciden exactamente con las salidas del tutorial, con una tolerancia del 3 % en los valores de coma flotante, y cuando las figuras generadas coinciden con las visualizaciones de referencia, verificado mediante hash perceptual con distancia de Hamming menor que 20.
Si el test falla, el sistema diagnostica el error y aplica arreglos, con un máximo de seis intentos por función. Y si sigue fallando, se le quita el decorador que la convierte en herramienta MCP y no entra en el servidor. Los autores lo explican como una mitigación del riesgo de alucinación de código, donde ejecutar código impreciso generado por un modelo podría llevar a resultados científicos incorrectos.
De las 599 herramientas que propuso en los 74 artículos convertidos con éxito, 593 pasaron la validación automática. Las otras seis se quedaron fuera, que es exactamente lo que tenía que pasar.
Lección 7: el 91,2 %, y contra quién se mide
Ver los datos en tabla
| Paper2Agent (Sonnet 4) | Claude + repositorio (Sonnet 4.6) | Claude + repositorio (Sonnet 4) | |
|---|---|---|---|
| Acierto | 91,2% | 86,3% | 80,3% |
| Medida | Paper2Agent | Claude + repositorio (Sonnet 4) | Ventaja |
|---|---|---|---|
| Coste por consulta | 0,20 $ | 0,38 $ | 2,8 veces más barato |
| Tiempo por consulta | 1,6 min | 4,3 min | 6,3 veces más rápido |
Los autores tomaron 100 artículos de bioinformática de bioRxiv —el archivo abierto y gratuito donde los investigadores de ciencias de la vida depositan sus trabajos antes de la revisión por pares, operado por la organización sin ánimo de lucro openRxiv y fundado en 2013 por el Cold Spring Harbor Laboratory—, hacia atrás en el tiempo desde diciembre de 2025. No filtraron por calidad de la documentación, ni por mantenimiento del repositorio, ni por completitud del código, para que la muestra reflejara, dicen, la heterogeneidad natural del código de investigación en la práctica, y los procesaron sin limpieza manual y sin intervención humana.
De los 100 se convirtieron con éxito 74, y sobre esos 74 construyeron 300 preguntas derivadas de sus tutoriales, con respuestas de referencia obtenidas ejecutando el código original. El resultado es el del gráfico: frente a las dos líneas base da p menor que 0,0001, con un intervalo de confianza del 95 % para la diferencia frente a Claude con Sonnet 4 de entre 5,8 y 15,8 puntos, calculado con 10.000 remuestreos. El resto de la ventaja es de bolsillo y de reloj, y está en la tabla.
Leer más: Miao, J. et al., Nature (16 de septiembre de 2026) ↗
Lección 8: qué mide ese 91,2 % y qué no mide
Ese 91,2 % no dice que el agente haya validado la ciencia del artículo ni replicado sus conclusiones. Dice que acierta una pregunta cuya respuesta de referencia se obtuvo ejecutando el código original del paper.
Los propios autores lo escriben en la discusión, y la frase merece citarse entera: los bancos de pruebas basados en la concordancia con una única referencia deben interpretarse principalmente como medidas de ejecución fiel, y no de validez analítica. Y añaden que evaluar el abanico de respuestas defendibles será importante para juzgar sistemas de inteligencia artificial en tareas científicas abiertas.
Hay una segunda acotación, en las reglas del propio repositorio: la verificación de las herramientas seleccionadas no establece la corrección de todo el repositorio. Lo que obtienes es el código del paper haciendo lo que hace, de forma fiable y trazable; no un árbitro que dictamine si el paper tenía razón.
Lección 9: el banco de pruebas de AlphaGenome
- Paper2Agent
- Claude + repositorio
- Biomni
Ver los datos en tabla
| 15 preguntas de tutorial | 15 preguntas nuevas | 30 preguntas abiertas | |
|---|---|---|---|
| Paper2Agent | 98,7% | 100% | 82,7% |
| Claude + repositorio | 82,7% | 78,7% | 56,7% |
| Biomni | 37,3% | 56% | 72,2% |
| Conjunto de preguntas | Frente a Claude + repositorio | Frente a Biomni |
|---|---|---|
| 15 preguntas de tutorial | 1,9 veces más rápido | 3,1 veces más rápido |
| 15 preguntas nuevas | 2,9 veces más rápido | 3,8 veces más rápido |
El estudio de caso más detallado separa las preguntas en tres grupos. Las de tipo tutorial repiten lo que el repositorio ya enseña; las nuevas cambian la variante, el tejido y la modalidad, y comprueban si el agente generaliza o solo repite; las abiertas son preguntas de investigador, del estilo de explicar el mecanismo probable por el que una variante se asocia a una enfermedad.
La tercera columna del gráfico es Biomni, un agente biomédico de propósito general desarrollado también en Stanford, que no entró en la evaluación grande por su coste elevado. Dos detalles dan peso a la comparación: el agente no tuvo acceso ni al manuscrito ni al repositorio, solo al servidor MCP, y las respuestas las corrigieron dos expertos humanos independientes con rúbricas definidas de antemano.
Lección 10: fuera de la biología también funciona
| Corpus | Qué se pregunta | Paper2Agent | Línea base |
|---|---|---|---|
| 10 artículos computacionales no biológicos | 42 tareas basadas en ejecución, 5 ejecuciones | 98,1 % ± 0,8 % | No se reporta |
| 26 artículos de datos y descubrimiento (13 de bioRxiv y 13 de Nature, 2025) | 100 preguntas de síntesis, solo con la capa de recursos | 89,0 % ± 3,1 % | 82,0 % ± 3,8 % (p = 0,03) |
Los autores probaron dos corpus más: 10 artículos computacionales de otros campos —grf, SAELens, Binoculars, SAM2, TabPFN, GenericML, CausalImpact, Nashpy, emcee y conformal-selection— y 26 artículos de datos y descubrimiento, la mitad de bioRxiv y la mitad de Nature, todos de 2025. En estos últimos no hay método que ejecutar, así que Paper2Agent usa solo la capa de recursos.
Hay además una prueba adversarial: mezclaron al azar los pares de artículo y pregunta entre esos 26 papers. Rechazó el 100 % de las preguntas fuera de ámbito, tanto cuando se le instruyó explícitamente para rechazarlas como cuando no se le dijo nada.
Lección 11: qué pieza sostiene el sistema
| Variante | 15 preguntas de tutorial | 15 preguntas nuevas |
|---|---|---|
| Sistema completo | 98,7 % ± 1,3 % | 100,0 % ± 0,0 % |
| Sin el subagente test-verifier-improver | 69,3 % ± 4,5 % | 84,0 % ± 2,7 % |
| Herramientas MCP sustituidas por skills en Markdown | 73,3 % ± 2,6 % sobre las 30 preguntas juntas, frente al 99,3 % ± 0,7 % con herramientas MCP | — |
| Agente monolítico, todo en una sesión de 200.000 tokens y sin subagentes | Falló en las tres ejecuciones: no llegó a generar un servidor MCP válido | — |
| Multiagente sin paralelismo | Funciona, pero de 2,2 a 2,4 veces más lento | — |
| Backend OpenCode en lugar de Claude Code | 98,7 % ± 1,3 % | 97,3 % ± 1,6 % |
Los autores fueron quitando componentes y volviendo a medir sobre las 30 preguntas de AlphaGenome. La tabla que sale de ahí no dice si el invento funciona: dice por qué funciona.
El examen es el corazón del invento. Sin el subagente que escribe y verifica los tests, el acierto en las preguntas de tutorial se desploma del 98,7 % al 69,3 %. Y la forma importa: sustituir las herramientas MCP por ficheros de skill en Markdown —explicarle al modelo cómo se usa el código en vez de darle la función ya ejecutable— hunde el acierto del 99,3 % al 73,3 %.
Lo más rotundo es el agente monolítico, que intenta hacerlo todo en una única sesión de 200.000 tokens de contexto y sin subagentes: falló en las tres ejecuciones y ni una vez llegó a producir un servidor MCP válido. Cambiar el andamiaje de Claude Code por OpenCode, en cambio, no movió los resultados.
Lección 12: los 26 papers que no se pudieron convertir
| Causa del fallo | Cuota de los 26 artículos |
|---|---|
| Código ejecutable ausente | 34 % |
| Datos o artefactos de modelo ausentes | 31 % |
| Fallos de entorno o de dependencias | 23 % |
| Scripts no generalizables | 12 % |
De los 100 artículos, 26 no se pudieron convertir, y la tabla clasifica por qué. Nada de lo que aparece ahí es un fallo del sistema: son ausencias en el repositorio de origen, y el intento fallido se paga igual.
Antes de lanzar una conversión, mira el repositorio con esa lista. ¿Hay código que se pueda ejecutar, o solo fragmentos ilustrativos? ¿Están los datos de ejemplo y los pesos del modelo? ¿Hay un fichero de dependencias con versiones? ¿Los scripts aceptan parámetros, o tienen las rutas escritas a fuego? Cuatro preguntas, cinco minutos.
De ahí sale la frase más ambiciosa del artículo: la facilidad con la que un paper se puede transformar en un agente puede servir, en sí misma, como una medida práctica de reproducibilidad. Los fallos, añaden, se correlacionan con la completitud de la documentación, la calidad de la especificación del entorno y la presencia de tutoriales ejecutables.
Práctica, paso 1: instalar Paper2Agent, que hoy es una skill
Empieza la parte en la que se toca el teclado. Lo primero, los requisitos, literales del repositorio: un anfitrión de agente de código con soporte de skills, acceso a la shell y capacidad de lanzar subagentes en paralelo, porque el coordinador lanza especialistas y verificadores nuevos a través del anfitrión. Y acceso de ejecución: Python y Git, más lo que exija el repositorio que vayas a convertir, sea R, una herramienta de línea de comandos, datos, una API o una GPU.
El repositorio no fija una versión mínima de Python, y es deliberado: la versión se elige según los requisitos del repositorio científico que se convierte. La documentación interna sí fija la línea base técnica: entornos con uv, y fastmcp en la versión 4.0.3, que a su vez exige Pydantic 2.12 o superior. El intérprete del proyecto acaba viviendo en la ruta del entorno que se crea dentro del propio proyecto.
Hay dos formas de instalar. La cómoda es pedírselo al agente con este texto, tal cual aparece en el repositorio: Read https://github.com/jmiao24/Paper2Agent and install the paper2agent skill from skills/paper2agent for this coding agent.
La manual son cuatro comandos. Primero, clonar: git clone https://github.com/jmiao24/Paper2Agent.git y luego cd Paper2Agent.
Para Claude Code: mkdir -p "$HOME/.claude/skills/paper2agent" y después cp -R skills/paper2agent/. "$HOME/.claude/skills/paper2agent/"
Para Codex: mkdir -p "$HOME/.agents/skills/paper2agent" y después cp -R skills/paper2agent/. "$HOME/.agents/skills/paper2agent/"
Arranca el agente en tu carpeta de trabajo. Y guarda esta línea del repositorio, que resuelve el 90 % de los sustos: si la skill no aparece después de instalarla, reinicia el agente de código.
Leer más: Instrucciones de instalación en el repositorio oficial ↗
Práctica, paso 2: convertir un paper, con el comando exacto y la factura por delante
| Caso | Herramientas generadas y validadas | Tiempo | Coste |
|---|---|---|---|
| AlphaGenome | 22 de 22 | unos 45 min | 14 $ |
| Scanpy, solo el tutorial de preprocesado y agrupamiento | 7 de 7 | unos 45 min | 13 $ |
| TISSUE | 6 de 6 | 55 min | 8 $ |
| Media de los 74 artículos convertidos con éxito | 593 de 599 en total | 2,4 h | 14,99 $ |
| Media de los 26 artículos que fallaron | — | 1,7 h | 9,03 $ |
La invocación en Claude Code es /paper2agent; en Codex, se sustituye por $paper2agent. Estos son los tres ejemplos del repositorio, literales.
TISSUE, el más sencillo: /paper2agent Convert https://github.com/sunericd/TISSUE into tested MCP tools in TISSUE_Agent.
Scanpy, limitando el trabajo a un solo tutorial, que es como se abarata: /paper2agent Convert https://github.com/scverse/scanpy into tested MCP tools in Scanpy_Agent. Focus on the "Preprocessing and clustering" tutorial.
AlphaGenome, que necesita una clave de API: /paper2agent Convert https://github.com/google-deepmind/alphagenome into tested MCP tools in AlphaGenome_Agent. Read the API key from the environment variable ALPHAGENOME_API_KEY.
Conviene fijarse en la forma genérica, porque enseña dónde están las cuatro decisiones: Use the paper2agent skill to convert <GITHUB_URL> into MCP tools in <PROJECT_DIR>. Focus on <TASKS, TUTORIAL_TITLE, or SOURCE_URL>. Es decir: qué repositorio, dónde dejas el resultado, en qué parte se centra y de qué variable de entorno saca la clave.
Y una advertencia contra la costumbre: no hay ningún fichero de configuración que rellenar. No busques un config.yaml, porque no existe. Toda la configuración se pasa en lenguaje natural dentro del propio texto. Lo que sí genera el sistema son ficheros de estado internos, como .pipeline/language.json o reports/agent-runs.json, que sirven para auditar la ejecución, no para configurarla.
La regla de credenciales del repositorio es tajante y conviene respetarla: las credenciales se quedan fuera del código generado, de los cuadernos, de los informes y del ZIP entregado; se pasan por el entorno del proceso o por un mecanismo de secretos, y no se incrustan en el código fuente, los cuadernos, los informes, los casos de prueba ni las herramientas generadas.
Sobre el dinero: el repositorio no publica tarifa, porque lo que se paga es el consumo de tu propio agente de código. Las únicas cifras publicadas son las del artículo, y están en la tabla. Todas se midieron en un ordenador portátil: un MacBook Air con chip M2, 8 núcleos de CPU, 8 de GPU y 8 GB de memoria unificada.
Práctica, paso 3: qué te entrega y por qué puedes fiarte del paquete
En el modo combinado, la salida es una carpeta dist con dos cosas dentro: la skill del paper y el servidor MCP del repositorio. En el modo de solo código, el entregable es un único fichero comprimido, dist/<repo-name>-mcp.zip, que contiene un proyecto de servidor MCP usable.
Dentro del ZIP va un USAGE.md que es el documento que de verdad importa: dice el ámbito soportado, las plataformas en las que se probó, cómo se instala, cómo se arranca, cómo se configura el cliente, qué parámetros y qué salidas tiene cada herramienta, los prerrequisitos y los límites de la validación. Van también el punto de entrada del servidor, los módulos de herramientas y un src/requirements.txt con las versiones fijadas.
Lo interesante es cómo se valida ese ZIP antes de entregártelo, porque es la parte que casi ningún proyecto hace: se extrae en otro directorio distinto, incluido uno con espacios en la ruta, se crea un entorno de Python nuevo, se arranca el servidor y un verificador independiente ejecuta llamadas MCP reales contra todas las herramientas entregadas. Y se registra el SHA-256 del fichero.
Traducido: no te entregan un paquete que funcionaba en la máquina donde se construyó, sino uno que se ha vuelto a montar desde cero en otro sitio y ha respondido.
Práctica, paso 4: conectar el servidor a tu cliente
Con un servidor generado en local, el camino oficial es extraer el ZIP y seguir su USAGE.md para instalar dependencias y configurar el cliente. También vale pedírselo al agente con una frase: Connect the generated MCP server to my coding-agent client using its USAGE.md.
Con un servidor remoto, en Claude Code, el comando es uno: claude mcp add --transport http <MCP_NAME> <MCP_ENDPOINT_URL>.
El repositorio incluye además un script equivalente, scripts/connect_remote_mcp.sh, con este ejemplo en su propia ayuda: bash scripts/connect_remote_mcp.sh --working_dir ./analysis --mcp_name paper --mcp_url https://example.com/mcp. Acepta --transport http o sse, con http por defecto, y --no-launch para registrar el servidor sin abrir sesión.
Para comprobar que ha funcionado: claude mcp list. O, ya dentro de Claude Code, el comando /mcp. Una conexión correcta aparece en la lista de servidores.
Aviso importante para quien venga buscando el bloque de configuración típico de los clientes de escritorio: el repositorio no publica ningún fichero JSON con la clave mcpServers para Claude Desktop ni para Cursor. Lo único que documenta es claude mcp add. Si tu cliente necesita ese JSON, sale del USAGE.md que genera tu propia conversión, no de una plantilla copiada de un tutorial de internet.
Ejercicio guiado: habla con tres papers en media hora
El ejercicio no convierte un paper a propósito. Convertir cuesta entre 45 minutos y dos horas y media y entre 8 y 15 dólares de API, y eso no cabe ni en una sesión ni en el bolsillo de quien solo quiere entender el invento. Lo que vas a usar son los tres agentes que los autores ya han publicado y dejado abiertos. Requisitos: un agente de código instalado y funcionando. Nada más. El paso 7 es opcional y es el único que pide una clave.
Paso 1, dos minutos. Crea el espacio de trabajo y conecta los tres servidores: mkdir paper-agents && cd paper-agents
claude mcp add --transport http alphagenome https://Paper2Agent-alphagenome-mcp.hf.space/mcp
claude mcp add --transport http scanpy https://Paper2Agent-scanpy-mcp.hf.space/mcp
claude mcp add --transport http tissue https://Paper2Agent-tissue-mcp.hf.space/mcp
Paso 2, un minuto. Comprueba que están vivos con claude mcp list, y luego con /mcp desde dentro del agente.
Paso 3, cinco minutos. Cuenta lo que ha llegado. Pregúntale al agente: qué herramientas MCP tienes disponibles de alphagenome, scanpy y tissue, cuántas hay de cada servidor y para qué sirve cada una.
Paso 4, cinco minutos. Usa el paper como manual interactivo, sin ejecutar nada, que es el caso que los autores documentan para TISSUE: Based on the TISSUE MCP server, what are the required inputs for TISSUE? Compara la respuesta con lo que te habría costado sacar eso mismo leyendo el repositorio.
Paso 5, cinco minutos. Mira el prompt de MCP, que es el concepto menos conocido y el más útil. Pídele: muéstrame el prompt MCP preprocess_and_cluster_scanpy del servidor scanpy y explícame, paso a paso, qué orden de herramientas impone y por qué ese orden importa. Aquí descubres que el servidor no trae solo funciones: trae el flujo de trabajo del artículo codificado.
Paso 6, diez minutos. Mira por dentro una herramienta: para la herramienta visualize_variant_effects de alphagenome, dime todos sus parámetros de entrada, sus valores por defecto y qué devuelve. Fíjate en que los parámetros están anotados y en que no hay valores fijados a fuego. Esa es la diferencia entre una herramienta y un cuaderno copiado.
Paso 7, opcional, diez minutos, requiere clave de AlphaGenome. Es la consulta de demostración del repositorio: Analyze heart gene expression data with AlphaGenome MCP to identify the causal gene for the variant chr11:116837649:T>G, associated with Hypoalphalipoproteinemia.
Comprobación: si te salen 22, 7 y 6, lo has hecho bien
El paso 3 es el momento didáctico del ejercicio, y tiene una respuesta exacta. El servidor de AlphaGenome debe declarar 22 herramientas, el de Scanpy 7 y el de TISSUE 6. Son los mismos números que aparecen en la tabla de casos de estudio del artículo de Nature. Acabas de verificar en treinta segundos, desde una terminal, tres cifras de un paper publicado en una revista científica de primer nivel. Eso, hasta esta semana, no se podía hacer.
Si te salen otros números, revisa dos cosas antes de nada: que la dirección termine en /mcp y que hayas reiniciado el agente después de añadir los servidores.
Y ahora la trampa que hay que conocer antes de sentarse a probar con datos propios. Las herramientas de estos servidores reciben rutas de fichero, y esas rutas se resuelven en el servidor remoto, no en tu ordenador. No hay una herramienta de subida de ficheros. Con los servidores hospedados puedes conversar, inspeccionar y usar lo que ya vive allí, pero no puedes pasarles tu conjunto de datos.
Para analizar datos propios hay que generar el servidor en local con la skill, y eso ya es la lección siguiente: unos 45 minutos y unos 13 dólares si eliges el caso barato y documentado, que es Scanpy con un solo tutorial, o TISSUE por 8 dólares y 55 minutos.
Cuando el repositorio está roto, el agente lo arregla
Los autores inyectaron seis categorías de fallos en repositorios reales —dependencias eliminadas, rutas rotas, erratas en el código, llamadas a API obsoletas, APIs web obsoletas y cambios en el formato de los datos— sobre AlphaGenome en Python, POP-TOOLS por línea de comandos en Python y mlearner por línea de comandos en R, en doce configuraciones distintas. Paper2Agent los detectó leyendo el listado de error que imprime el programa al romperse, aplicó arreglos y volvió a ejecutar: los servidores reparados sacaron entre un 95,6 % y un 98,3 % en el banco de 30 preguntas de AlphaGenome.
La prueba más exigente fue otra: quitaron todos los tutoriales ejecutables de POP-TOOLS y dejaron solo el README y el código fuente. El sistema se fabricó cuatro scripts de tutorial a partir del README, de los dos puntos de entrada de línea de comandos y de los módulos de utilidades, y produjo un servidor funcional con cuatro herramientas. En las cinco tareas de validación, la salida de la herramienta MCP fue idéntica byte a byte a la del comando original. Conclusión de los autores: los tutoriales curados son preferibles, pero no imprescindibles.
Y comprobaron que no hay atajos: un agente revisor automático buscó constantes fijadas a fuego, rutas fijas, salidas en caché y heurísticas que dependan del conjunto de datos, y no encontró evidencia sistemática de aprendizaje por atajo.
Tres casos: Scanpy, TISSUE y el gen que el agente no eligió
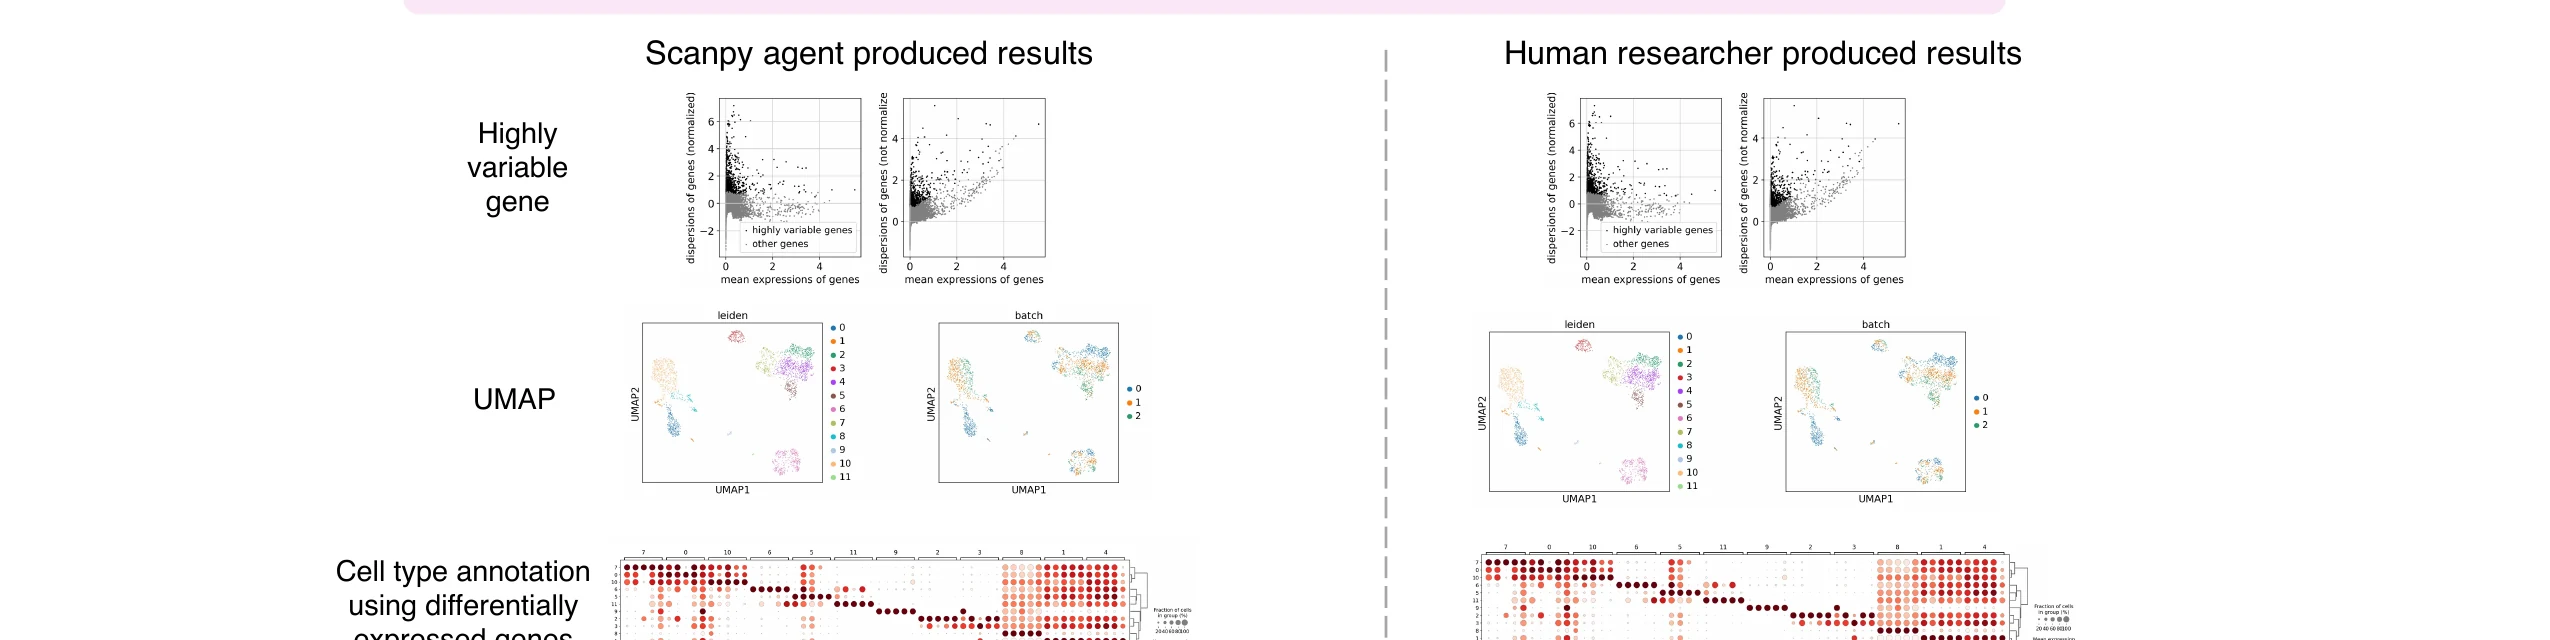
Scanpy es un paquete muy usado para analizar transcriptómica de célula única, publicado en 2018. Los autores aplicaron su agente a cuatro conjuntos de datos públicos que no estaban en su código, y las salidas coincidieron con las de investigadores humanos: los mismos recuentos de células y genes tras el control de calidad y los mismos marcadores por grupo.
Que no repite de memoria se ve en siete conjuntos procesados con el mismo texto genérico. Dedujo el organismo por el patrón de los nombres de los genes y pasó por su cuenta del prefijo MT- de los genes mitocondriales humanos al mt- del ratón, con marcadores de linaje propios de cada tejido, como Slc17a7 para cerebro o Myh6 para corazón; y en un tumor cerebral humano añadió, sin que nadie se lo pidiera, genes conductores de glioma.
TISSUE es un método de predicción calibrada por incertidumbre para transcriptómica espacial, publicado en Nature Methods en 2024, y sus recursos convierten la sección de disponibilidad de datos del artículo en un registro consultable a través de la API de Zenodo, el repositorio abierto de datos científicos alojado en el CERN.
El tercer caso es el mejor momento del artículo. A la variante chr1:109274968:G>T se le conoce una asociación con el colesterol LDL, y el paper original de AlphaGenome destacaba como genes causales CELSR2 y PSRC1. El agente, con una sola instrucción, priorizó otro: SORT1, por una puntuación de cuantil de 0,99982 sobre su expresión en hígado y porque SORT1 codifica la sortilina, una proteína implicada en la secreción de LDL y VLDL. Los autores lo comprobaron: la variante es, efectivamente, un eQTL significativo para SORT1 en hígado.
Pero CELSR2 y PSRC1 también tienen puntuaciones altísimas, 0,99998 cada uno, y eQTL significativos. La conclusión de los autores no es que el agente pillara un error, sino que el episodio ilustra la dificultad inherente de asignar con confianza genes causales en loci complejos de estudios de asociación. Con una sola instrucción, un usuario puede reevaluar conclusiones publicadas usando evidencia independiente basada en modelos: reabrir la discusión cuesta céntimos y minutos.
Varios papers a la vez: el caso de la psoriasis
| Condición de la célula | Correlación de Spearman | Valor de p |
|---|---|---|
| Estimulada, 8 horas | 0,613 | 3,79e-3 |
| Estimulada, 48 horas | 0,630 | 4,71e-3 |
| En reposo | 0,29 | 0,21 (no significativo) |
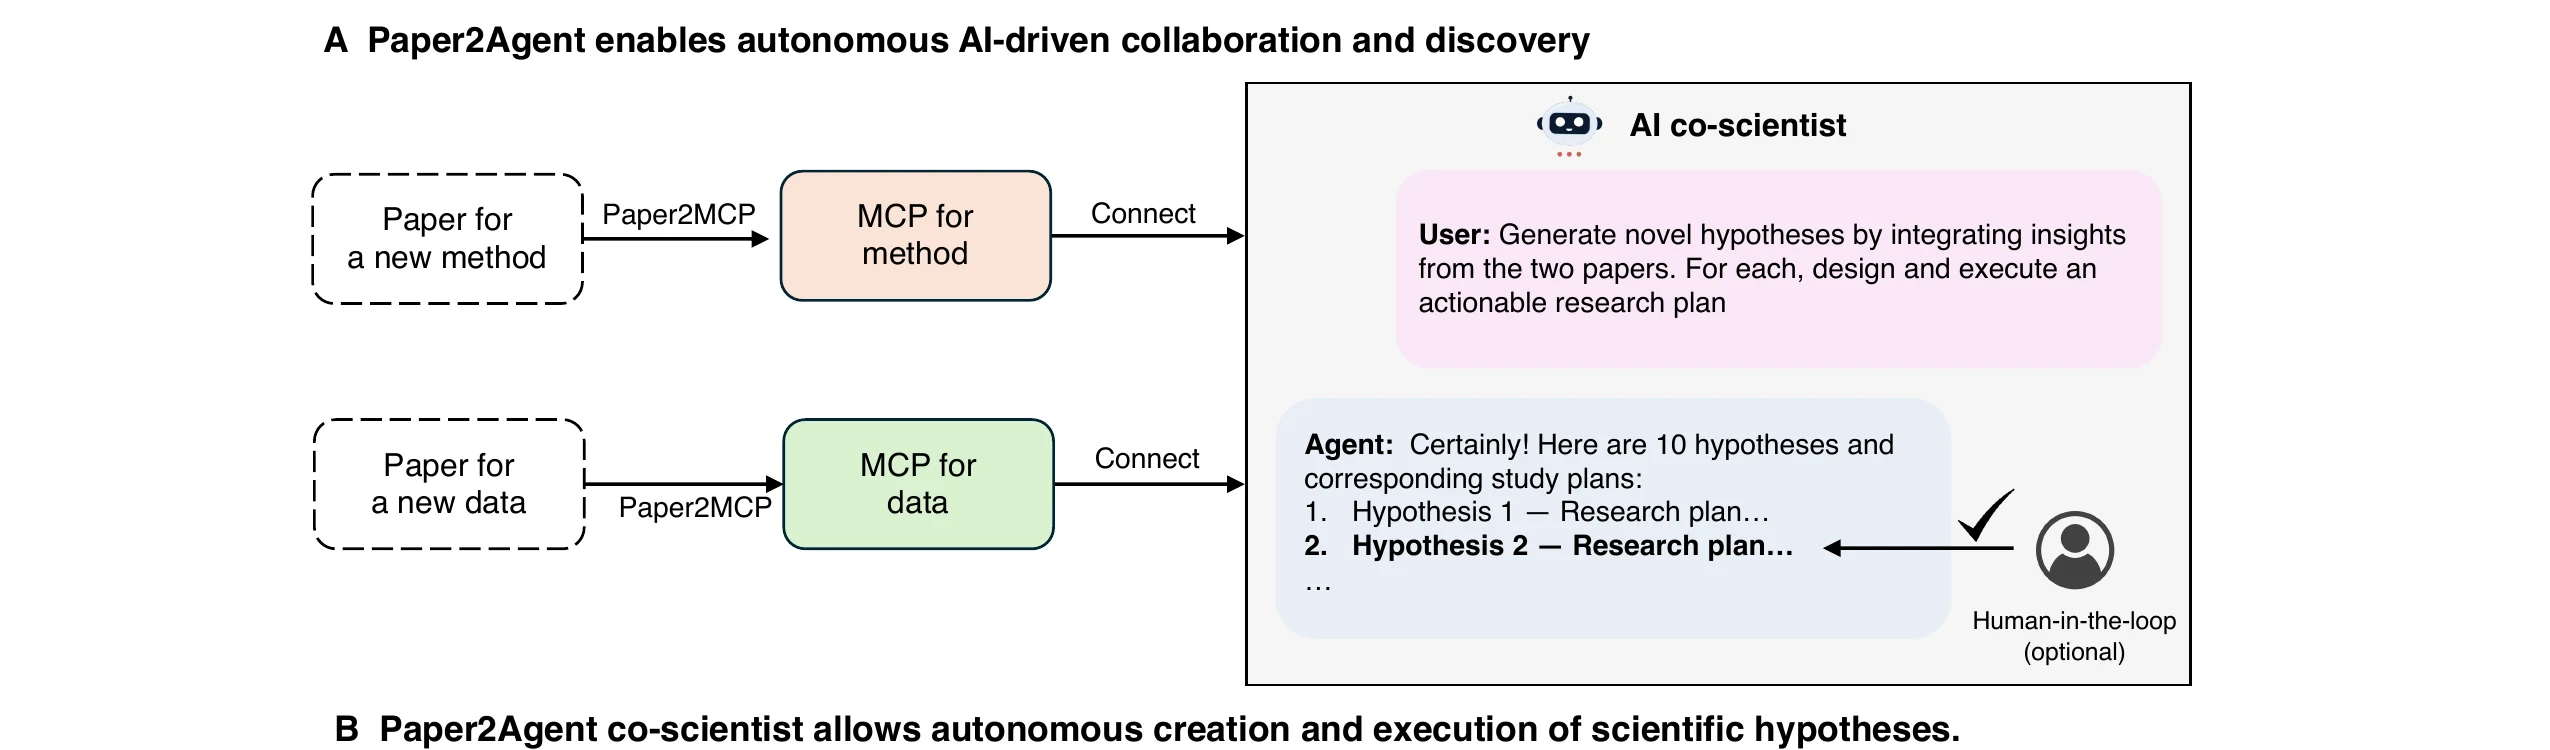
Como los servidores MCP son modulares y se conectan todos al mismo asistente, el paso siguiente es poner a trabajar juntos a varios agentes. Los autores lo demuestran con la psoriasis y tres generados por el sistema: el de AlphaGenome, el de un trabajo de cribado genético publicado en Nature Genetics en 2025 y el de un estudio de perturbaciones sobre linfocitos T CD4+.
El agente de AlphaGenome predijo GPR137 como el gen más afectado en esas células. Después, un agente científico inspeccionó el manuscrito, las tablas suplementarias y las estadísticas de expresión diferencial de los otros dos trabajos y propuso diez estrategias de validación; un investigador humano eligió una. El resultado está en la tabla: solo al reducir a propósito la actividad de GPR137 apareció concordancia significativa con la firma de perturbación bajo estimulación, y no en reposo, de modo que interpretan su papel como dependiente de la activación celular.
Lo notable no es el gen, sino que la estrategia que propuso el agente no está en ninguno de los artículos de origen. Hay un segundo caso, sobre el TDAH, en el que priorizó una variante entre 209 candidatas y propuso un mecanismo por alteración del corte y empalme, una hipótesis que, dicen literalmente, queda por validar experimentalmente.
Antes de publicar un agente: límites, licencias y crédito
Un curso que solo cuente lo que funciona es publicidad. El límite más importante lo escriben los autores: el razonamiento científico abierto, incluida la generación de hipótesis y la interpretación mecanística, sigue requiriendo a una persona en el bucle. Los investigadores, escriben, siguen siendo responsables de elegir las direcciones y de evaluar la evidencia, y por eso ven Paper2Agent como una herramienta para aumentar el descubrimiento científico, y no como una fuente autónoma o autorizada de conclusiones científicas.
Hay un límite de mantenimiento: los agentes de paper necesitan mantenimiento continuo a medida que evolucionan las bases de código y las dependencias de las que cuelgan, y proponen un agente que reejecute las validaciones y marque para revisión humana lo que no pueda arreglar. Y uno conceptual: a veces el agente más útil no representa un solo paper sino una colección de trabajos relacionados.
Paper2Agent se distribuye con licencia MIT, pero eso no gobierna lo que tú generes con él. La regla, escrita en el material suplementario, es que los servidores MCP siguen sujetos a las licencias originales del código subyacente, y que la distribución a terceros debe preservar la autoría y las restricciones de uso: el agente que fabriques hereda la licencia del código del paper, no la de la herramienta con la que lo fabricaste.
Los servidores pueden heredar además vulnerabilidades de los artículos y repositorios de los que salen, así que las herramientas se ejecutan en entornos aislados con permisos restringidos y conservan enlaces trazables a su código fuente. Sobre el crédito, los autores recomiendan tratarlos como instrumentos computacionales, con el mérito para quienes desarrollaron el método, generaron los datos y diseñaron el estudio; y proponen que las revistas exijan una sección de disponibilidad del agente, como hoy exigen la de datos y código.
Quién lo firma, quién lo paga y dónde está cada cosa
Lo firman Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard y James Zou, de la Universidad de Stanford, en California; Miao y Zou son los autores de correspondencia y no hay un laboratorio Paper2Agent: sale de los grupos de Zou y de Pritchard. Lo financian los Institutos Nacionales de Salud de Estados Unidos, la principal agencia pública de investigación biomédica del país, con la ayuda R01HG014005, y el Chan-Zuckerberg Biohub, la red de institutos de investigación biomédica sin ánimo de lucro creada por la fundación de Priscilla Chan y Mark Zuckerberg. Declaran no tener intereses en conflicto.
Se publicó en Nature el 16 de septiembre de 2026, con licencia CC BY-NC-ND 4.0. Existe una versión anterior en arXiv, de septiembre de 2025, con un autor menos y con cifras distintas: la evaluación de las 300 preguntas sobre 74 artículos no está en ella, y el tiempo de conversión de AlphaGenome que da el preprint son unas tres horas, frente a los 45 minutos de la versión publicada. Si alguien te cita números de este trabajo, comprueba de cuál de las dos versiones vienen.
El código está en GitHub y acumula 2.772 estrellas y 402 bifurcaciones. Existe también un servicio en línea, paper2agent.ai, enlazado desde el propio repositorio; no está documentado si requiere registro, si es gratuito ni qué límites tiene. Y un aviso práctico: el enlace al repositorio de bancos de pruebas que aparece en el README, Paper2AgentBench, devuelve hoy un error 404, así que no pierdas el tiempo buscándolo.
Leer más: Miao, J. et al., Nature (16 de septiembre de 2026) ↗
Conclusión
Lo que Paper2Agent demuestra no es que una IA pueda leer un paper, sino que el material didáctico que duerme dentro de los repositorios científicos se puede convertir en herramientas que se ejecutan, se prueban solas y se descartan cuando no reproducen el resultado. El mérito está en el examen, no en el modelo. Y queda abierta la pregunta incómoda que los propios autores plantean: si una máquina no consigue poner en marcha el código de tu artículo sin ayuda, quizá el problema no sea de la máquina. Mientras tanto, lo que tienes hoy son tres papers a los que puedes preguntar desde una terminal y, si te apetece gastar 8 dólares, un cuarto que aún no existe y que puedes construir tú.
La continuación natural
Aprende IA a tu ritmo con nuestros cursos gratuitos.
En nuestra plataforma de aprendizaje TAKU podrás acceder a este y muchos otros cursos de manera totalmente gratuita.
APRENDER CON TAKUFuentes primarias
- Miao, J., Davis, J. R., Zhang, Y., Pritchard, J. K. y Zou, J., «Reimagining research papers as interactive and reliable AI agents», Nature, 16 de septiembre de 2026 ↗
- Paper2Agent, repositorio oficial en GitHub (licencia MIT): README, instrucciones de instalación y skill ↗
- Preprint en arXiv 2509.06917 — VERSIÓN ANTERIOR del mismo trabajo, con un autor menos y cifras que no coinciden con las de Nature ↗
- paper2agent.ai, el servicio en línea que enlaza el repositorio oficial ↗
- Servidor MCP de AlphaGenome, publicado por los autores en Hugging Face ↗
- Servidor MCP de Scanpy, publicado por los autores en Hugging Face ↗
- Servidor MCP de TISSUE, publicado por los autores en Hugging Face ↗
- Agente de AlphaGenome ya montado, en Hugging Face ↗
- Anthropic, «Introducing the Model Context Protocol», 25 de noviembre de 2024 ↗
- bioRxiv, página institucional sobre qué es el archivo y quién lo opera ↗
- Biomni, el agente biomédico de propósito general usado como comparación ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios