Aprenent IA
Paper2Agent: Aprèn del paper i executa'n el codi
Un sistema de la Universitat de Stanford converteix un article científic i el seu repositori en un agent que executa el codi del mateix article i et respon preguntes sobre el que fa. Publicat a Nature el 16 de setembre, encerta el 91,2 % de 300 preguntes tretes de 74 papers; els seus autors avisen que això mesura execució fidel del codi, no la validesa científica de les conclusions. Aquest curs el desmunta i acaba amb un exercici de mitja hora, sense gastar ni un cèntim.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- Paper2Agent, de la Universitat de Stanford, converteix un article i el seu repositori en un servidor MCP amb eines ja instal·lades i provades que qualsevol assistent d'IA pot cridar; va sortir a Nature el 16 de setembre de 2026, amb codi lliure i llicència MIT.
- Sobre 300 preguntes derivades de tutorials de 74 articles de biologia computacional encerta el 91,2 %, davant del 80,3 % del mateix model amb el paper i el repositori al davant escrivint el codi sobre la marxa (p menor que 0,0001).
- Convertir un paper va costar entre 8 i 14 dòlars i entre 45 i 55 minuts en els tres casos d'estudi; la mitjana dels 74 va ser de 2,4 hores i 14,99 dòlars.
- De cada 100 articles, 26 no es van poder convertir: en el 34 % d'aquests casos no hi havia codi executable i en el 31 % faltaven les dades o els pesos del model.
- L'exercici final es fa en mitja hora i sense clau d'API de pagament: connectar-te als tres agents ja publicats i comprovar que porten 22, 7 i 6 eines, les mateixes xifres que declara l'article.
Què aprendràs i amb què te'n vas d'aquí
Aquest curs ensenya a convertir un article científic en una cosa amb la qual pots parlar i que, quan li preguntes, executa el codi del mateix article. Paper2Agent el signen cinc investigadors de la Universitat de Stanford, el va publicar Nature el 16 de setembre de 2026 i el seu codi és lliure, amb llicència MIT.
La pràctica va al final, es completa en menys d'una hora i no costa ni un cèntim: acabaràs connectat a tres agents ja publicats, i només cal un agent de codi instal·lat. Un avís: el repositori es va reescriure sencer el mateix dia de la publicació, i les instruccions anteriors que circulen per internet parlen d'un script que ja no existeix.
Lliçó 1: el codi d'un paper no està a punt per fer-se servir
L'exemple amb què els autors expliquen el problema és AlphaGenome, el model del laboratori d'intel·ligència artificial de Google, DeepMind, que prediu com afecta el canvi d'una sola lletra de l'ADN als processos que regulen els gens. Per fer-lo servir des del codi cal instal·lar l'entorn, crear objectes client amb claus d'API, construir les entrades i triar les modalitats de sortida.
I hi afegeixen la frase que defineix a qui va adreçat això: l'usuari ha d'entendre la jerarquia de l'API i la semàntica dels paràmetres, cosa que imposa una corba d'aprenentatge als biòlegs poc familiaritzats amb aquestes abstraccions. Qui té la pregunta biològica no és qui sap muntar l'entorn, i aquest desfasament deixa mètode publicat sense fer servir.
Lliçó 2: el paper es converteix en un servidor que s'endolla
Paper2Agent no produeix un resum ni un xatbot que parli de l'article, sinó un servidor MCP: un programa que exposa les funcions del paper ja instal·lades, ja provades i a punt perquè les cridi un assistent.
Els autors ho justifiquen així: MCP s'ha convertit en un estàndard de la indústria per connectar agents basats en models de llenguatge amb recursos externs, i ofereix una interfície unificada per accedir a dades i eines sense integracions a mida. Qualsevol agent extern pot invocar les eines del servidor sense configuració addicional: un paper es converteix una vegada i serveix per a Claude Code, per a Codex o per al que vingui després.
I es poden allotjar en remot, en plataformes com Hugging Face —on es publiquen i es comparteixen models i aplicacions d'intel·ligència artificial—, cosa que elimina, en paraules dels autors, els problemes de dependències locals.
Llegir-ne més: Anthropic, anunci del Model Context Protocol ↗
Lliçó 3: dins del servidor hi ha tres coses diferents
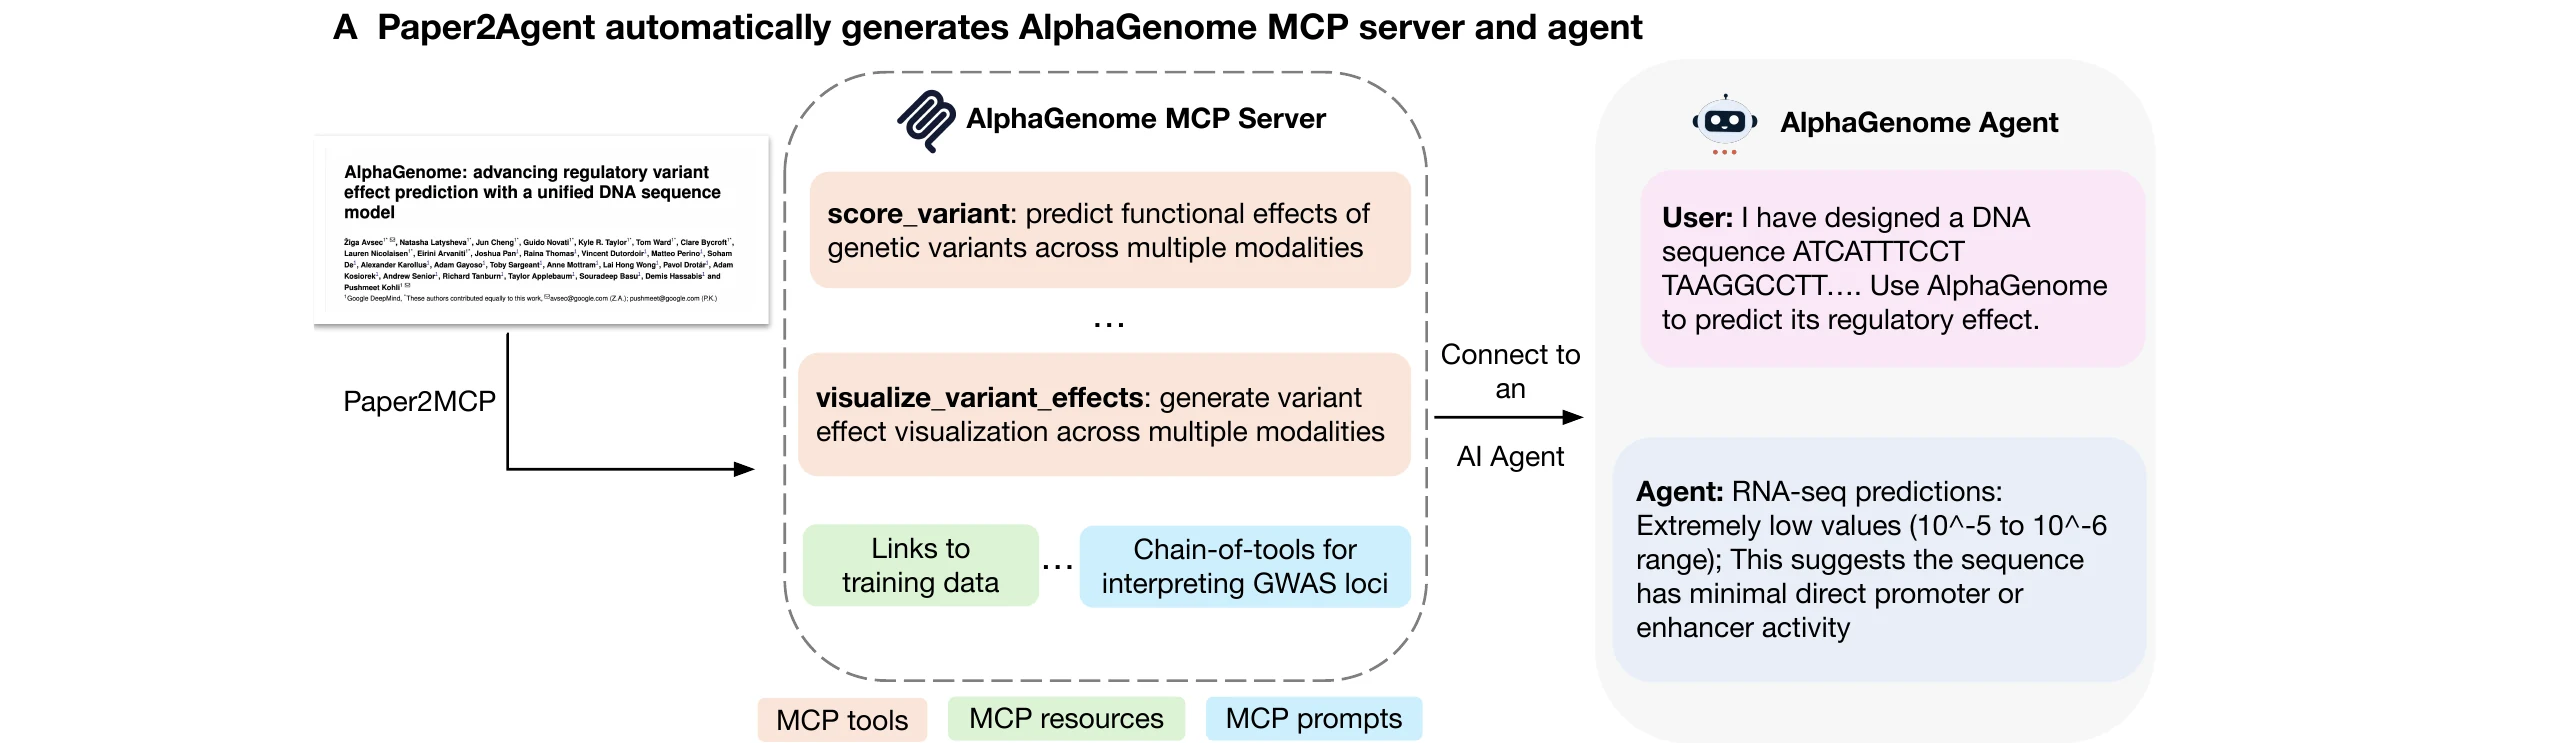
Cada servidor té tres components de l'estàndard MCP. Les MCP tools són funcions executables que encapsulen les contribucions metodològiques de l'article, amb l'entorn ja preconfigurat: és el que crida l'agent quan s'ha de calcular alguna cosa de debò. Els MCP resources són el material estàtic del paper —manuscrit, codi, suplements, taules, figures i enllaços a les dades— i serveixen per preguntar, no per executar. Els MCP prompts són la part menys coneguda i la més interessant.
Els tres s'infereixen automàticament de l'article i del codi, sense curadoria manual. El servidor publicat d'AlphaGenome exposa exactament 22 eines, amb noms com score_variants_batch o visualize_variant_effects; el de Scanpy, 7, i el de TISSUE, 6. A l'exercici final els comptaràs tu mateix.
Lliçó 4: l'MCP prompt és el mètode escrit per a la màquina
En gairebé qualsevol anàlisi l'ordre importa: normalitzar abans o després de filtrar canvia el resultat. Per això Paper2Agent extreu també els fluxos de treball de diversos passos que descriu l'article i els publica com a MCP prompts del servidor, instruccions que l'assistent rep ja escrites.
L'exemple més ben documentat és el de Scanpy. El seu servidor publica un únic prompt, anomenat preprocess_and_cluster_scanpy, que imposa els set passos en el seu ordre: quality_control, normalize_data, select_features, reduce_dimensionality, build_neighborhood_graph, cluster_cells i annotate_cell_types.
I no es limita a enumerar: li diu a l'agent que inspeccioni primer les dades per entendre la mida i la complexitat del conjunt, l'organisme a partir dels noms dels gens, la informació de lots i la qualitat de les dades. I li dona una regla de criteri: adapta els paràmetres de manera intel·ligent segons les característiques de les dades, però queda't amb els valors per defecte si no hi ha una raó de pes per canviar-los.
Lliçó 5: com es construeix, amb els noms dels autors
| Etapa, amb el nom literal dels autors | Què passa | Qui l'executa |
|---|---|---|
| 1. Locate and download the codebase | Identifica el repositori associat a partir del manuscrit, les referències o els suplements, i el clona. Si falla o hi ha diversos candidats, se li passa l'URL a mà | L'orquestrador |
| 2. Environment setup | Crea un entorn virtual net i aïllat, instal·la dependències i resol conflictes | environment-manager |
| 3. Tutorial discovery | Rastreja el repositori, distingeix els tutorials de debò d'altres fitxers i produeix un índex classificat en JSON | tutorial-scanner |
| 4. Tutorial execution and audit | Executa els tutorials de cap a cap amb les seves dades d'exemple, resol els errors i captura entrades, sortides, figures i temps | tutorial-executor |
| 5. Tool extraction, testing, and refinement | Converteix cada tutorial executat en funcions reutilitzables, parametritza els valors fixats a mà i escriu els tests de cadascuna | tutorial-tool-extractor-implementor i test-verifier-improver |
| 6. MCP server assembly | Integra els mòduls validats en un servidor MCP unificat, amb manifest, versionatge i valors de seguretat per defecte | L'orquestrador |
L'arquitectura té dues peces. Paper2MCP extreu informació dels articles i dels seus repositoris per construir servidors MCP remots; la capa d'agent embolcalla cada servidor com a proveïdor de context i el converteix en un agent específic d'aquell paper. Les seves sis etapes són a la taula.
Paper2MCP és un sistema multiagent construït sobre l'SDK d'agents de Claude Code: un orquestrador coordina diversos subagents especialitzats, en seqüència entre etapes i en paral·lel dins d'una etapa quan hi ha diversos tutorials, i les dades passen d'una a l'altra mitjançant informes en JSON estandarditzat. El model base de tots els experiments va ser claude-sonnet-4-20250514.
Admet tres rutes de llenguatge: python, per cridar una biblioteca de Python; r, per carregar un paquet d'R; i cli, per executar ordres. Amb una nota literal del repositori que estalvia malentesos: una ordre d'instal·lació com pip install no és una interfície de línia d'ordres.
Lliçó 6: l'examen que impedeix que l'agent s'inventi el resultat
Cada funció extreta se sotmet a un test, i el criteri per aprovar-lo està escrit amb una precisió incòmoda: un test passa quan es generen els fitxers esperats, quan els resultats numèrics coincideixen exactament amb les sortides del tutorial, amb una tolerància del 3 % en els valors de coma flotant, i quan les figures generades coincideixen amb les visualitzacions de referència, verificat mitjançant hash perceptual amb distància de Hamming menor que 20.
Si el test falla, el sistema diagnostica l'error i aplica arranjaments, amb un màxim de sis intents per funció. I si continua fallant, se li treu el decorador que la converteix en eina MCP i no entra al servidor. Els autors ho expliquen com una mitigació del risc d'al·lucinació de codi, on executar codi imprecís generat per un model podria portar a resultats científics incorrectes.
De les 599 eines que va proposar en els 74 articles convertits amb èxit, 593 van passar la validació automàtica. Les altres sis es van quedar fora, que és exactament el que havia de passar.
Lliçó 7: el 91,2 %, i contra qui es mesura
Ver los datos en tabla
| Paper2Agent (Sonnet 4) | Claude + repositorio (Sonnet 4.6) | Claude + repositorio (Sonnet 4) | |
|---|---|---|---|
| Encert | 91,2% | 86,3% | 80,3% |
| Mesura | Paper2Agent | Claude + repositori (Sonnet 4) | Avantatge |
|---|---|---|---|
| Cost per consulta | 0,20 $ | 0,38 $ | 2,8 vegades més barat |
| Temps per consulta | 1,6 min | 4,3 min | 6,3 vegades més ràpid |
Els autors van agafar 100 articles de bioinformàtica de bioRxiv —l'arxiu obert i gratuït on els investigadors de ciències de la vida dipositen els seus treballs abans de la revisió per parells, operat per l'organització sense ànim de lucre openRxiv i fundat el 2013 pel Cold Spring Harbor Laboratory—, cap enrere en el temps des del desembre de 2025. No van filtrar per qualitat de la documentació, ni per manteniment del repositori, ni per completesa del codi, perquè la mostra reflectís, diuen, l'heterogeneïtat natural del codi de recerca a la pràctica, i els van processar sense neteja manual i sense intervenció humana.
Dels 100 se'n van convertir amb èxit 74, i sobre aquests 74 van construir 300 preguntes derivades dels seus tutorials, amb respostes de referència obtingudes executant el codi original. El resultat és el del gràfic: davant de les dues línies base dona p menor que 0,0001, amb un interval de confiança del 95 % per a la diferència respecte de Claude amb Sonnet 4 d'entre 5,8 i 15,8 punts, calculat amb 10.000 remostratges. La resta de l'avantatge és de butxaca i de rellotge, i és a la taula.
Llegir-ne més: Miao, J. et al., Nature (16 de setembre de 2026) ↗
Lliçó 8: què mesura aquest 91,2 % i què no mesura
Aquest 91,2 % no diu que l'agent hagi validat la ciència de l'article ni replicat les seves conclusions. Diu que encerta una pregunta la resposta de referència de la qual es va obtenir executant el codi original del paper.
Els mateixos autors ho escriuen a la discussió, i la frase mereix citar-se sencera: els bancs de proves basats en la concordança amb una única referència s'han d'interpretar principalment com a mesures d'execució fidel, i no de validesa analítica. I afegeixen que avaluar el ventall de respostes defensables serà important per jutjar sistemes d'intel·ligència artificial en tasques científiques obertes.
Hi ha una segona acotació, a les regles del mateix repositori: la verificació de les eines seleccionades no estableix la correcció de tot el repositori. El que obtens és el codi del paper fent el que fa, de manera fiable i traçable; no un àrbitre que dictamini si el paper tenia raó.
Lliçó 9: el banc de proves d'AlphaGenome
- Paper2Agent
- Claude + repositori
- Biomni
Ver los datos en tabla
| 15 preguntes de tutorial | 15 preguntes noves | 30 preguntes obertes | |
|---|---|---|---|
| Paper2Agent | 98,7% | 100% | 82,7% |
| Claude + repositori | 82,7% | 78,7% | 56,7% |
| Biomni | 37,3% | 56% | 72,2% |
| Conjunt de preguntes | Davant de Claude + repositori | Davant de Biomni |
|---|---|---|
| 15 preguntes de tutorial | 1,9 vegades més ràpid | 3,1 vegades més ràpid |
| 15 preguntes noves | 2,9 vegades més ràpid | 3,8 vegades més ràpid |
L'estudi de cas més detallat separa les preguntes en tres grups. Les de tipus tutorial repeteixen el que el repositori ja ensenya; les noves canvien la variant, el teixit i la modalitat, i comproven si l'agent generalitza o només repeteix; les obertes són preguntes d'investigador, de l'estil d'explicar el mecanisme probable pel qual una variant s'associa a una malaltia.
La tercera columna del gràfic és Biomni, un agent biomèdic de propòsit general desenvolupat també a Stanford, que no va entrar a l'avaluació gran pel seu cost elevat. Dos detalls donen pes a la comparació: l'agent no va tenir accés ni al manuscrit ni al repositori, només al servidor MCP, i les respostes les van corregir dos experts humans independents amb rúbriques definides per endavant.
Lliçó 10: fora de la biologia també funciona
| Corpus | Què es pregunta | Paper2Agent | Línia base |
|---|---|---|---|
| 10 articles computacionals no biològics | 42 tasques basades en execució, 5 execucions | 98,1 % ± 0,8 % | No es reporta |
| 26 articles de dades i descobriment (13 de bioRxiv i 13 de Nature, 2025) | 100 preguntes de síntesi, només amb la capa dels MCP resources | 89,0 % ± 3,1 % | 82,0 % ± 3,8 % (p = 0,03) |
Els autors van provar dos corpus més: 10 articles computacionals d'altres camps —grf, SAELens, Binoculars, SAM2, TabPFN, GenericML, CausalImpact, Nashpy, emcee i conformal-selection— i 26 articles de dades i descobriment, la meitat de bioRxiv i la meitat de Nature, tots del 2025. En aquests últims no hi ha mètode per executar, així que Paper2Agent només fa servir la capa dels MCP resources.
Hi ha a més una prova adversària: van barrejar a l'atzar els parells d'article i pregunta entre aquests 26 papers. Va rebutjar el 100 % de les preguntes fora d'àmbit, tant quan se'l va instruir explícitament per rebutjar-les com quan no se li va dir res.
Lliçó 11: quina peça sosté el sistema
| Variant | 15 preguntes de tutorial | 15 preguntes noves |
|---|---|---|
| Sistema complet | 98,7 % ± 1,3 % | 100,0 % ± 0,0 % |
| Sense el subagent test-verifier-improver | 69,3 % ± 4,5 % | 84,0 % ± 2,7 % |
| MCP tools substituïdes per skills en Markdown | 73,3 % ± 2,6 % sobre les 30 preguntes juntes, davant del 99,3 % ± 0,7 % amb MCP tools | — |
| Agent monolític, tot en una sessió de 200.000 tokens i sense subagents | Va fallar en les tres execucions: no va arribar a generar un servidor MCP vàlid | — |
| Multiagent sense paral·lelisme | Funciona, però de 2,2 a 2,4 vegades més lent | — |
| Backend OpenCode en lloc de Claude Code | 98,7 % ± 1,3 % | 97,3 % ± 1,6 % |
Els autors van anar traient components i tornant a mesurar sobre les 30 preguntes d'AlphaGenome. La taula que en surt no diu si l'invent funciona: diu per què funciona.
L'examen és el cor de l'invent. Sense el subagent que escriu i verifica els tests, l'encert a les preguntes de tutorial s'enfonsa del 98,7 % al 69,3 %. I la forma importa: substituir les MCP tools per fitxers de skill en Markdown —explicar-li al model com es fa servir el codi en comptes de donar-li la funció ja executable— ensorra l'encert del 99,3 % al 73,3 %.
El més rotund és l'agent monolític, que intenta fer-ho tot en una única sessió de 200.000 tokens de context i sense subagents: va fallar en les tres execucions i ni una sola vegada va arribar a produir un servidor MCP vàlid. Canviar la bastida de Claude Code per OpenCode, en canvi, no va moure els resultats.
Lliçó 12: els 26 papers que no es van poder convertir
| Causa de la fallada | Quota dels 26 articles |
|---|---|
| Codi executable absent | 34 % |
| Dades o artefactes de model absents | 31 % |
| Fallades d'entorn o de dependències | 23 % |
| Scripts no generalitzables | 12 % |
Dels 100 articles, 26 no es van poder convertir, i la taula classifica per què. Res del que hi apareix no és una fallada del sistema: són absències al repositori d'origen, i l'intent fallit es paga igual.
Abans de llançar una conversió, mira't el repositori amb aquesta llista al davant. Hi ha codi que es pugui executar, o només fragments il·lustratius? Hi són les dades d'exemple i els pesos del model? Hi ha un fitxer de dependències amb versions? Els scripts accepten paràmetres, o tenen les rutes escrites a foc? Quatre preguntes, cinc minuts.
D'aquí en surt la frase més ambiciosa de l'article: la facilitat amb què un paper es pot transformar en un agent pot servir, per si mateixa, com a mesura pràctica de reproductibilitat. Les fallades, afegeixen, es correlacionen amb la completesa de la documentació, la qualitat de l'especificació de l'entorn i la presència de tutorials executables.
Pràctica, pas 1: instal·lar Paper2Agent, que avui és una skill
Comença la part en què es toca el teclat. Primer de tot, els requisits, literals del repositori: un amfitrió d'agent de codi amb suport de skills, accés a la shell i capacitat de llançar subagents en paral·lel, perquè el coordinador llança especialistes i verificadors nous a través de l'amfitrió. I accés d'execució: Python i Git, més el que exigeixi el repositori que vulguis convertir, sigui R, una eina de línia d'ordres, dades, una API o una GPU.
El repositori no fixa cap versió mínima de Python, i és deliberat: la versió es tria segons els requisits del repositori científic que es converteix. La documentació interna sí que fixa la línia base tècnica: entorns amb uv, i fastmcp en la versió 4.0.3, que al seu torn exigeix Pydantic 2.12 o superior. L'intèrpret del projecte acaba vivint a la ruta de l'entorn que es crea dins del projecte mateix.
Hi ha dues maneres d'instal·lar-lo. La còmoda és demanar-ho a l'agent amb aquest text, tal com apareix al repositori: Read https://github.com/jmiao24/Paper2Agent and install the paper2agent skill from skills/paper2agent for this coding agent.
La manual són quatre ordres. Primer, clonar: git clone https://github.com/jmiao24/Paper2Agent.git i després cd Paper2Agent.
Per a Claude Code: mkdir -p "$HOME/.claude/skills/paper2agent" i després cp -R skills/paper2agent/. "$HOME/.claude/skills/paper2agent/"
Per a Codex: mkdir -p "$HOME/.agents/skills/paper2agent" i després cp -R skills/paper2agent/. "$HOME/.agents/skills/paper2agent/"
Arrenca l'agent a la teva carpeta de treball. I guarda't aquesta línia del repositori, que resol el 90 % dels ensurts: si la skill no apareix després d'instal·lar-la, reinicia l'agent de codi.
Llegir-ne més: Instruccions d'instal·lació al repositori oficial ↗
Pràctica, pas 2: convertir un paper, amb l'ordre exacta i la factura per endavant
| Cas | Eines generades i validades | Temps | Cost |
|---|---|---|---|
| AlphaGenome | 22 de 22 | uns 45 min | 14 $ |
| Scanpy, només el tutorial de preprocessament i agrupament | 7 de 7 | uns 45 min | 13 $ |
| TISSUE | 6 de 6 | 55 min | 8 $ |
| Mitjana dels 74 articles convertits amb èxit | 593 de 599 en total | 2,4 h | 14,99 $ |
| Mitjana dels 26 articles que van fallar | — | 1,7 h | 9,03 $ |
La invocació a Claude Code és /paper2agent; a Codex, se substitueix per $paper2agent. Aquests són els tres exemples del repositori, literals.
TISSUE, el més senzill: /paper2agent Convert https://github.com/sunericd/TISSUE into tested MCP tools in TISSUE_Agent.
Scanpy, limitant la feina a un sol tutorial, que és com s'abarateix: /paper2agent Convert https://github.com/scverse/scanpy into tested MCP tools in Scanpy_Agent. Focus on the "Preprocessing and clustering" tutorial.
AlphaGenome, que necessita una clau d'API: /paper2agent Convert https://github.com/google-deepmind/alphagenome into tested MCP tools in AlphaGenome_Agent. Read the API key from the environment variable ALPHAGENOME_API_KEY.
Val la pena fixar-se en la forma genèrica, perquè ensenya on són les quatre decisions: Use the paper2agent skill to convert <GITHUB_URL> into MCP tools in <PROJECT_DIR>. Focus on <TASKS, TUTORIAL_TITLE, or SOURCE_URL>. És a dir: quin repositori, on deixes el resultat, en quina part se centra i de quina variable d'entorn treu la clau.
I un advertiment contra el costum: no hi ha cap fitxer de configuració per emplenar. No busquis un config.yaml, perquè no existeix. Tota la configuració es passa en llenguatge natural dins del text mateix. El que sí que genera el sistema són fitxers d'estat interns, com .pipeline/language.json o reports/agent-runs.json, que serveixen per auditar l'execució, no per configurar-la.
La regla de credencials del repositori és taxativa i val la pena respectar-la: les credencials es queden fora del codi generat, dels quaderns, dels informes i del ZIP lliurat; es passen per l'entorn del procés o per un mecanisme de secrets, i no s'incrusten al codi font, els quaderns, els informes, els casos de prova ni les eines generades.
Sobre els diners: el repositori no publica cap tarifa, perquè el que es paga és el consum del teu propi agent de codi. Les úniques xifres publicades són les de l'article, i són a la taula. Totes es van mesurar en un ordinador portàtil: un MacBook Air amb xip M2, 8 nuclis de CPU, 8 de GPU i 8 GB de memòria unificada.
Pràctica, pas 3: què et lliura i per què et pots refiar del paquet
En el mode combinat, la sortida és una carpeta dist amb dues coses a dins: la skill del paper i el servidor MCP del repositori. En el mode de només codi, el lliurable és un únic fitxer comprimit, dist/<repo-name>-mcp.zip, que conté un projecte de servidor MCP usable.
Dins del ZIP hi va un USAGE.md que és el document que de debò importa: diu l'àmbit admès, les plataformes en què es va provar, com s'instal·la, com s'arrenca, com es configura el client, quins paràmetres i quines sortides té cada eina, els prerequisits i els límits de la validació. Hi van també el punt d'entrada del servidor, els mòduls d'eines i un src/requirements.txt amb les versions fixades.
L'interessant és com es valida aquest ZIP abans de lliurar-te'l, perquè és la part que gairebé cap projecte no fa: s'extreu en un altre directori diferent, inclòs un amb espais a la ruta, es crea un entorn de Python nou, s'arrenca el servidor i un verificador independent executa crides MCP reals contra totes les eines lliurades. I es registra el SHA-256 del fitxer.
Traduït: no et lliuren un paquet que funcionava a la màquina on es va construir, sinó un que s'ha tornat a muntar de zero en un altre lloc i ha respost.
Pràctica, pas 4: connectar el servidor al teu client
Amb un servidor generat en local, el camí oficial és extreure el ZIP i seguir el seu USAGE.md per instal·lar dependències i configurar el client. També val demanar-ho a l'agent amb una frase: Connect the generated MCP server to my coding-agent client using its USAGE.md.
Amb un servidor remot, a Claude Code, l'ordre és una: claude mcp add --transport http <MCP_NAME> <MCP_ENDPOINT_URL>.
El repositori inclou a més un script equivalent, scripts/connect_remote_mcp.sh, amb aquest exemple a la seva pròpia ajuda: bash scripts/connect_remote_mcp.sh --working_dir ./analysis --mcp_name paper --mcp_url https://example.com/mcp. Accepta --transport http o sse, amb http per defecte, i --no-launch per registrar el servidor sense obrir sessió.
Per comprovar que ha funcionat: claude mcp list. O, ja dins de Claude Code, l'ordre /mcp. Una connexió correcta apareix a la llista de servidors.
Avís important per a qui vingui buscant el bloc de configuració típic dels clients d'escriptori: el repositori no publica cap fitxer JSON amb la clau mcpServers per a Claude Desktop ni per a Cursor. L'únic que documenta és claude mcp add. Si el teu client necessita aquest JSON, surt de l'USAGE.md que genera la teva pròpia conversió, no d'una plantilla copiada d'un tutorial d'internet.
Exercici guiat: parla amb tres papers en mitja hora
L'exercici no converteix cap paper a propòsit. Convertir costa entre 45 minuts i dues hores i mitja i entre 8 i 15 dòlars d'API, i això no cap ni en una sessió ni a la butxaca de qui només vol entendre l'invent. El que faràs servir són els tres agents que els autors ja han publicat i deixat oberts. Requisits: un agent de codi instal·lat i funcionant. Res més. El pas 7 és opcional i és l'únic que demana una clau.
Pas 1, dos minuts. Crea l'espai de treball i connecta els tres servidors: mkdir paper-agents && cd paper-agents
claude mcp add --transport http alphagenome https://Paper2Agent-alphagenome-mcp.hf.space/mcp
claude mcp add --transport http scanpy https://Paper2Agent-scanpy-mcp.hf.space/mcp
claude mcp add --transport http tissue https://Paper2Agent-tissue-mcp.hf.space/mcp
Pas 2, un minut. Comprova que són vius amb claude mcp list, i després amb /mcp des de dins de l'agent.
Pas 3, cinc minuts. Compta el que ha arribat. Pregunta-li a l'agent: quines MCP tools tens disponibles d'alphagenome, scanpy i tissue, quantes n'hi ha de cada servidor i per a què serveix cadascuna.
Pas 4, cinc minuts. Fes servir el paper com a manual interactiu, sense executar res, que és el cas que els autors documenten per a TISSUE: Based on the TISSUE MCP server, what are the required inputs for TISSUE? Compara la resposta amb el que t'hauria costat treure això mateix llegint el repositori.
Pas 5, cinc minuts. Mira l'MCP prompt, que és el concepte menys conegut i el més útil. Demana-li: mostra'm l'MCP prompt preprocess_and_cluster_scanpy del servidor scanpy i explica'm, pas a pas, quin ordre d'eines imposa i per què aquest ordre importa. Aquí descobreixes que el servidor no porta només funcions: porta el flux de treball de l'article codificat.
Pas 6, deu minuts. Mira per dins una eina: per a l'eina visualize_variant_effects d'alphagenome, digue'm tots els seus paràmetres d'entrada, els seus valors per defecte i què retorna. Fixa't que els paràmetres estan anotats i que no hi ha valors fixats a foc. Aquesta és la diferència entre una eina i un quadern copiat.
Pas 7, opcional, deu minuts, requereix clau d'AlphaGenome. És la consulta de demostració del repositori: Analyze heart gene expression data with AlphaGenome MCP to identify the causal gene for the variant chr11:116837649:T>G, associated with Hypoalphalipoproteinemia.
Comprovació: si et surten 22, 7 i 6, ho has fet bé
El pas 3 és el moment didàctic de l'exercici, i té una resposta exacta. El servidor d'AlphaGenome ha de declarar 22 eines, el de Scanpy 7 i el de TISSUE 6. Són les mateixes xifres que apareixen a la taula de casos d'estudi de l'article de Nature. Acabes de verificar en trenta segons, des d'un terminal, tres xifres d'un paper publicat en una revista científica de primer nivell. Això, fins aquesta setmana, no es podia fer.
Si et surten altres xifres, revisa dues coses abans de res: que l'adreça acabi en /mcp i que hagis reiniciat l'agent després d'afegir els servidors.
I ara el parany que cal conèixer abans de posar-se a provar amb dades pròpies. Les eines d'aquests servidors reben rutes de fitxer, i aquestes rutes es resolen al servidor remot, no al teu ordinador. No hi ha cap eina de pujada de fitxers. Amb els servidors allotjats pots conversar, inspeccionar i fer servir el que ja viu allà, però no els pots passar el teu conjunt de dades.
Per analitzar dades pròpies cal generar el servidor en local amb la skill, i això ja és la lliçó següent: uns 45 minuts i uns 13 dòlars si tries el cas barat i documentat, que és Scanpy amb un sol tutorial, o TISSUE per 8 dòlars i 55 minuts.
Quan el repositori està trencat, l'agent l'arregla
Els autors van injectar sis categories de fallades en repositoris reals —dependències eliminades, rutes trencades, errades al codi, crides a API obsoletes, APIs web obsoletes i canvis en el format de les dades— sobre AlphaGenome en Python, POP-TOOLS per línia d'ordres en Python i mlearner per línia d'ordres en R, en dotze configuracions diferents. Paper2Agent les va detectar llegint el llistat d'error que imprimeix el programa quan es trenca, va aplicar arranjaments i va tornar a executar: els servidors reparats van treure entre un 95,6 % i un 98,3 % al banc de 30 preguntes d'AlphaGenome.
La prova més exigent va ser una altra: van treure tots els tutorials executables de POP-TOOLS i van deixar només el README i el codi font. El sistema es va fabricar quatre scripts de tutorial a partir del README, dels dos punts d'entrada de línia d'ordres i dels mòduls d'utilitats, i va produir un servidor funcional amb quatre eines. En les cinc tasques de validació, la sortida de l'eina MCP va ser idèntica byte a byte a la de l'ordre original. Conclusió dels autors: els tutorials curats són preferibles, però no imprescindibles.
I van comprovar que no hi ha dreceres: un agent revisor automàtic va buscar constants fixades a foc, rutes fixes, sortides en memòria cau i heurístiques que depenguin del conjunt de dades, i no va trobar evidència sistemàtica d'aprenentatge per drecera.
Tres casos: Scanpy, TISSUE i el gen que l'agent no va triar
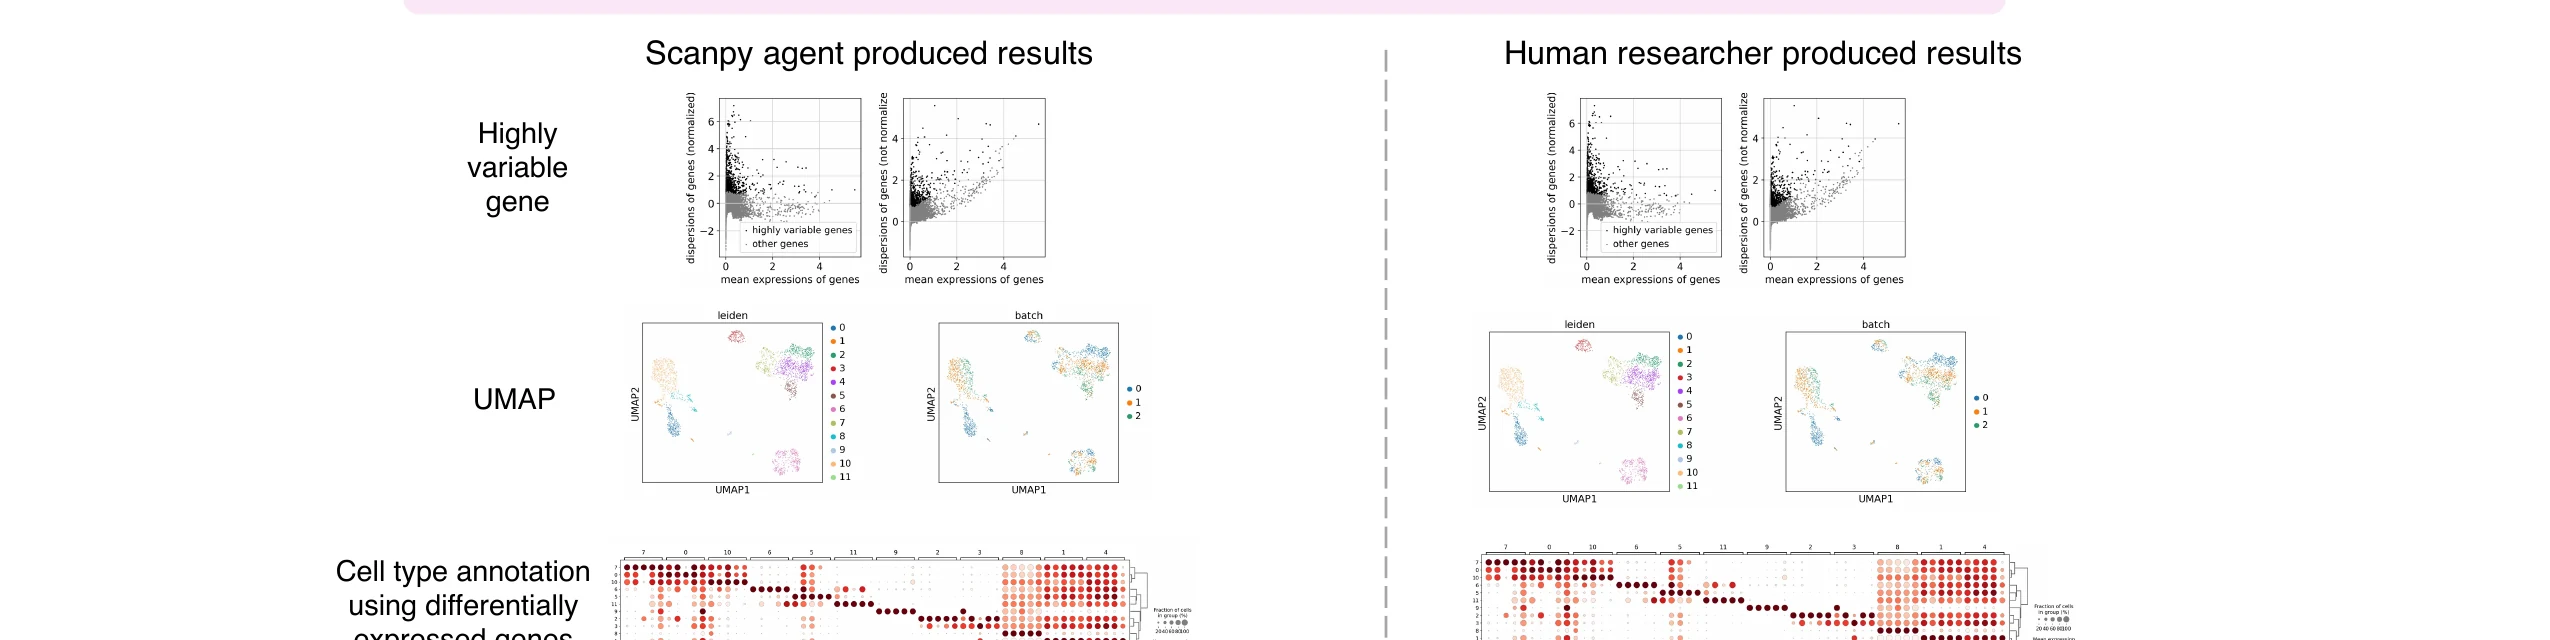
Scanpy és un paquet molt utilitzat per analitzar transcriptòmica de cèl·lula única, publicat el 2018. Els autors van aplicar el seu agent a quatre conjunts de dades públics que no eren al seu codi, i les sortides van coincidir amb les d'investigadors humans: els mateixos recomptes de cèl·lules i gens després del control de qualitat i els mateixos marcadors per grup.
Que no repeteix de memòria es veu en set conjunts processats amb el mateix text genèric. Va deduir l'organisme pel patró dels noms dels gens i va passar pel seu compte del prefix MT- dels gens mitocondrials humans al mt- del ratolí, amb marcadors de llinatge propis de cada teixit, com Slc17a7 per al cervell o Myh6 per al cor; i en un tumor cerebral humà hi va afegir, sense que ningú l'hi demanés, gens conductors de glioma.
TISSUE és un mètode de predicció calibrada per incertesa per a transcriptòmica espacial, publicat a Nature Methods el 2024, i els seus recursos converteixen la secció de disponibilitat de dades de l'article en un registre consultable a través de l'API de Zenodo, el repositori obert de dades científiques allotjat al CERN.
El tercer cas és el millor moment de l'article. A la variant chr1:109274968:G>T se li coneix una associació amb el colesterol LDL, i el paper original d'AlphaGenome destacava com a gens causals CELSR2 i PSRC1. L'agent, amb una sola instrucció, en va prioritzar un altre: SORT1, per una puntuació de quantil de 0,99982 sobre la seva expressió al fetge i perquè SORT1 codifica la sortilina, una proteïna implicada en la secreció d'LDL i VLDL. Els autors ho van comprovar: la variant és, efectivament, un eQTL significatiu per a SORT1 al fetge.
Però CELSR2 i PSRC1 també tenen puntuacions altíssimes, 0,99998 cadascun, i eQTL significatius. La conclusió dels autors no és que l'agent enxampés un error, sinó que l'episodi il·lustra la dificultat inherent d'assignar amb confiança gens causals en loci complexos d'estudis d'associació. Amb una sola instrucció, un usuari pot reavaluar conclusions publicades fent servir evidència independent basada en models: reobrir la discussió costa cèntims i minuts.
Diversos papers alhora: el cas de la psoriasi
| Condició de la cèl·lula | Correlació de Spearman | Valor de p |
|---|---|---|
| Estimulada, 8 hores | 0,613 | 3,79e-3 |
| Estimulada, 48 hores | 0,630 | 4,71e-3 |
| En repòs | 0,29 | 0,21 (no significatiu) |
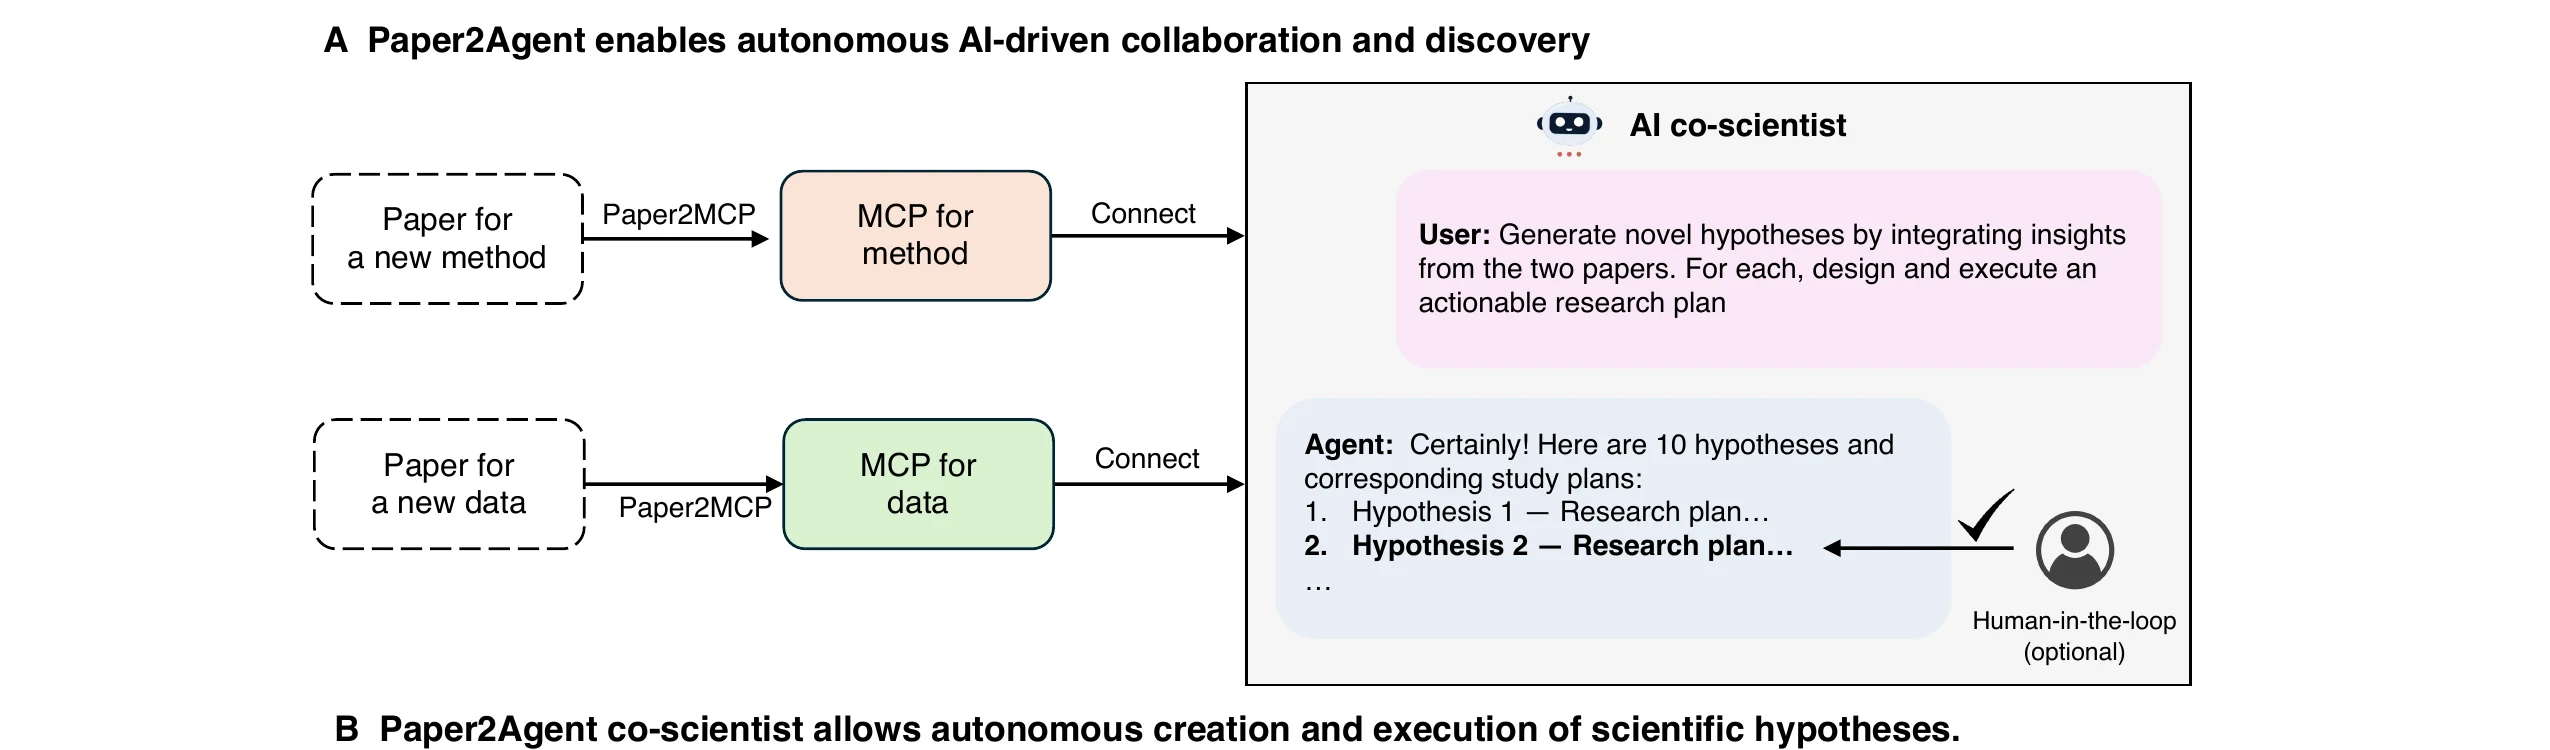
Com que els servidors MCP són modulars i es connecten tots al mateix assistent, el pas següent és posar a treballar junts diversos agents. Els autors ho demostren amb la psoriasi i tres de generats pel sistema: el d'AlphaGenome, el d'un treball de cribratge genètic publicat a Nature Genetics el 2025 i el d'un estudi de pertorbacions sobre limfòcits T CD4+.
L'agent d'AlphaGenome va predir GPR137 com el gen més afectat en aquestes cèl·lules. Després, un agent científic va inspeccionar el manuscrit, les taules suplementàries i les estadístiques d'expressió diferencial dels altres dos treballs i va proposar deu estratègies de validació; un investigador humà en va triar una. El resultat és a la taula: només quan es va reduir a propòsit l'activitat de GPR137 va aparèixer concordança significativa amb la signatura de pertorbació sota estimulació, i no en repòs, de manera que interpreten el seu paper com a dependent de l'activació cel·lular.
El que és notable no és el gen, sinó que l'estratègia que va proposar l'agent no és a cap dels articles d'origen. Hi ha un segon cas, sobre el TDAH, en què va prioritzar una variant entre 209 candidates i va proposar un mecanisme per alteració del tall i empalmament, una hipòtesi que, diuen literalment, queda per validar experimentalment.
Abans de publicar un agent: límits, llicències i crèdit
Un curs que només expliqui el que funciona és publicitat. El límit més important l'escriuen els autors: el raonament científic obert, inclosa la generació d'hipòtesis i la interpretació mecanicista, continua requerint una persona dins del bucle. Els investigadors, escriuen, continuen sent responsables de triar les direccions i d'avaluar l'evidència, i per això veuen Paper2Agent com una eina per augmentar el descobriment científic, i no com una font autònoma o autoritzada de conclusions científiques.
Hi ha un límit de manteniment: els agents de paper necessiten manteniment continu a mesura que evolucionen les bases de codi i les dependències de les quals pengen, i proposen un agent que reexecuti les validacions i marqui per a revisió humana el que no pugui arreglar. I un de conceptual: de vegades l'agent més útil no representa un sol paper sinó una col·lecció de treballs relacionats.
Paper2Agent es distribueix amb llicència MIT, però això no governa el que tu generis amb ell. La regla, escrita al material suplementari, és que els servidors MCP continuen subjectes a les llicències originals del codi subjacent, i que la distribució a tercers ha de preservar l'autoria i les restriccions d'ús: l'agent que fabriquis hereta la llicència del codi del paper, no la de l'eina amb què el vas fabricar.
Els servidors poden heretar a més vulnerabilitats dels articles i repositoris d'on surten, així que les eines s'executen en entorns aïllats amb permisos restringits i conserven enllaços traçables al seu codi font. Sobre el crèdit, els autors recomanen tractar-los com a instruments computacionals, amb el mèrit per a qui va desenvolupar el mètode, va generar les dades i va dissenyar l'estudi; i proposen que les revistes exigeixin una secció de disponibilitat de l'agent, com avui exigeixen la de dades i codi.
Qui ho signa, qui ho paga i on és cada cosa
Ho signen Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard i James Zou, de la Universitat de Stanford, a Califòrnia; Miao i Zou són els autors de correspondència i no hi ha cap laboratori Paper2Agent: surt dels grups de Zou i de Pritchard. El financen els Instituts Nacionals de Salut dels Estats Units, la principal agència pública de recerca biomèdica del país, amb l'ajut R01HG014005, i el Chan-Zuckerberg Biohub, la xarxa d'instituts de recerca biomèdica sense ànim de lucre creada per la fundació de Priscilla Chan i Mark Zuckerberg. Declaren no tenir interessos en conflicte.
Es va publicar a Nature el 16 de setembre de 2026, amb llicència CC BY-NC-ND 4.0. Existeix una versió anterior a arXiv, del setembre de 2025, amb un autor menys i amb xifres diferents: l'avaluació de les 300 preguntes sobre 74 articles no hi és, i el temps de conversió d'AlphaGenome que dona el preprint són unes tres hores, davant dels 45 minuts de la versió publicada. Si algú et cita xifres d'aquest treball, comprova de quina de les dues versions surten.
El codi és a GitHub i acumula 2.772 estrelles i 402 bifurcacions. Existeix també un servei en línia, paper2agent.ai, enllaçat des del repositori mateix; no està documentat si requereix registre, si és gratuït ni quins límits té. I un avís pràctic: l'enllaç al repositori de bancs de proves que apareix al README, Paper2AgentBench, avui retorna un error 404, així que no perdis el temps buscant-lo.
Llegir-ne més: Miao, J. et al., Nature (16 de setembre de 2026) ↗
Conclusió
El que demostra Paper2Agent no és que una IA pugui llegir un paper, sinó que el material didàctic que dorm dins dels repositoris científics es pot convertir en eines que s'executen, es proven soles i es descarten quan no reprodueixen el resultat. El mèrit és de l'examen, no del model. I queda oberta la pregunta incòmoda que plantegen els mateixos autors: si una màquina no aconsegueix posar en marxa el codi del teu article sense ajuda, potser el problema no és de la màquina. Mentrestant, el que tens avui són tres papers als quals pots preguntar des d'un terminal i, si et ve de gust gastar 8 dòlars, un quart que encara no existeix i que pots construir tu.
La continuació natural
Aprèn IA al teu ritme amb els nostres cursos gratuïts.
A la nostra plataforma d'aprenentatge TAKU podràs accedir a aquest i a molts altres cursos de manera totalment gratuïta.
APRENDRE AMB TAKUFonts primàries
- Miao, J., Davis, J. R., Zhang, Y., Pritchard, J. K. i Zou, J., «Reimagining research papers as interactive and reliable AI agents», Nature, 16 de setembre de 2026 ↗
- Paper2Agent, repositori oficial a GitHub (llicència MIT): README, instruccions d'instal·lació i skill ↗
- Preprint a arXiv 2509.06917 — VERSIÓ ANTERIOR del mateix treball, amb un autor menys i xifres que no coincideixen amb les de Nature ↗
- paper2agent.ai, el servei en línia que enllaça el repositori oficial ↗
- Servidor MCP d'AlphaGenome, publicat pels autors a Hugging Face ↗
- Servidor MCP de Scanpy, publicat pels autors a Hugging Face ↗
- Servidor MCP de TISSUE, publicat pels autors a Hugging Face ↗
- Agent d'AlphaGenome ja muntat, a Hugging Face ↗
- Anthropic, «Introducing the Model Context Protocol», 25 de novembre de 2024 ↗
- bioRxiv, pàgina institucional sobre què és l'arxiu i qui l'opera ↗
- Biomni, l'agent biomèdic de propòsit general utilitzat com a comparació ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentarios