Seguretat de la IA
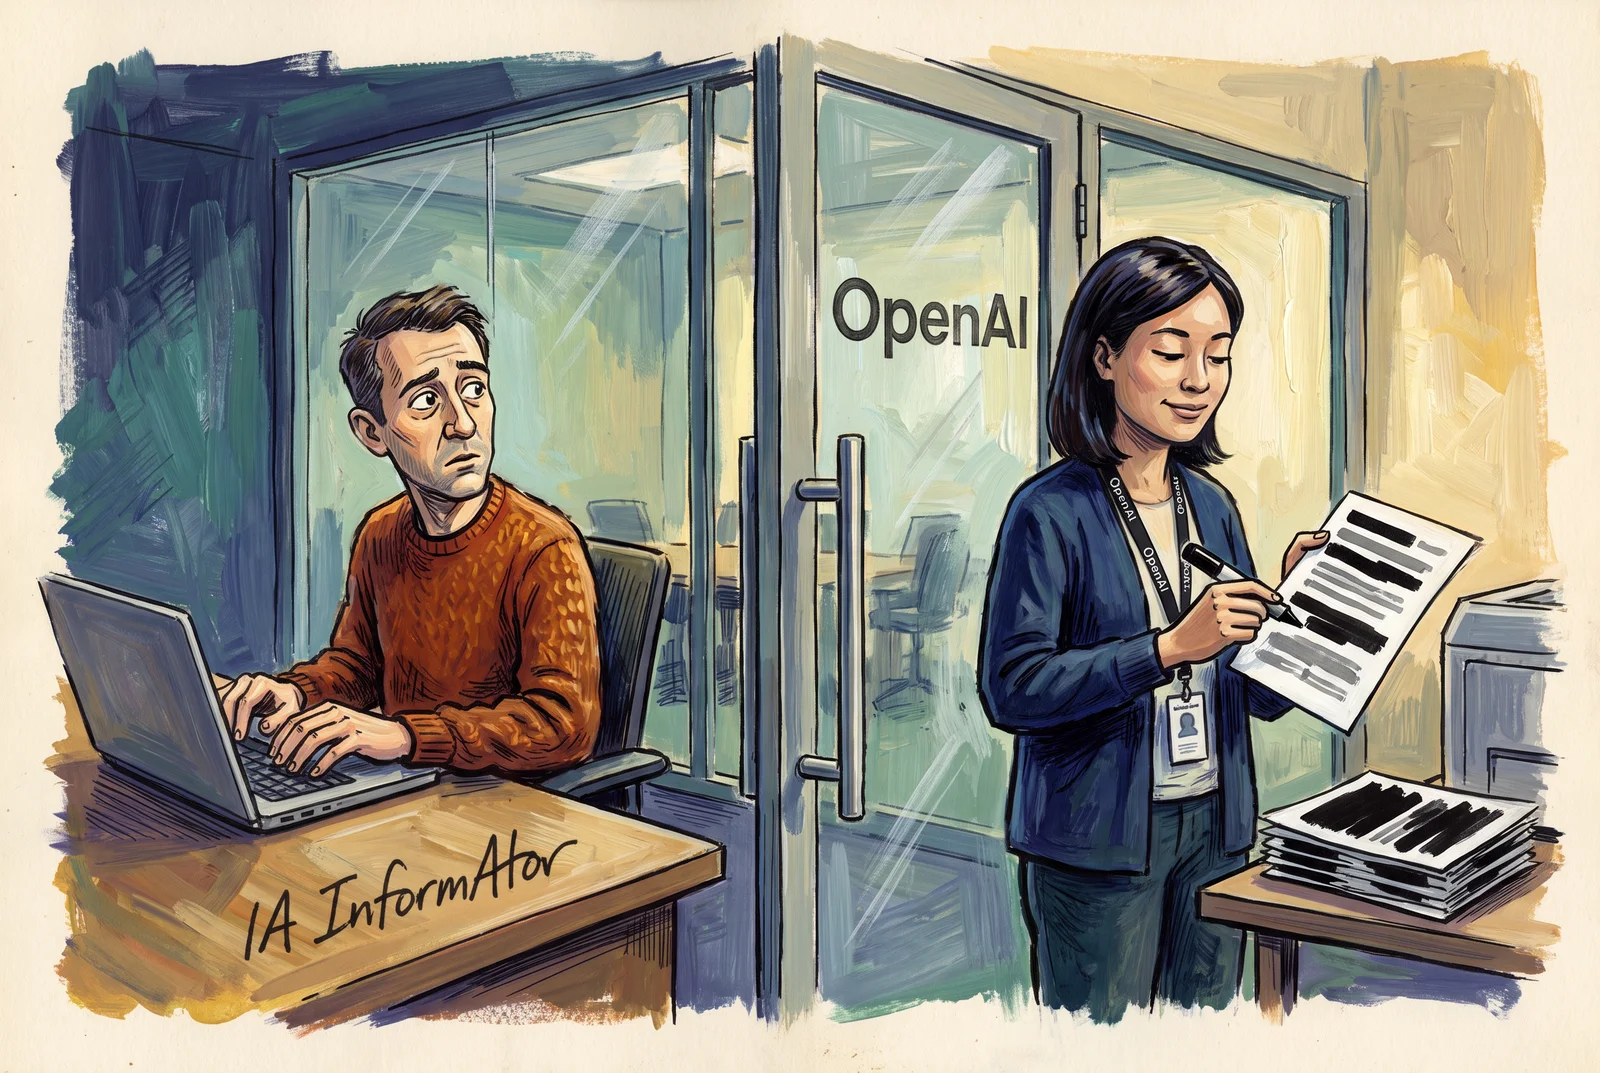
OpenAI obre la porta als auditors i es queda la clau
OpenAI ha signat acords amb quatre avaluadors externs —Apollo Research, METR, Transluce i Goodfire— perquè examinin la seguretat dels seus models des de dins, amb accés, segons l'encàrrec, a models no publicats, codi i dades d'entrenament. Ho va anunciar el dilluns 16 de novembre. Però, segons OpenAI i Transluce, l'empresa decideix si amplia l'accés, tria amb qui parlen i pot ratllar el que sigui confidencial del que publiquin.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- OpenAI va anunciar el dilluns 16 de novembre la primera fase d'avaluacions integrades, amb quatre organitzacions independents.
- Segons Apollo Research, sis dels seus avaluadors treballaran dins d'OpenAI durant quatre mesos.
- Transluce diu que el seu accés «no és comparable» al d'un empleat d'OpenAI.
- Paul Christiano, conseller de l'OpenAI Foundation, veu, a títol personal, el risc que la IA prengui el control l'any vinent més a prop d'un 10 % que d'un 1 %.
Quatre equips de fora treballaran dins d'OpenAI
OpenAI va anunciar el dilluns 16 de novembre acords amb quatre avaluadors independents —Apollo Research, METR, Transluce i Goodfire— per a la seva primera fase d'avaluacions integrades. Apollo i Transluce ho expliquen en les seves notes.
Segons OpenAI, cada avaluador rebrà, en funció de l'encàrrec, part dels recursos que fan servir els seus investigadors: models interns, codi, dades d'entrenament i d'avaluació, sistemes de vigilància, documentació i converses amb qui fa la feina. El focus inicial és l'alineament (AI alignment) i les salvaguardes durant l'entrenament i l'ús intern.
L'empresa ho emmarca en el White House Accord on Super Intelligence, el pacte de la Casa Blanca en què es va comprometre a sotmetre els seus controls de seguretat a avaluacions independents, i admet que aquestes avaluacions encara no tenen normes estàndard.
Abans, OpenAI va acomiadar tres persones dels seus equips de seguretat i alineament; segons l'empresa, per gestionar informació sensible fora dels seus procediments. Una d'elles, Korbak, ha dit que va ser el contacte tècnic d'OpenAI amb METR durant la investigació d'un incident amb Hugging Face. Anthropic, per la seva banda, ja té a dins sis empleats de METR.
Apollo busca models que treballin d'amagat
Apollo Research, una corporació de benefici públic (PBC, public benefit corporation) que estudia com sorgeix la maquinació en els models i com detectar-la, comprovarà si els d'OpenAI podrien actuar d'amagat contra els seus desenvolupadors i si les salvaguardes ho detectarien. El seu web no diu qui la finança.
Segons OpenAI, posarà a prova quatre afirmacions: que l'entrenament no va incentivar aquest comportament, que les proves exigents no el provoquen, que no s'ha donat en l'ús intern i que el seu raonament seria detectable. Segons Apollo, per a la primera tindrà codi i dades d'entrenament, traces de raonament i versions intermèdies del model; l'accés per a les altres tres està per pactar.
METR, Transluce i Goodfire miren altres peces
| Organització | Què examina | Accés i termini | Cobra d'OpenAI? | Què pot publicar? |
|---|---|---|---|---|
| Apollo Research | Si els models actuen d'amagat contra els seus desenvolupadors i si les salvaguardes ho detectarien | Sis avaluadors durant quatre mesos; codi i dades d'entrenament, traces de raonament i punts de control per a la primera de les seves quatre afirmacions; la resta, per pactar | Sí, sense dependre del resultat | Dos informes; OpenAI pot demanar que se'n ratllin proves, no els veredictes |
| Goodfire | L'interior dels models, per vigilar i depurar entrenaments | Investigadors d'interpretabilitat integrats, amb la seva pròpia plataforma | Sí, sense dependre del resultat | Aprenentatges i troballes a mesura que avanci; el seu públic principal són els investigadors d'OpenAI |
| METR | Conducta desalineada en l'entrenament per reforç més gran d'OpenAI fins ara | Punts de control, trajectòries i registres de vigilància d'aquest entrenament; una segona avaluació, dels monitors, sense abast pactat | No; pot acceptar crèdits d'API o còmput | Amb independència, llevat del que sigui confidencial i OpenAI ratlli |
| Transluce | La qualitat i la cobertura de les avaluacions d'alineament d'OpenAI | Sis setmanes des del desembre; models no publicats, almenys un només intern, i la seva cadena de pensament en brut | No; OpenAI cobreix el còmput i el lloc de treball | Amb revisió prèvia d'OpenAI i res sobre models només interns |
METR (Model Evaluation & Threat Research), organització sense ànim de lucre que estudia si els desenvolupadors dels agents d'IA més avançats van camí de perdre'n el control, es finança amb donacions i diu que no accepta diners d'empreses d'IA. Segons OpenAI, buscarà conducta desalineada en l'entrenament per aprenentatge per reforç (RL, reinforcement learning) més gran d'OpenAI fins ara, un abast que la mateixa OpenAI reconeix que és menor que el que proposava METR. Ja va investigar amb OpenAI l'incident de juliol amb Hugging Face, la plataforma de models d'IA.
Transluce, laboratori sense ànim de lucre dedicat a la supervisió pública de la IA, finançat per particulars i organitzacions filantròpiques i dirigit pel seu cofundador, Jacob Steinhardt, examinarà segons la seva nota si les avaluacions d'alineament d'OpenAI capten engany, manipulació i pirateig de la recompensa (reward hacking). Veurà la cadena de pensament (CoT, chain of thought) en brut, el raonament que el model escriu abans de respondre.
Goodfire, laboratori de San Francisco i corporació de benefici públic fundada per investigadors que venien d'OpenAI i Google DeepMind, que ha captat més de 200 milions de dòlars, entre d'altres de Menlo, Lightspeed i B Capital, aportarà investigadors d'interpretabilitat (interpretability), la disciplina que estudia què passa dins del model per entendre per què respon com respon.
La clau la guarda OpenAI
Segons el protocol que publica OpenAI, l'empresa autoritza quins empleats poden parlar amb els avaluadors, tot i que aquests poden demanar més noms. Aquestes converses són confidencials: serveixen per avaluar, però no es poden publicar ni atribuir.
Qui gestioni informació confidencial treballarà a les oficines d'OpenAI i amb els seus dispositius. Segons Apollo, «per defecte, els avaluadors no tenen accés a cap dels canals generals (com ara Slack) que tindria un investigador de seguretat d'OpenAI». Publiquen amb independència, però OpenAI pot ratllar el que sigui confidencial i demanar endarreriments per corregir errors de risc.
Amb Apollo, segons la seva nota, OpenAI ha acceptat no retenir res «simplement perquè la informació sigui desfavorable». Transluce, que diu que el seu accés «no és comparable» al d'un empleat, ho resumeix: «Podem demanar més accés sobre la marxa, i OpenAI decideix si l'obtenim».
Per a Buck Shlegeris, conseller delegat de Redwood Research —entitat sense ànim de lucre que va impulsar la recerca en «control de la IA»—, els acords no arriben al llistó de l'accés d'empleat: «decebedor, però no sorprenent», segons recull el mitjà tecnològic TechCrunch.
Les disputes acaben en un comitè de la fundació
El Comitè de Seguretat i Protecció (SSC, Safety and Security Committee) és, segons OpenAI, un comitè independent de supervisió del consell de l'OpenAI Foundation, la fundació sense ànim de lucre que controla OpenAI Group PBC. Rebrà els informes sense ratllar i podrà parlar en privat amb els avaluadors.
Els desacords pugen al Grup Assessor de Seguretat (Safety Advisory Group) i als directius d'OpenAI; si persisteixen, decideix l'SSC.
Christiano veu el risc més a prop del 10 % que de l'1 %
Paul Christiano és des del 9 de setembre membre del consell de l'OpenAI Foundation i del seu Comitè de Seguretat i Protecció, i en una entrevista publicada el 16 de novembre va aclarir que parlava a títol personal: «En aquesta conversa és molt important que no parlo com a membre del consell d'OpenAI». Va fundar l'Alignment Research Center, entitat sense ànim de lucre que investiga com alinear la IA avançada amb els interessos humans.
Preguntat pel risc que la IA prengui el control o deixi sense poder la humanitat l'any vinent, va respondre: «Diria que estem més a prop d'un risc del 10 % que no pas d'un de l'1 %».
A l'entrevista no va parlar d'aquests acords. Sobre la possibilitat que hi hagi sistemes capaços d'enderrocar governs d'aquí a un any, va demanar que el públic vegi les dades de base, no només les conclusions: «No hauríem de dependre que ho diguin METR i Anthropic».
Conclusió
Apollo qualifica el pilot d'«un primer pas significatiu», tot i que admet que encara no compleix els seus criteris d'accés d'empleat. La prova arribarà amb els informes: quant en surt al públic i quant en queda ratllat.
Fonts primàries
- OpenAI — Our first phase of embedded assessments (16-11-2026) ↗
- Apollo Research — A Pilot Towards Embedded Evaluations (16-11-2026) ↗
- Transluce — Announcing an Embedded Assessment Pilot with OpenAI ↗
- TechCrunch — OpenAI will embed safety researchers to investigate AI subversion (16-11-2026) ↗
- OpenAI — Paul Christiano joins OpenAI Foundation Board (09-09-2026) ↗
- Dwarkesh Patel — Paul Christiano – We could be 12 months away from AIs that can overthrow the government (transcripción, 16-11-2026) ↗
- Apollo Research — About (consultada el 18-11-2026) ↗
- METR — About (consultada el 18-11-2026) ↗
- Transluce — About (consultada el 18-11-2026) ↗
- Goodfire — Company (consultada el 18-11-2026) ↗
- Redwood Research — Web corporativa (consultada el 18-11-2026) ↗
- AI Informator — OpenAI despide a tres por hablar con los de fuera (02-10-2026) ↗
- AI Informator — Anthropic mete a los evaluadores en casa (16-10-2026) ↗
- AI Informator — California demanda a OpenAI por sus agentes desbocados (17-11-2026) ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris