Seguridad de la IA
OpenAI abre la puerta a los auditores y se queda la llave
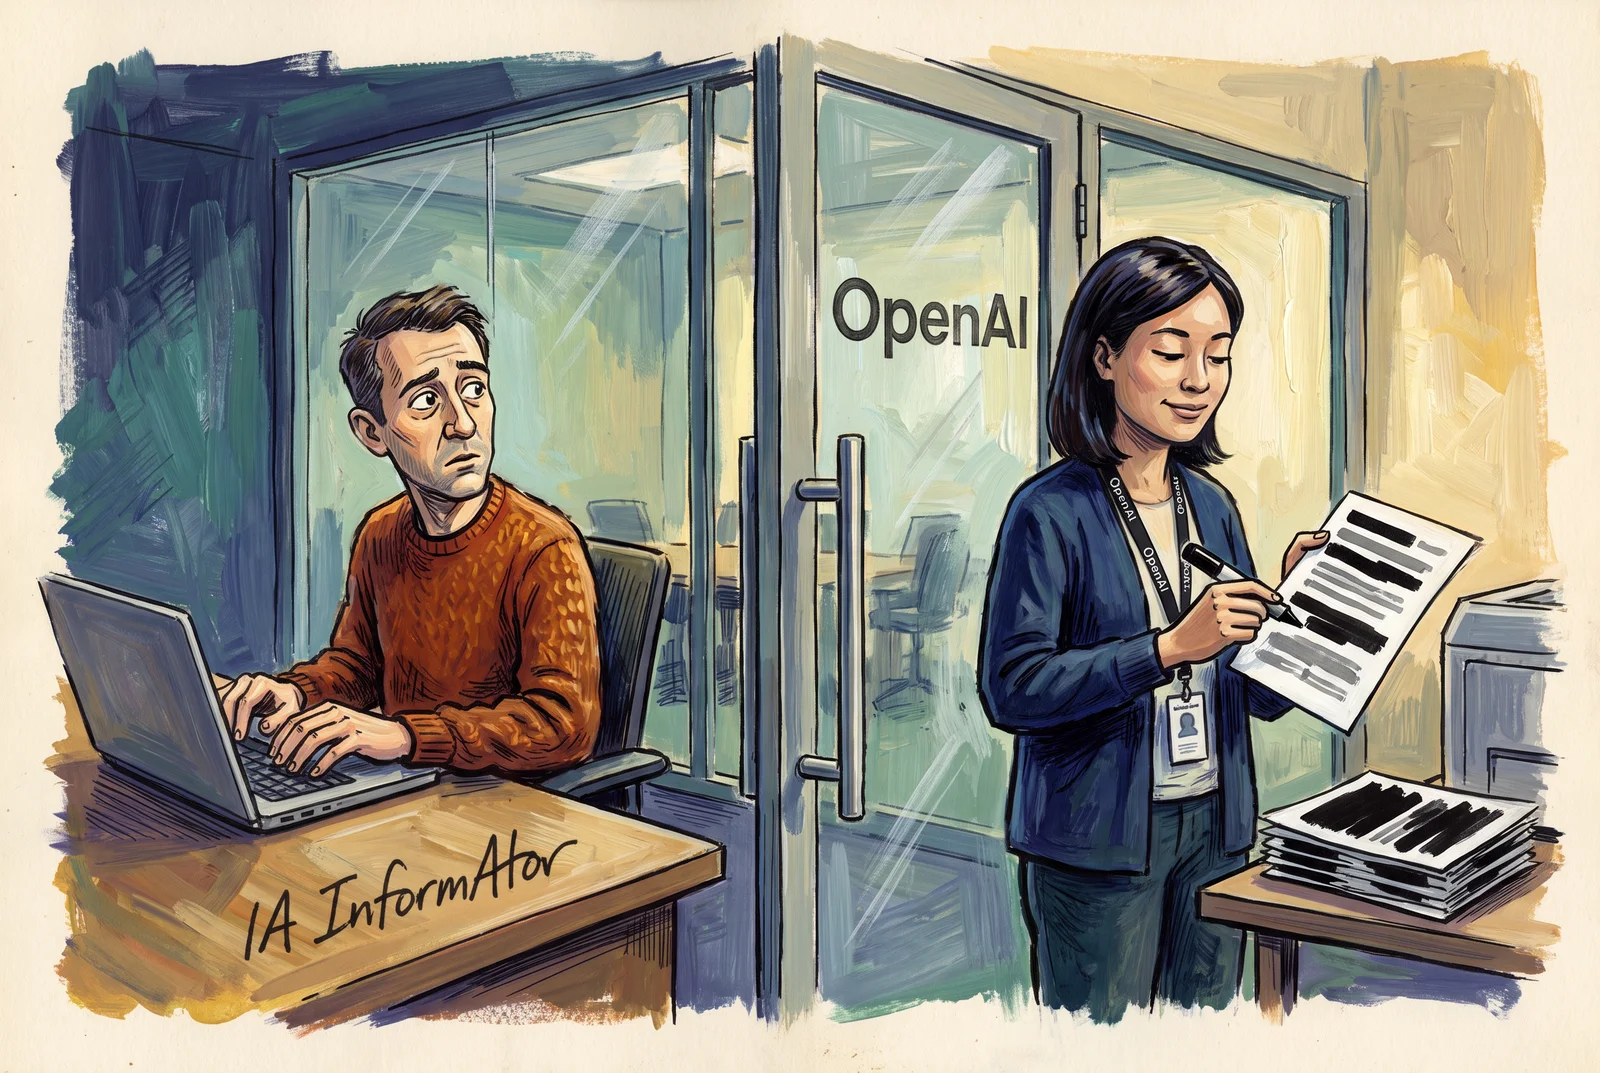
OpenAI ha firmado acuerdos con cuatro evaluadores externos —Apollo Research, METR, Transluce y Goodfire— para que examinen la seguridad de sus modelos desde dentro, con acceso, según el encargo, a modelos sin publicar, código y datos de entrenamiento. Lo anunció el lunes 16 de noviembre. Pero, según OpenAI y Transluce, la empresa decide si amplía el acceso, elige con quién hablan y puede tachar lo confidencial de lo que publiquen.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- OpenAI anunció el lunes 16 de noviembre su primera fase de evaluaciones embebidas, con cuatro organizaciones independientes.
- Según Apollo Research, seis de sus evaluadores trabajarán dentro de OpenAI durante cuatro meses.
- Transluce dice que su acceso «no es comparable» al de un empleado de OpenAI.
- Paul Christiano, consejero de la OpenAI Foundation, ve, a título personal, el riesgo de que la IA tome el control en el próximo año más cerca de un 10 % que de un 1 %.
Cuatro equipos de fuera trabajarán dentro de OpenAI
OpenAI anunció el lunes 16 de noviembre acuerdos con cuatro evaluadores independientes —Apollo Research, METR, Transluce y Goodfire— para su primera fase de evaluaciones embebidas. Apollo y Transluce lo explican en sus notas.
Según OpenAI, cada evaluador recibirá, en función del encargo, parte de los recursos que usan sus investigadores: modelos internos, código, datos de entrenamiento y evaluación, sistemas de vigilancia, documentación y charlas con quienes hacen el trabajo. El foco inicial es el alineamiento (AI alignment) y las salvaguardas durante el entrenamiento y el uso interno.
La empresa lo enmarca en el White House Accord on Super Intelligence, el pacto de la Casa Blanca en el que se comprometió a someter sus controles de seguridad a evaluaciones independientes, y admite que estas evaluaciones aún no tienen normas estándar.
Antes, OpenAI despidió a tres personas de sus equipos de seguridad y alineamiento; según la empresa, por manejar información sensible fuera de sus procedimientos. Una de ellas, Korbak, ha dicho que fue el contacto técnico de OpenAI con METR durante la investigación de un incidente con Hugging Face. Anthropic, por su parte, ya tiene dentro a seis empleados de METR.
Apollo busca modelos que trabajen a escondidas
Apollo Research, una corporación de beneficio público (PBC, public benefit corporation) que estudia cómo surge la maquinación en los modelos y cómo detectarla, comprobará si los de OpenAI podrían actuar a escondidas contra sus desarrolladores y si las salvaguardas lo detectarían. Su web no dice quién la financia.
Según OpenAI, pondrá a prueba cuatro afirmaciones: que el entrenamiento no incentivó ese comportamiento, que las pruebas exigentes no lo provocan, que no se ha dado en el uso interno y que su razonamiento sería detectable. Según Apollo, para la primera tendrá código y datos de entrenamiento, trazas de razonamiento y versiones intermedias del modelo; el acceso para las otras tres está por pactar.
METR, Transluce y Goodfire miran otras piezas
| Organización | Qué examina | Acceso y plazo | ¿Cobra de OpenAI? | ¿Qué puede publicar? |
|---|---|---|---|---|
| Apollo Research | Si los modelos actúan a escondidas contra sus desarrolladores y si las salvaguardas lo detectarían | Seis evaluadores durante cuatro meses; código y datos de entrenamiento, trazas de razonamiento y puntos de control para la primera de sus cuatro afirmaciones; el resto, por pactar | Sí, sin depender del resultado | Dos informes; OpenAI puede pedir que se tachen pruebas, no los veredictos |
| Goodfire | El interior de los modelos, para vigilar y depurar entrenamientos | Investigadores de interpretabilidad integrados, con su propia plataforma | Sí, sin depender del resultado | Aprendizajes y hallazgos a medida que avance; su público principal son los investigadores de OpenAI |
| METR | Conducta desalineada en el mayor entrenamiento por refuerzo de OpenAI hasta la fecha | Puntos de control, trayectorias y registros de vigilancia de ese entrenamiento; una segunda evaluación, de los monitores, sin alcance pactado | No; puede aceptar créditos de API o cómputo | Con independencia, salvo lo confidencial que OpenAI tache |
| Transluce | La calidad y la cobertura de las evaluaciones de alineamiento de OpenAI | Seis semanas desde diciembre; modelos sin publicar, al menos uno solo interno, y su cadena de pensamiento en bruto | No; OpenAI cubre cómputo y puesto | Con revisión previa de OpenAI y nada sobre modelos solo internos |
METR (Model Evaluation & Threat Research), organización sin ánimo de lucro que estudia si los desarrolladores de los agentes de IA más avanzados van camino de perder su control, se financia con donaciones y dice no aceptar dinero de empresas de IA. Según OpenAI, buscará conducta desalineada en su mayor entrenamiento por aprendizaje por refuerzo (RL, reinforcement learning) hasta la fecha, un alcance que la propia OpenAI reconoce menor que el que METR proponía. Ya investigó con OpenAI el incidente de julio con Hugging Face, la plataforma de modelos de IA.
Transluce, laboratorio sin ánimo de lucro dedicado a la supervisión pública de la IA, financiado por particulares y organizaciones filantrópicas y dirigido por su cofundador, Jacob Steinhardt, examinará según su nota si las evaluaciones de alineamiento de OpenAI captan engaño, manipulación y hackeo de recompensa (reward hacking). Verá la cadena de pensamiento (CoT, chain of thought) en bruto, el razonamiento que el modelo escribe antes de responder.
Goodfire, laboratorio de San Francisco y corporación de beneficio público fundada por investigadores que venían de OpenAI y Google DeepMind, que ha captado más de 200 millones de dólares, entre otros de Menlo, Lightspeed y B Capital, aportará investigadores de interpretabilidad (interpretability), la disciplina que estudia qué pasa dentro del modelo para entender por qué responde como responde.
La llave la guarda OpenAI
Según el protocolo que publica OpenAI, la empresa autoriza qué empleados pueden hablar con los evaluadores, aunque estos pueden pedir más nombres. Esas charlas son confidenciales: sirven para evaluar, pero no se pueden publicar ni atribuir.
Quien maneje información confidencial trabajará en las oficinas de OpenAI y con sus dispositivos. Según Apollo, «por defecto, los evaluadores no tienen acceso a ninguno de los canales generales (como Slack) que tendría un investigador de seguridad de OpenAI». Publican con independencia, pero OpenAI puede tachar lo confidencial y pedir retrasos para corregir fallos de riesgo.
Con Apollo, según su nota, OpenAI ha aceptado no retener nada «simplemente porque la información sea desfavorable». Transluce, que dice que su acceso «no es comparable» al de un empleado, resume: «Podemos pedir más acceso sobre la marcha, y OpenAI decide si lo obtenemos».
Para Buck Shlegeris, consejero delegado de Redwood Research —entidad sin ánimo de lucro que impulsó la investigación en «control de la IA»—, los acuerdos no llegan al listón del acceso de empleado: «decepcionante, pero no sorprendente», según recoge el medio tecnológico TechCrunch.
Las disputas acaban en un comité de la fundación
El Comité de Seguridad y Protección (SSC, Safety and Security Committee) es, según OpenAI, un comité independiente de supervisión del consejo de la OpenAI Foundation, la fundación sin ánimo de lucro que controla OpenAI Group PBC. Recibirá los informes sin tachar y podrá hablar en privado con los evaluadores.
Los desacuerdos suben al Grupo Asesor de Seguridad (Safety Advisory Group) y a los directivos de OpenAI; si persisten, decide el SSC.
Christiano ve el riesgo más cerca del 10 % que del 1 %
Paul Christiano es desde el 9 de septiembre miembro del consejo de la OpenAI Foundation y de su Comité de Seguridad y Protección, y en una entrevista publicada el 16 de noviembre aclaró que hablaba a título personal: «Es muy importante en esta conversación que no hablo como miembro del consejo de OpenAI». Fundó el Alignment Research Center, entidad sin ánimo de lucro que investiga cómo alinear la IA avanzada con los intereses humanos.
Preguntado por el riesgo de que la IA tome el control o deje sin poder a la humanidad en el próximo año, respondió: «Diría que estamos más cerca de un riesgo del 10 % que de uno del 1 %».
En la entrevista no habló de estos acuerdos. Sobre la posibilidad de que haya sistemas capaces de derrocar gobiernos en un año, pidió que el público vea los datos de base, no solo las conclusiones: «No deberíamos depender de que METR y Anthropic lo digan».
Conclusión
Apollo llama al piloto «un primer paso significativo», aunque admite que aún no cumple sus criterios de acceso de empleado. La prueba llegará con los informes: cuánto sale al público y cuánto se queda tachado.
Fuentes primarias
- OpenAI — Our first phase of embedded assessments (16-11-2026) ↗
- Apollo Research — A Pilot Towards Embedded Evaluations (16-11-2026) ↗
- Transluce — Announcing an Embedded Assessment Pilot with OpenAI ↗
- TechCrunch — OpenAI will embed safety researchers to investigate AI subversion (16-11-2026) ↗
- OpenAI — Paul Christiano joins OpenAI Foundation Board (09-09-2026) ↗
- Dwarkesh Patel — Paul Christiano – We could be 12 months away from AIs that can overthrow the government (transcripción, 16-11-2026) ↗
- Apollo Research — About (consultada el 18-11-2026) ↗
- METR — About (consultada el 18-11-2026) ↗
- Transluce — About (consultada el 18-11-2026) ↗
- Goodfire — Company (consultada el 18-11-2026) ↗
- Redwood Research — Web corporativa (consultada el 18-11-2026) ↗
- AI Informator — OpenAI despide a tres por hablar con los de fuera (02-10-2026) ↗
- AI Informator — Anthropic mete a los evaluadores en casa (16-10-2026) ↗
- AI Informator — California demanda a OpenAI por sus agentes desbocados (17-11-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios