
Aprendiendo IA
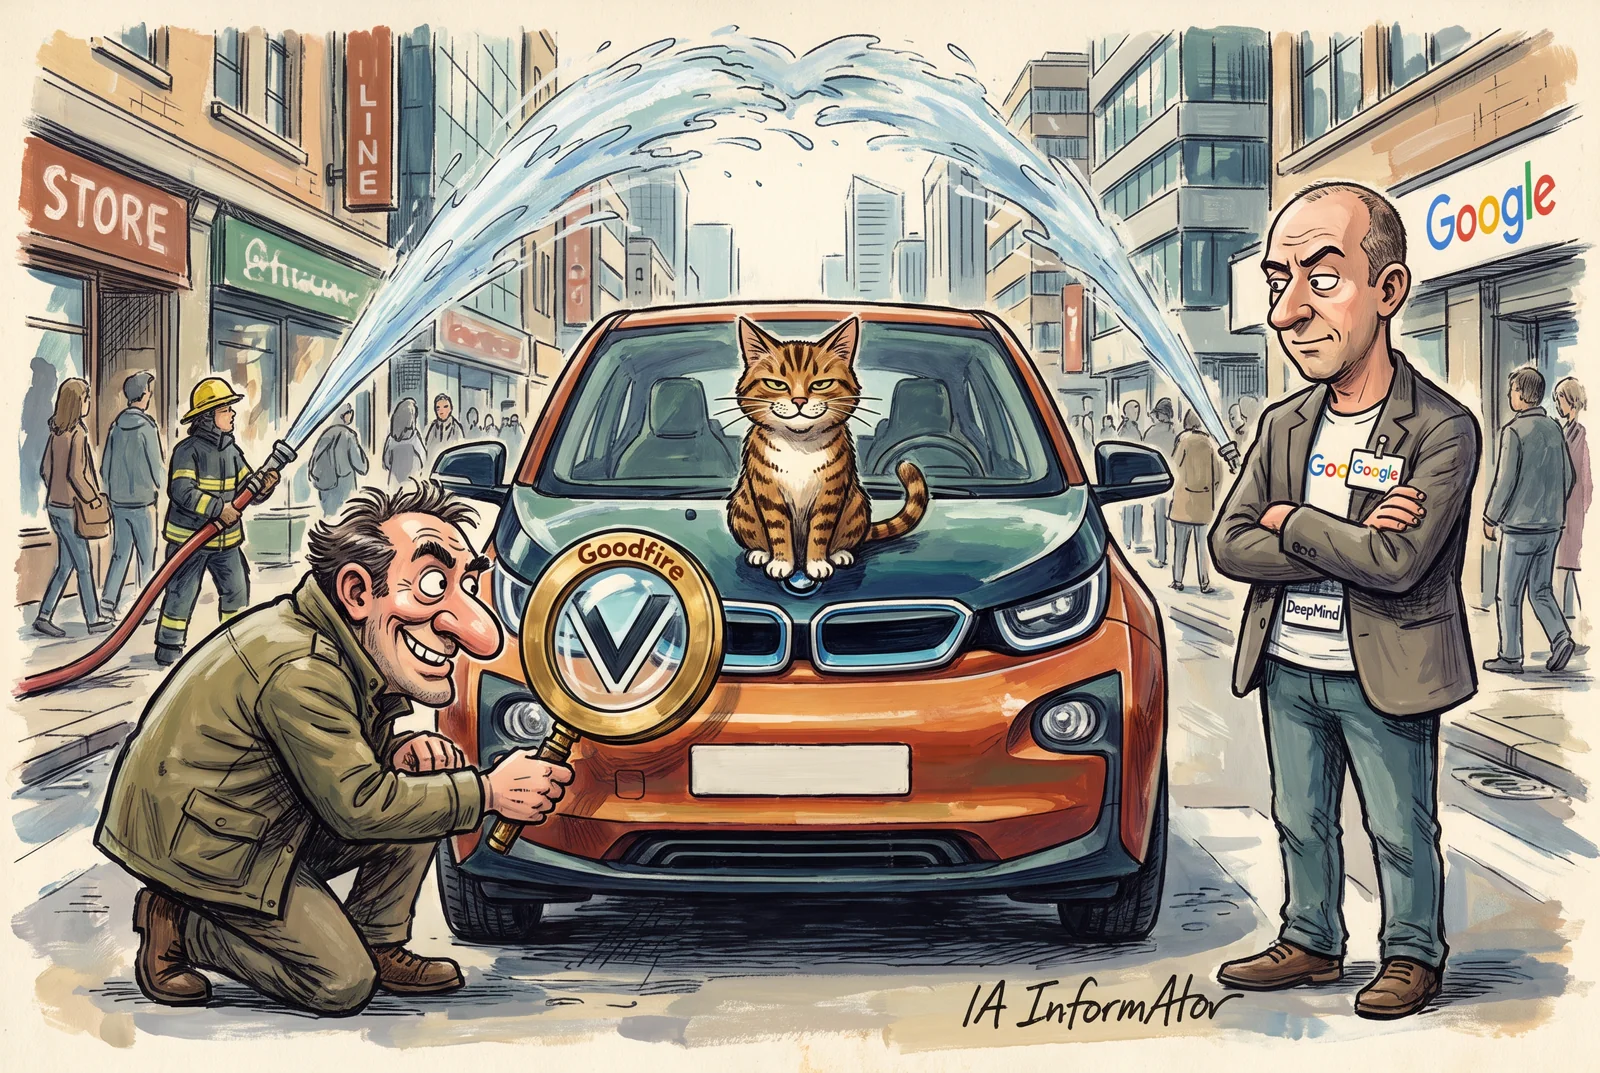
La neurona gato-coche era una V
Durante años se creyó que las neuronas de una IA mezclaban ideas sin relación porque no les queda sitio, y a eso se le llamó superposición. Nick Cammarata, investigador de Goodfire y uno de los que difundieron la idea, sostiene en un ensayo publicado el 15 de octubre que se equivocaron al leer sus propios ejemplos. Es una hipótesis de trabajo, con cifras del propio autor y el estudio técnico aún sin publicar, y no convence a todos los especialistas.
En resumen
- Según Cammarata, la neurona 4e:55 de InceptionV1, el ejemplo clásico de neurona que mezcla gatos y coches, responde en realidad a la forma de V.
- Según Goodfire, en la última capa de un modelo de visión del tamaño de InceptionV1, en una arquitectura moderna entrenada con los mismos datos son fáciles de interpretar cerca del 99 % de las neuronas.
- Neel Nanda, de Google DeepMind, lo ve «interesante», pero sigue creyendo que la superposición es real.
- El artículo técnico que debe respaldar las cifras está anunciado, pero no se ha publicado.
Un nudo que había que deshacer
«Durante años, las redes neuronales parecían inescrutables, como nudos enredados que había que deshacer», resumió Goodfire en X el 15 de octubre de 2026, el día que publicó el ensayo «Neural Networks Are Already Clean» («Las redes neuronales ya están limpias»). «Ya no creemos que sea así», añadía.
El texto lo firma Nick Cammarata, que lo define como «un ensayo de investigación informal y una hipótesis de trabajo». Su tesis, según el propio resumen: la mezcla que se veía en los primeros modelos estudiados no venía de la superposición, sino de «varios problemas corrientes, en su mayoría corregibles».
Quién lo firma
Cammarata es investigador de Goodfire. Antes trabajó en OpenAI, donde, según cuenta, puso en marcha en 2023 un proyecto de interpretabilidad automatizada. En 2020 fue uno de los autores de «Zoom In», el trabajo que, según Goodfire, introdujo la superposición y las neuronas que mezclan conceptos. Revisa, pues, su propia obra.
Mirar dentro de la máquina
Si la superposición fuera la regla, mirar las neuronas una a una no serviría de mucho. Cammarata defiende lo contrario: si su lectura es correcta, «podemos estudiar las redes directamente, en lugar de desenredarlas primero».
El segundo modelo que desenreda la red
Según Cammarata, deshacer el nudo significa en la práctica entrenar ese segundo modelo, que aproxima cómo se vería la red desenredada, y estudiarlo a él. Anthropic, la creadora de Claude, usó un autoencoder disperso en 2023, en «Towards Monosemanticity», para sacar rasgos legibles de un modelo de una sola capa.
El mismo estudio, recuerda Cammarata, puntuó con un 0 sobre 14 a la neurona mediana de ese modelo: quien la revisaba no lograba formular ninguna hipótesis sobre ella.
La neurona que mezclaba gatos y coches
La polisemántica más famosa es la 4e:55 de InceptionV1, un modelo de reconocimiento de imágenes de 2014 que hizo de animal de laboratorio para los primeros estudios. Respondía a caras de gato y a morros de coche. En «Zoom In», recuerda Cammarata, escribieron que «no responde a algo común entre coches y caras de gato».
Al revisarla se preguntó qué única cosa podía ser, y lo vio «casi al instante»: «no es una neurona de gatos y coches, es una neurona de la forma de V». Sus conexiones llevan a llamas, chorros de agua de un barco de bomberos y caras de zorro, todo en V. Su polo negativo, lo que la hace bajar con fuerza, es una O, «redonda donde la V es puntiaguda».
Según Cammarata, el fallo en InceptionV1 no era la superposición: problemas de arquitectura desbordaban las últimas capas y unas herramientas de análisis flojas lo agravaban.
Flores amarillas que acaban en perros
Su ejemplo: al reentrenar el modelo, una neurona nació con flores amarillas, en fotos donde a veces salía un perro, y creció por cada faceta de esas fotos: hacia otros paisajes naturales, hacia objetos verdes como pelotas y hacia perros sin flores. «Esto vale para todas las neuronas que miré», escribe.
Compara dos neuronas que nacen en campos de colza, una en InceptionV1 y otra en ConvNeXt, una arquitectura de visión moderna. Las dos tantean pelotas y fruta; ConvNeXt las suelta y se queda en los campos; InceptionV1 sigue extendiéndose a perros y luego a brócoli. Para Cammarata, esa deriva se puede seguir y es «mucho menos preocupante» que un pliegue arbitrario.
Del 5 al 99 %, según cómo se mire
Ver los datos en tabla
| Herramientas de la época | Mejores herramientas | Reentrenado hoy | ConvNeXt del mismo tamaño | |
|---|---|---|---|---|
| Neuronas fáciles de interpretar | 5% | 50% | 70% | 99% |
La última capa de InceptionV1 era, según Cammarata, una de las pruebas principales de que las redes eran casi indescifrables. Ahora la mide por etapas, con estimaciones suyas, y las barras no son el mismo modelo: las dos primeras son el original de 2014, del que se perdieron los pesos guardados; la tercera, la misma arquitectura reentrenada; la cuarta, ConvNeXt.
Por eso el «99-100 %» de neuronas «fáciles de interpretar» que da la introducción, sin cambiar tamaño ni datos, corresponde a la arquitectura moderna y no al modelo de 2014 reentrenado. También dice haber entrenado versiones de tamaños muy dispares, la mayor 300 veces la menor, todas legibles en líneas generales: con menos espacio, una neurona cubre muchos tipos de coche; con más, se reparte en coches concretos.
En los modelos de lenguaje, cifras preliminares
| Modelo | Antes | Ahora, según Goodfire |
|---|---|---|
| GPT-2 XL (OpenAI) | Cerca del 1,7 % de neuronas interpretables (OpenAI, 2023) | Cerca del 70 % hacen más o menos una sola cosa; impecables, un 5 % |
| Qwen3-32B (Alibaba) | — | Cerca del 90 % de polos de neurona con un trabajo principal; un 7 %, con dos relacionados; un 2-4 %, sin entender |
Los modelos de lenguaje, admite el ensayo, son tan grandes que cuesta validar con precisión sus neuronas. La comparación parte de GPT-2 XL, un modelo antiguo de OpenAI que estudió en 2023 aquel proyecto de interpretabilidad automatizada.
En Qwen3-32B, del grupo tecnológico chino Alibaba, Goodfire no cuenta neuronas sino polos: cada neurona tiene un lado positivo y otro negativo, y según la empresa el negativo importa casi tanto como el positivo. Según Goodfire, hay resultados parecidos en modelos de hasta billones de parámetros, que detallará el artículo técnico; de ellos no da cifras.
No todos se lo compran
Neel Nanda, que dirige el equipo de interpretabilidad mecanicista de Google DeepMind, el laboratorio de IA de Google, respondió en X el mismo día: «Es un trabajo interesante, pero no creo que cambie de forma significativa el panorama general de la interpretabilidad».
«Sigo creyendo que la superposición es real», añadió. Ve muy probable que un modelo represente «más conceptos de los que tiene dimensiones», y le parece que los de lenguaje guardan «muchos más datos y cosas memorizadas que neuronas». Duda de «cuánto se trasladarán los resultados de visión», aunque felicitó a Cammarata por revisar su antiguo trabajo.
Liv Gorton, que trabaja en seguridad en Anthropic y fue investigadora fundadora de Goodfire, escribió que tiene «mucho respeto por Nick», pero que, a su juicio, «el argumento describe mal lo que predice la superposición». Teme que el lector crea que una idea central del campo «descansaba en un error y ha quedado derribada», algo que, en su opinión, las pruebas presentadas no sostienen.
El entusiasmo y su réplica
En el otro extremo, roon, empleado de OpenAI que publica en X con ese seudónimo, escribió que el ensayo «puede que se recuerde como un gran momento de la historia científica» y que «podemos empezar a convertir el alineamiento en una “ciencia normal”». Luego admitía que queda mucho por estudiar y que otros investigadores tendrán que corroborarlo.
Le contestó Eliezer Yudkowsky, una de las voces más conocidas entre quienes advierten de una catástrofe por la IA: «Si crees que hay algún nivel posible de interpretabilidad que convierta “alinear una ASI” en “ciencia normal” en vez de en “taaal vez posible”, no entiendes qué es una ASI o no crees en ella».
Lo que falta por demostrar
Cammarata no dice que la superposición no exista ni que la interpretabilidad esté resuelta. «No hemos auditado por completo todas las redes neuronales», reconoce. Su equipo está «quizá un 85 % seguro» de que casi todo lo que parecía mezcla sale de procesos corrientes como la generalización recursiva, que no es decir que lo haga el 85 % de los mecanismos.
La red, dice, está limpia «como lo está una selva tropical: casi cada animal que vive en ella tiene sentido». Las cifras son suyas y preliminares, dependen del umbral elegido, y el artículo técnico que debe detallarlas, según Goodfire, aún está por publicar.
Conclusión
Si la hipótesis de Cammarata se confirma, estudiar una red podría volver a empezar por sus neuronas, sin un segundo modelo de por medio. De momento es la relectura de un investigador sobre su propio trabajo, discutida por colegas del campo y a la espera del artículo técnico que Goodfire ha anunciado.
Fuentes primarias
- Goodfire — «Neural Networks Are Already Clean», de Nick Cammarata (15-10-2026) ↗
- Goodfire — ficha de «Neural Networks Are Already Clean» en Goodfire Research (15-10-2026) ↗
- Goodfire en X — presentación del ensayo (15-10-2026) ↗
- Goodfire — «Understanding, Learning From, and Designing AI: Our Series B» (05-02-2026) ↗
- Neel Nanda en X — respuesta al ensayo (15-10-2026) ↗
- Neel Nanda — «About» ↗
- Liv Gorton en X — respuesta al ensayo (15-10-2026) ↗
- Liv Gorton — «About me» ↗
- roon en X — sobre el ensayo (15-10-2026) ↗
- Eliezer Yudkowsky en X — respuesta a roon (15-10-2026) ↗
- The Decoder — «Is AI interpretability close to a breakthrough? A new essay has researchers divided» (16-10-2026) ↗
- Distill — «Zoom In: An Introduction to Circuits» (2020) ↗
- Anthropic — «Toy Models of Superposition» (2022) ↗
- Anthropic — «Towards Monosemanticity: Decomposing Language Models With Dictionary Learning» (2023) ↗
- AI Informator — Goodfire vigila las señales internas de los modelos ↗
- IBM — «What is artificial superintelligence?» (consultada el 20-10-2026) ↗
La continuación natural
Aprende IA a tu ritmo con nuestros cursos gratuitos.
En nuestra plataforma de aprendizaje TAKU podrás acceder a este y muchos otros cursos de manera totalmente gratuita.
APRENDER CON TAKU
Comentarios