Aprendiendo IA
Policy gradient: cómo aprende una IA resolviendo 17 × 24
El policy gradient es la idea de la que salen la mayoría de los métodos con los que se entrena por refuerzo a un modelo de lenguaje. Tyler Romero lo derivó desde cero el 27 de septiembre de 2026 siguiendo una sola pregunta, «¿cuánto es 17 × 24?». Este curso breve recorre ese camino y acaba con un ejercicio de lápiz y papel.
En resumen
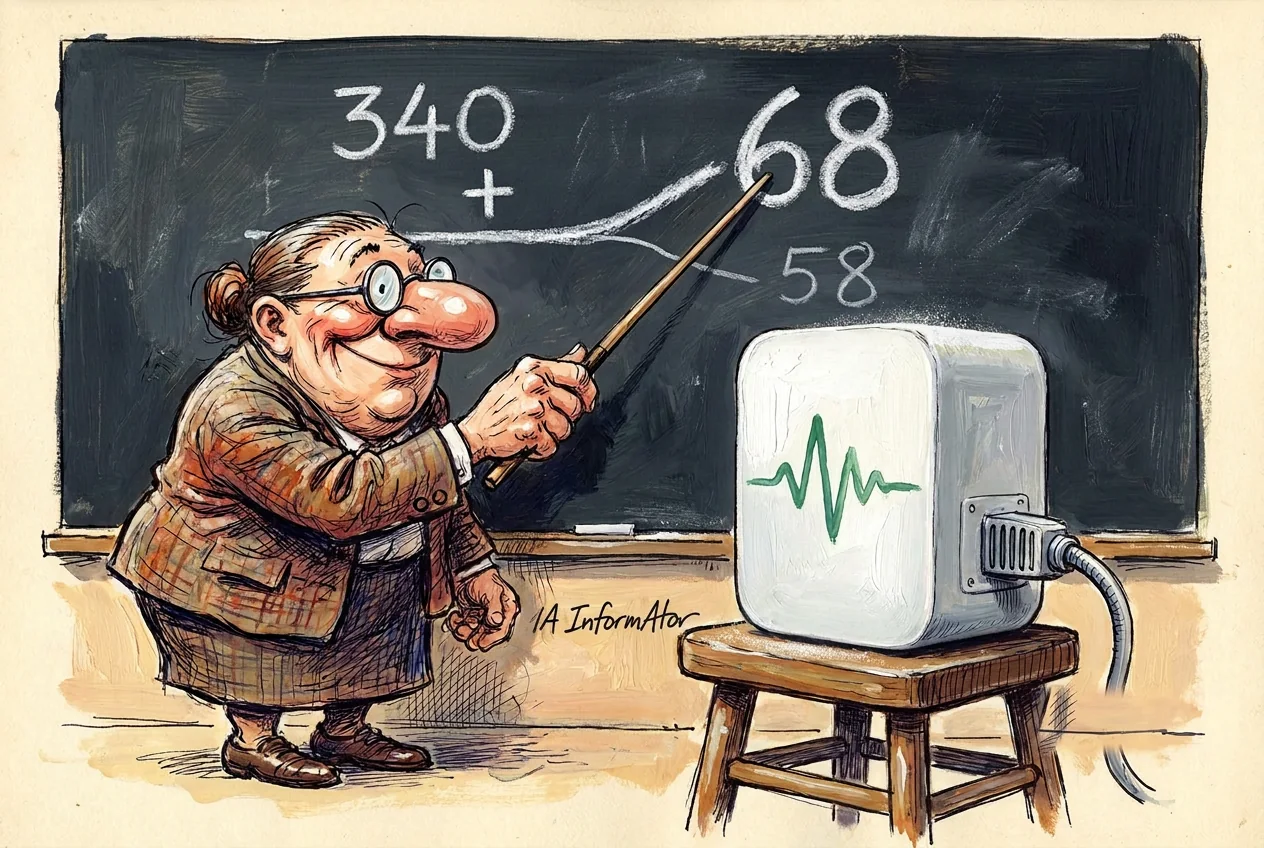
- Tras escribir «340 +», el modelo da un 0,82 de probabilidad a «68», que lleva a la respuesta correcta, y un 0,07 al error «58».
- Un verificador pone un 1 a la respuesta que llega a 408 y un 0 a cualquier otra; el entrenamiento busca subir la recompensa media.
- Con unos 150.000 tokens de vocabulario, una respuesta de 100 tokens tiene más de 10 elevado a 500 posibilidades, así que se muestrean unas pocas.
- Con dos aciertos y dos fallos, la media del grupo es 0,5: los aciertos reciben +0,5 y los fallos −0,5, y así funciona la línea base de GRPO.
Una sola pregunta basta para entender el policy gradient
Tyler Romero, que según su propia web trabaja en el posentrenamiento de modelos en el equipo de superinteligencia de Microsoft AI, la división de IA de Microsoft, publicó el 27 de septiembre de 2026 un tutorial visual que deriva el policy gradient desde cero. Su punto de partida: la mayoría de los algoritmos de refuerzo que se usan para entrenar modelos de lenguaje son elaboraciones de esta única idea.
Sirve para leer noticias como la de los agentes atribuidos a OpenAI en el portal estadístico de la ONU o la pausa de OpenAI en el entrenamiento de sus modelos más capaces: son modelos que aprenden persiguiendo una recompensa. Este curso no explica esos casos ni los relaciona con el método; explica el mecanismo.
El modelo elige cada token como quien tira un dado cargado
| Token siguiente | Adónde lleva | Probabilidad |
|---|---|---|
| 68 | 340 + 68 = 408, la respuesta correcta | 0,82 |
| 58 | Un despiste que acaba en 398 | 0,07 |
| Resto del vocabulario | Otras continuaciones | Pequeñas cantidades |
La pregunta es «¿cuánto es 17 × 24? Muestra el desarrollo y da una respuesta final». El modelo empieza a escribir «17 × 24 = 17 × 20 + 17 × 4 = 340 +» y llega a un hueco. Ahí reparte la probabilidad del siguiente token, y el 0,82 de «68» frente al 0,07 de «58» es uno de los puntos donde la cuenta se bifurca.
Generar una respuesta es recorrer un camino en un árbol de continuaciones posibles, y la probabilidad del camino entero es el producto de las de cada paso: en el ejemplo del autor, los tres primeros tokens valen 0,6 × 0,9 × 0,7.
Un verificador pone un 1 o un 0
Cuando el modelo termina, la respuesta pasa por el verificador: la que llega a 408 se lleva un 1 y la que llega a 398, un 0. El entrenamiento busca los pesos que hacen máxima la recompensa media. Y un detalle que lo explica casi todo: los pesos solo deciden qué respuestas salen, no cómo se puntúa cada una.
La recompensa media no se puede derivar sin más
La recompensa media es una suma sobre todas las respuestas posibles, y no hay manera de escribirlas todas: con un vocabulario de unos 150.000 tokens, una respuesta de solo 100 tokens tiene más de 10 elevado a 500 posibilidades.
Lo habitual sería estimarla con unas cuantas muestras, pero eso no se puede derivar: cada token sorteado es un número entero que cambia de golpe o no cambia, y la nota sale de un verificador, una prueba unitaria o una persona, por los que no pasa ningún gradiente.
REINFORCE: afinar el modelo con sus propias respuestas
Un truco matemático de una línea, el de la derivada del logaritmo, convierte el gradiente imposible en una media sobre respuestas muestreadas del propio modelo, y esa media sí se puede calcular. Cada respuesta aporta una dirección, la que la hace más probable, y un peso, su recompensa.
La frase con la que el autor lo resume: el policy gradient es un ajuste fino supervisado sobre tus propias muestras, ponderado por la recompensa. Con recompensas de 1 y 0 es literalmente entrenar solo con las respuestas correctas, así que las incorrectas nunca se castigan directamente: solo pierden cuota.
Cuatro intentos, dos aciertos y una actualización
| Rollout | Qué hizo | Recompensa | Ventaja con la media del grupo (0,5) | Probabilidad antes → después |
|---|---|---|---|---|
| A | Error de cálculo | 0 | −0,5 | Apenas cambia |
| B | Llega a 408 | 1 | +0,5 | 0,22 → 0,27 |
| C | Llega a 408 por otro camino | 1 | +0,5 | 0,03 → 0,05 |
| D | Da una estimación | 0 | −0,5 | Apenas cambia |
El autor lanza cuatro rollouts. A comete un error de cálculo y D se queda en una estimación: los dos sacan 0. B y C llegan a 408 y sacan 1. Tras una actualización, la probabilidad de B sube de 0,22 a 0,27 y la de C de 0,03 a 0,05.
Lo que ganan B y C sale de otra parte, sobre todo de respuestas que nadie muestreó, porque la probabilidad total es 1. A apenas cambia porque comparte con B todo el camino hasta «340 +». El autor avisa de que las cifras son ilustrativas.
Todos los tokens cobran la misma recompensa
En A, que sacó 0, no se actualiza nada: ni sus pasos iniciales correctos ni el despiste «58». En B, con 1, se llevan el premio completo también los tokens de relleno.
Lo que cambia de un token a otro es cuánto se mueve. El empujón sobre su propio logit es 1 menos la probabilidad, lo que le faltaba al modelo para estar seguro, así que los tokens dudosos de B, como 17, 24 o 68, reciben empujones grandes, y los que el modelo ya daba por hechos casi ninguno.
Restar una vara de medir no cambia el rumbo y quita ruido
Si las cuatro respuestas aciertan, el gradiente verdadero es cero, y aun así cada muestra empuja al azar sus propias probabilidades hacia arriba. Con una línea base de 1, cada término se anula y el ruido desaparece. La elección habitual es la recompensa esperada de cada pregunta, porque unas son mucho más fáciles que otras.
GRPO usa la media del grupo como línea base
En el ejemplo, la media del grupo es 0,5. B y C reciben una ventaja de +0,5 y se empujan hacia arriba; A y D, de −0,5, y se empujan hacia abajo. Ahora los fallos sí se castigan, y en el tramo que comparten A y B los dos empujones se cancelan.
Las preguntas en las que todas aciertan, o todas fallan, no aportan nada. En código son pocas líneas de PyTorch: agrupar las recompensas por pregunta, restarles la media del grupo, sumar la probabilidad logarítmica de los tokens de cada respuesta y devolver, con el signo cambiado, la media de ventaja por probabilidad logarítmica. La mayoría de los algoritmos actuales para modelos de lenguaje parten de esa pérdida y le añaden recortes, máscaras o reponderaciones.
El ejercicio: rehaz la tabla a mano
Solo hace falta lápiz o una hoja de cálculo. Nada de esto pide una tarjeta gráfica.
Paso 1. Copia los cuatro rollouts con su recompensa: A 0, B 1, C 1, D 0.
Paso 2. Calcula la media del grupo y réstasela a cada recompensa. Comprueba que te salen +0,5 para B y C y −0,5 para A y D, y que las cuatro ventajas suman cero.
Paso 3. Cambia el escenario: que acierten las cuatro, y después que fallen las cuatro. Verás que todas las ventajas valen cero, y ahí tienes por qué esas preguntas no enseñan nada.
Paso 4. Prueba con tres aciertos y un fallo. Fíjate en que el fallo solitario recibe un empujón hacia abajo mayor que cada acierto hacia arriba, y piensa por qué tiene sentido.
La letra pequeña: el modelo que responde no es el que aprende
El autor cierra con una advertencia. En la práctica, las respuestas no las genera el programa que entrena, sino un motor de inferencia aparte, como vLLM o SGLang. Se supone que los dos calculan lo mismo, pero pocas veces lo hacen: pueden trabajar con distinta precisión numérica y, en montajes asíncronos, el motor puede estar sirviendo los pesos de hace unas cuantas actualizaciones.
Así que las respuestas salen de un modelo algo distinto del que se entrena, y en esa diferencia, escribe Romero, es donde empiezan los problemas.
Conclusión
Detrás de las siglas de los modelos que razonan hay una idea corta: generar varias respuestas, puntuarlas y hacer más probables las que salieron mejor de lo esperado. La cuenta de 17 × 24 deja a la vista sus dos límites: todos los tokens cobran lo mismo aunque no todos lo merezcan, y las fórmulas suponen que quien responde es el mismo modelo que aprende.
Fuentes primarias
La continuación natural
Aprende IA a tu ritmo con nuestros cursos gratuitos.
En nuestra plataforma de aprendizaje TAKU podrás acceder a este y muchos otros cursos de manera totalmente gratuita.
APRENDER CON TAKU
Comentarios