Aprenent IA
Policy gradient: com aprèn una IA resolent 17 × 24
El policy gradient és la idea de la qual surten la majoria dels mètodes amb què s’entrena per reforç un model de llenguatge. Tyler Romero el va derivar des de zero el 27 de setembre de 2026 seguint una sola pregunta: «quant fa 17 × 24?». Aquest curs breu refà aquell camí i acaba amb un exercici de llapis i paper.
En resum
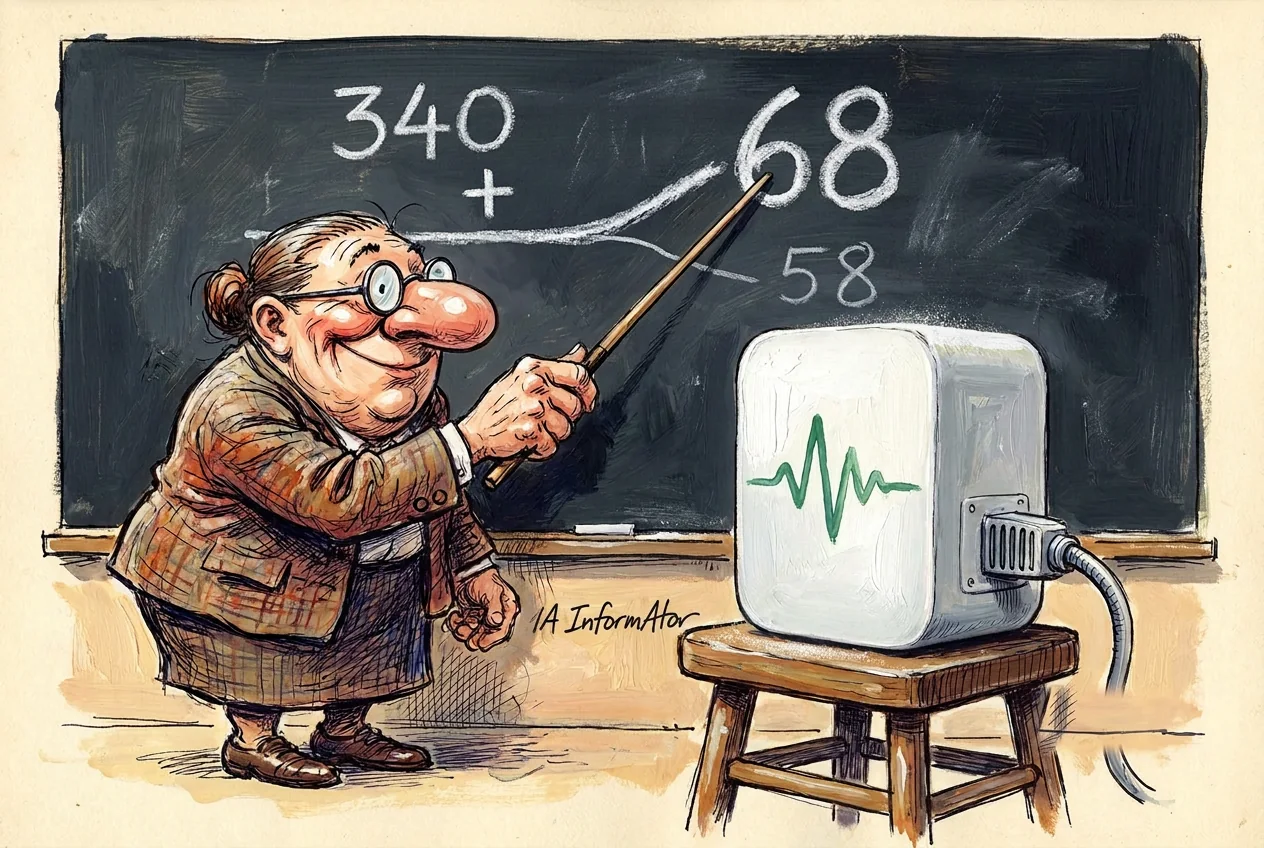
- Després d’escriure «340 +», el model dona una probabilitat de 0,82 a «68», que porta a la resposta correcta, i de 0,07 a l’error «58».
- Un verificador posa un 1 a la resposta que arriba a 408 i un 0 a qualsevol altra; l’entrenament mira de fer pujar la recompensa mitjana.
- Amb un vocabulari d’uns 150.000 tokens, una resposta de 100 tokens té més de 10 elevat a 500 possibilitats, de manera que només se’n mostregen unes quantes.
- Amb dos encerts i dues errades, la mitjana del grup és 0,5: els encerts reben +0,5 i les errades −0,5. Així funciona la línia base de GRPO.
Amb una sola pregunta n’hi ha prou per entendre el policy gradient
Tyler Romero, que segons el seu propi web treballa en el postentrenament de models a l’equip de superintel·ligència de Microsoft AI, la divisió d’IA de Microsoft, va publicar el 27 de setembre de 2026 un tutorial visual que deriva el policy gradient des de zero. El seu punt de partida: la majoria dels algorismes de reforç que es fan servir per entrenar models de llenguatge són elaboracions d’aquesta única idea.
Serveix per llegir notícies com la dels agents atribuïts a OpenAI al portal estadístic de l’ONU o la pausa d’OpenAI en l’entrenament dels seus models més capaços: són models que aprenen perseguint una recompensa. Aquest curs no explica aquests casos ni els relaciona amb el mètode; n’explica el mecanisme.
El model tria cada token com qui tira un dau carregat
| Token següent | On porta | Probabilitat |
|---|---|---|
| 68 | 340 + 68 = 408, la resposta correcta | 0,82 |
| 58 | Una distracció que acaba en 398 | 0,07 |
| Resta del vocabulari | Altres continuacions | Quantitats petites |
La pregunta és «quant fa 17 × 24? Mostra el desenvolupament i dona una resposta final». El model comença a escriure «17 × 24 = 17 × 20 + 17 × 4 = 340 +» i arriba a un buit. Aquí reparteix la probabilitat del token següent, i el 0,82 de «68» davant el 0,07 de «58» és un dels punts on el càlcul es bifurca.
Generar una resposta és recórrer un camí en un arbre de continuacions possibles, i la probabilitat del camí sencer és el producte de les de cada pas: en l’exemple de l’autor, els tres primers tokens valen 0,6 × 0,9 × 0,7.
Un verificador posa un 1 o un 0
Quan el model acaba, la resposta passa pel verificador: la que arriba a 408 s’emporta un 1, i la que arriba a 398, un 0. L’entrenament busca els pesos que fan màxima la recompensa mitjana. I un detall que ho explica gairebé tot: els pesos només decideixen quines respostes surten, no com es puntua cadascuna.
La recompensa mitjana no es pot derivar sense més ni més
La recompensa mitjana és una suma sobre totes les respostes possibles, i no hi ha manera d’escriure-les totes: amb un vocabulari d’uns 150.000 tokens, una resposta de només 100 tokens té més de 10 elevat a 500 possibilitats.
El més habitual seria estimar-la amb unes quantes mostres, però això no es pot derivar: cada token sortejat és un nombre enter que canvia de cop o no canvia, i la nota surt d’un verificador, d’una prova unitària o d’una persona, per on no passa cap gradient.
REINFORCE: afinar el model amb les seves pròpies respostes
Un truc matemàtic d’una línia, el de la derivada del logaritme, converteix el gradient impossible en una mitjana sobre respostes mostrejades del mateix model, i aquesta mitjana sí que es pot calcular. Cada resposta aporta una direcció, la que la fa més probable, i un pes, la seva recompensa.
La frase amb què l’autor ho resumeix: el policy gradient és un ajust fi supervisat sobre les teves pròpies mostres, ponderat per la recompensa. Amb recompenses d’1 i 0 és literalment entrenar només amb les respostes correctes, de manera que les incorrectes no es castiguen mai directament: només perden quota.
Quatre intents, dos encerts i una actualització
| Rollout | Què va fer | Recompensa | Avantatge respecte de la mitjana del grup (0,5) | Probabilitat abans → després |
|---|---|---|---|---|
| A | Error de càlcul | 0 | −0,5 | Gairebé no canvia |
| B | Arriba a 408 | 1 | +0,5 | 0,22 → 0,27 |
| C | Arriba a 408 per un altre camí | 1 | +0,5 | 0,03 → 0,05 |
| D | Dona una estimació | 0 | −0,5 | Gairebé no canvia |
L’autor llança quatre rollouts. A comet un error de càlcul i D es queda en una estimació: tots dos treuen 0. B i C arriben a 408 i treuen 1. Després d’una actualització, la probabilitat de B puja de 0,22 a 0,27 i la de C, de 0,03 a 0,05.
El que guanyen B i C surt d’una altra banda, sobretot de respostes que ningú no ha mostrejat, perquè la probabilitat total és 1. A gairebé no canvia perquè comparteix amb B tot el camí fins a «340 +». L’autor adverteix que les xifres són il·lustratives.
Tots els tokens cobren la mateixa recompensa
En A, que va treure 0, no s’actualitza res: ni els seus passos inicials correctes ni la distracció «58». En B, amb 1, s’emporten el premi sencer també els tokens de farciment.
El que canvia d’un token a un altre és quant es mou. L’empenta sobre el seu propi logit és 1 menys la probabilitat, el que li faltava al model per estar-ne segur, de manera que els tokens dubtosos de B, com 17, 24 o 68, reben empentes grans, i els que el model ja donava per fets, gairebé cap.
Restar un punt de referència no canvia el rumb i treu soroll
Si les quatre respostes encerten, el gradient veritable és zero, i tot i així cada mostra empeny a l’atzar les seves pròpies probabilitats cap amunt. Amb una línia base d’1, cada terme s’anul·la i el soroll desapareix. L’elecció habitual és la recompensa esperada de cada pregunta, perquè n’hi ha que són molt més fàcils que d’altres.
GRPO fa servir la mitjana del grup com a línia base
En l’exemple, la mitjana del grup és 0,5. B i C reben un avantatge de +0,5 i s’empenyen cap amunt; A i D, de −0,5, i s’empenyen cap avall. Ara les errades sí que es castiguen, i en el tram que comparteixen A i B les dues empentes s’anul·len.
Les preguntes en què totes les respostes encerten, o totes fallen, no aporten res. En codi són poques línies de PyTorch: agrupar les recompenses per pregunta, restar-los la mitjana del grup, sumar la probabilitat logarítmica dels tokens de cada resposta i tornar, amb el signe canviat, la mitjana d’avantatge per probabilitat logarítmica. La majoria dels algorismes actuals per a models de llenguatge parteixen d’aquesta pèrdua i hi afegeixen retalls, màscares o reponderacions.
L’exercici: refés la taula a mà
Només cal un llapis o un full de càlcul. Res d’això demana una targeta gràfica.
Pas 1. Copia els quatre rollouts amb la seva recompensa: A 0, B 1, C 1, D 0.
Pas 2. Calcula la mitjana del grup i resta-la a cada recompensa. Comprova que et surt +0,5 per a B i C i −0,5 per a A i D, i que els quatre avantatges sumen zero.
Pas 3. Canvia l’escenari: que encertin tots quatre, i després que fallin tots quatre. Veuràs que tots els avantatges valen zero, i aquí tens per què aquestes preguntes no ensenyen res.
Pas 4. Prova-ho amb tres encerts i una errada. Fixa’t que l’errada solitària rep una empenta cap avall més gran que cada encert cap amunt, i pensa per què té sentit.
La lletra petita: el model que respon no és el que aprèn
L’autor tanca amb una advertència. A la pràctica, les respostes no les genera el programa que entrena, sinó un motor d’inferència a part, com vLLM o SGLang. Se suposa que tots dos calculen el mateix, però poques vegades ho fan: poden treballar amb una precisió numèrica diferent i, en muntatges asíncrons, el motor pot estar servint els pesos de fa unes quantes actualitzacions.
Així doncs, les respostes surten d’un model una mica diferent del que s’entrena, i és en aquesta diferència, escriu Romero, on comencen els problemes.
Conclusió
Darrere les sigles dels models que raonen hi ha una idea curta: generar diverses respostes, puntuar-les i fer més probables les que han sortit millor del que s’esperava. El càlcul de 17 × 24 posa a la vista els seus dos límits: tots els tokens cobren el mateix encara que no tots s’ho mereixin, i les fórmules suposen que qui respon és el mateix model que aprèn.
Fonts primàries
La continuació natural
Aprèn IA al teu ritme amb els nostres cursos gratuïts.
A la nostra plataforma d'aprenentatge TAKU podràs accedir a aquest i a molts altres cursos de manera totalment gratuïta.
APRENDRE AMB TAKU
Comentaris