Ciencia
OpenAI suelta 722 manuscritos, y ni ella los avala todos
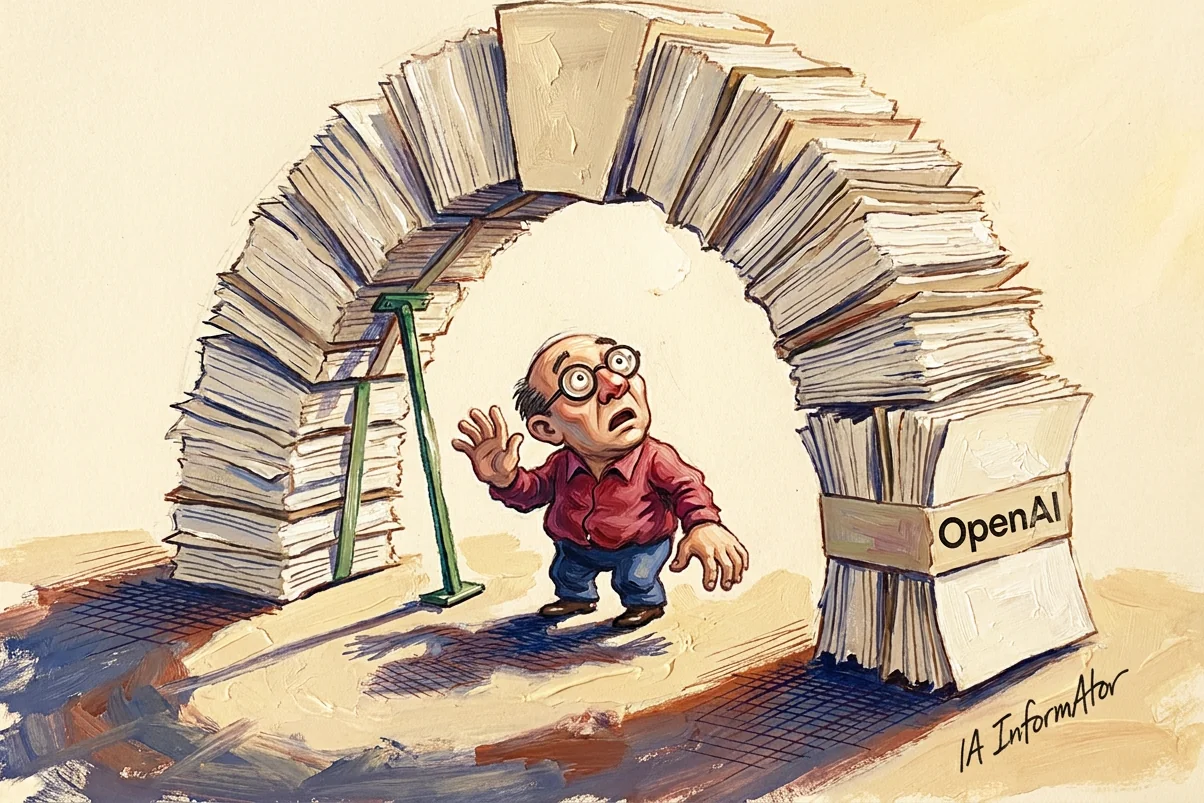
OpenAI publicó el 6 de octubre de 2026 un catálogo con 722 manuscritos de matemáticas producidos por un modelo interno que no ha lanzado, y advirtió por escrito de que «algunos de los resultados sin formalizar podrían tener problemas». Al día siguiente retiró tres por un error de signo, dejó el catálogo en 719 y dio la cifra que faltaba: 300 de esos 719 resultados principales están formalizados en Lean, un 42 %.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- OpenAI publicó el 6 de octubre de 2026 el repositorio openai/math, con 722 manuscritos de matemáticas y sus materiales de demostración, producidos por un modelo interno que la empresa no ha lanzado ni ha nombrado.
- El 7 de octubre retiró tres. En uno, dice el historial del repositorio, «un error de signo invalida» un argumento y la construcción que usaban otros dos, así que caen juntos. El catálogo queda en 719.
- Y ese mismo día puso número a lo que faltaba: «300 / 719 = ~42 %» de los resultados principales formalizados en Lean. Los otros 419 siguen sin esa comprobación.
- La advertencia iba en el mismo texto que el anuncio —«algunos de los resultados sin formalizar podrían tener problemas»— junto con la promesa de arreglarlos rápido y de registrar cada corrección como una versión nueva.
- El Advisory Group on Mathematics and Artificial Intelligence (AGMAI) —nueve matemáticos que, según su declaración, no cobran por este trabajo— agradeció la implicación de la empresa y avisó el mismo día de que esto es «el comienzo, no la culminación, del proceso de comprensión humana».
Manuscritos, no demostraciones verificadas
El repositorio openai/math se creó el 6 de octubre de 2026 a las 21:47 UTC y contiene, en palabras de su propio README, «manuscritos matemáticos y los artefactos de demostración que los acompañan, producidos por un modelo interno de OpenAI». Ese modelo no se ha lanzado y la empresa no le pone nombre.
En ese mismo README está el matiz que decide qué se ha publicado. «Esta colección incluye resultados en distintas fases de verificación. No todos llevan formalizaciones en Lean que los acompañen», dice, y añade que seguirán actualizando el repositorio con formalizaciones «a medida que las obtengamos». Y lo deja dicho sin rodeos: «algunos de los resultados sin formalizar podrían tener problemas», y dice que se esforzará por arreglarlos «rápidamente».
La nota de OpenAI del mismo día llama a ese modelo un «internal frontier model» y dice estar trabajando para lanzarlo de forma responsable. Y se compromete a mejorar en las próximas tandas la calidad de los artículos: las citas, la exposición matemática y la presentación.
Un error de signo se lleva tres manuscritos
Un día después, el 7 de octubre, el historial del repositorio anotó la primera retirada. En «Algebraicity of Weil classes on split abelian eightfolds», escribe la empresa, «un error de signo invalida un argumento de cancelación de trazas de estabilización y la construcción que usaban dos artículos dependientes». Por eso caen tres a la vez: ese manuscrito y los dos que se apoyaban en él, sobre las correspondencias de Kuga–Satake y la conjetura de Hodge racional para productos de superficies K3. Los tres llevan ahora un aviso que explica el hueco y un enlace al manuscrito archivado.
La misma entrada revisa otros catorce manuscritos —reparaciones de demostración, enunciados corregidos, hipótesis y dependencias más claras— y actualiza trece más para que citen las ediciones revisadas. Hecha la cuenta, el catálogo que salió el 6 de octubre con 722 manuscritos aparece el 7 con 719.
Con las bajas llega el reparto que el repositorio no daba. Tras sumar seis formalizaciones y cinco adiciones, la empresa escribe que «esto eleva el porcentaje total de resultados principales formalizados a 300 / 719 = ~42 %». El README ya se presenta así: 719 manuscritos repartidos en 372 familias.
Al publicar, la empresa había escrito que se esforzaría por arreglar «con rapidez» cualquier problema. Tres manuscritos de 722 son menos del medio por ciento y la corrección llegó en menos de un día: por ahí se ve el mecanismo funcionando a la velocidad prometida. Por el otro lado, un solo error de signo arrastró tres textos porque dos se apoyaban en la construcción del primero: así un fallo se convierte en tres. Las dos lecturas salen de los mismos hechos. El historial no dice si los retirados llevaban formalización en Lean.
Leer más: OpenAI — openai/math, historial del repositorio, entrada del 7 de octubre de 2026 ↗
El examen se les quedó pequeño
| Magnitud | Cifra | De dónde sale |
|---|---|---|
| Manuscritos publicados el 6 de octubre | 722 | Recuento del catálogo el día de su publicación |
| Manuscritos el 7 de octubre | 719 | README del repositorio después de la retirada |
| Manuscritos retirados | 3 | Historial: un error de signo y los dos artículos que dependían de él |
| Manuscritos revisados | 14 | Historial: reparaciones de demostración, enunciados corregidos, hipótesis y dependencias más claras |
| Manuscritos actualizados para citar las ediciones revisadas | 13 | Historial: cambian las referencias y las fechas de versión |
| Resultados principales formalizados en Lean | 300 de 719 (~42 %) | Cifra dada por la empresa el 7 de octubre; al publicar no la daba |
| Familias de resultados | 372 | Agrupan artículos relacionados; cada una clasificada por disciplina |
| Problemas planteados al modelo | unos 4.000 | A lo largo de toda la evaluación |
| Cómputo por resultado | unas 3 horas de media | Estimación de cómputo equivalente de razonamiento de ChatGPT Pro, con un modelo interno sin lanzar |
| Familias con resumen de razonamiento | 10 | Las únicas de las que se publica el razonamiento abreviado |
El repositorio explica por qué la empresa se metió en esto: evalúa sus modelos en problemas abiertos de investigación y amplió esas evaluaciones «después de que el rendimiento en nuestras evaluaciones matemáticas existentes se saturara».
La inmensa mayoría de los resultados salió del mismo procedimiento con ese modelo sin lanzar: horas de cómputo de razonamiento de ChatGPT Pro —el plan de pago más caro de ChatGPT— por resultado, y miles de problemas planteados a lo largo de la evaluación. La salida se agregó en familias de resultados y manuscritos, exigiendo «un nivel apropiado de relevancia».
Con los manuscritos se publican un resumen en PDF de las familias, su mapa, el directorio de preprints y una biblioteca Lean con el catálogo de formalizaciones, que dice qué demostraciones formales hay y a qué artículo corresponde cada una. La empresa dice también que explora repositorios alojados por la comunidad.
Diez familias con el razonamiento a la vista
Solo diez familias llevan además un resumen abreviado del razonamiento del modelo: entre ellas, el exponente de irracionalidad de π, las conjeturas de Mahler y las cotas cuasipolinómicas para progresiones aritméticas. El resto se publica sin esa ventana al proceso.
El procedimiento fijo tiene excepciones, y las nombra la propia empresa: el trabajo sobre una región libre de ceros de la función zeta de Riemann y lo que llama la demostración de la conjetura de Hodge para variedades abelianas de tipo CM. Y una precisión más: el escrito de la región libre de ceros Re(s) > 11/12 fue «editado por humanos para que se leyera mejor».
Nueve matemáticos que no cobran
El mismo día que el catálogo, el grupo asesor publicó su valoración. Primero, el reconocimiento: «Es un acontecimiento importante para las matemáticas, con consecuencias tanto para las matemáticas como para la comunidad matemática que van mucho más allá de los resultados individuales». Y agradece la implicación de la empresa.
Y entre una cosa y la otra, una advertencia sobre su propio papel: «Que AGMAI asesore no debe interpretarse como un juicio sobre el impacto de estos resultados ni como un respaldo al procedimiento con el que OpenAI los obtuvo». Añade que no habla en nombre de toda la comunidad matemática y que solo esa comunidad puede hacer la valoración que hace falta.
Después, el aviso. «Hacer público este trabajo es un primer paso. Esta publicación es el comienzo, no la culminación, del proceso de comprensión humana y de incorporación del trabajo al conocimiento matemático». OpenAI dice que financiará «una serie de talleres, congresos y programas especiales» para entender los grandes resultados producidos por IA. Y el límite: «El futuro de la investigación matemática no puede consistir solo en comprender resultados producidos por laboratorios de IA. Los matemáticos tienen que poder formular sus propias preguntas, desarrollar sus propios enfoques y explorar direcciones que no hayan sido seleccionadas como ejemplos de las capacidades de un sistema de IA».
Un mes largo de anuncios matemáticos
El 5 de septiembre de 2026 llegó la formalización del último teorema de Fermat. El 9 de septiembre, OpenAI anunció que había resuelto el problema de la existencia y la suavidad de las ecuaciones de Navier-Stokes, y el anuncio levantó una polémica doble: si el modelo se había aprovechado de datos de matemáticos que usaban sus productos y si estas soluciones ayudan o perjudican a la matemática como ciencia. El 12 de septiembre cayó el último problema de FrontierMath. Y el 23 de septiembre la empresa contó que trabajaba con el grupo asesor y que le había planteado más de 100 problemas.
Conclusión
Lo publicado es un catálogo en marcha, y su propio historial lo enseñó en un día: salió el 6 de octubre con 722 manuscritos y el 7 tenía 719, tres menos por un error de signo. Llamarlos demostraciones verificadas sigue siendo contar otra noticia: formalizados en Lean hay 300 de 719, y el resto espera a que alguien lo revise. Es, casi con sus palabras, lo que dijeron los nueve matemáticos el mismo día: el comienzo, no la culminación.
Fuentes primarias
- OpenAI — repositorio openai/math: catálogo de 722 manuscritos (06-10-2026) e historial con la retirada de tres y la cifra de formalización (07-10-2026) ↗
- Advisory Group on Mathematics and Artificial Intelligence (AGMAI) — declaración sobre la publicación de resultados matemáticos de OpenAI (06-10-2026) ↗
- OpenAI — Sharing AI progress in mathematics (06-10-2026) ↗
- The Information — OpenAI publishes over 700 new math papers with AI-made solutions (07-10-2026) ↗
- AI Informator — la formalización en Lean del último teorema de Fermat ↗
- AI Informator — OpenAI y el problema de Navier-Stokes ↗
- AI Informator — el último problema de FrontierMath y los 25 medallistas Fields ↗
- AI Informator — Tao y la comprensión matemática ↗
- AI Informator — el grupo asesor de matemáticos y los más de 100 problemas ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios