Ciència
OpenAI aboca 722 manuscrits i l'endemà en retira tres
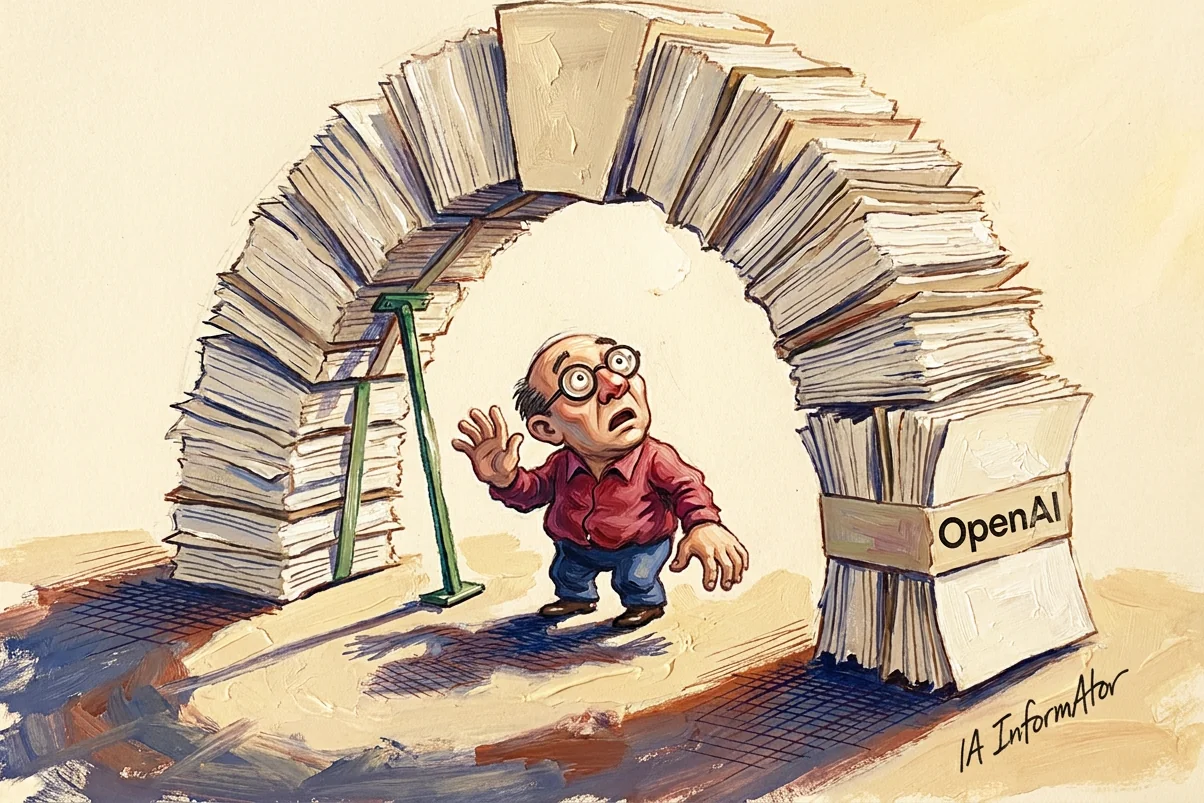
OpenAI va publicar el 6 d'octubre de 2026 un catàleg amb 722 manuscrits de matemàtiques produïts per un model intern que no ha llançat, i advertia per escrit que «alguns dels resultats sense formalitzar podrien tenir problemes». El 7 d'octubre en va retirar tres per un error de signe, deixar el catàleg en 719 i donar la xifra que faltava: 300 d'aquests 719 resultats principals estan formalitzats en Lean, un 42 %.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- OpenAI va publicar el 6 d'octubre de 2026 el repositori openai/math, amb 722 manuscrits de matemàtiques i els materials de demostració, produïts per un model intern que l'empresa no ha llançat ni ha anomenat.
- El 7 d'octubre en va retirar tres. En un, diu l'historial del repositori, «un error de signe invalida» un argument i la construcció que feien servir altres dos, així que cauen junts. El catàleg queda en 719.
- I aquell mateix dia va posar xifra al que faltava: «300 / 719 = ~42 %» dels resultats principals formalitzats en Lean. Els altres 419 continuen sense aquesta comprovació.
- L'advertiment anava en el mateix text que l'anunci —«alguns dels resultats sense formalitzar podrien tenir problemes»— amb la promesa d'arreglar-los de pressa i de registrar cada correcció com una versió nova.
- L'Advisory Group on Mathematics and Artificial Intelligence (AGMAI) —nou matemàtics que, segons la seva declaració, no cobren per aquesta feina— va agrair la implicació de l'empresa i el mateix dia va avisar que això és «el començament, no la culminació, del procés de comprensió humana».
Manuscrits, no demostracions verificades
El repositori openai/math es va crear el 6 d'octubre de 2026 a les 21:47 UTC i conté, en paraules del seu propi README, «manuscrits matemàtics i els artefactes de demostració que els acompanyen, produïts per un model intern d'OpenAI». Aquest model no s'ha llançat i l'empresa no li posa nom.
En aquest mateix README hi ha el matís que decideix què s'ha publicat. «Aquesta col·lecció inclou resultats en diferents fases de verificació. No tots porten formalitzacions en Lean que els acompanyin», diu, i afegeix que continuaran actualitzant el repositori amb formalitzacions «a mesura que les obtinguem». I ho deixa dit sense embuts: «alguns dels resultats sense formalitzar podrien tenir problemes», i diu que s'esforçarà a arreglar-los «ràpidament».
La nota d'OpenAI del mateix dia anomena aquest model un «internal frontier model» i diu que treballa per llançar-lo de manera responsable. I es compromet a millorar en les properes tandes la qualitat dels articles: les citacions, l'exposició matemàtica i la presentació.
Un error de signe s'emporta tres manuscrits
Un dia després, el 7 d'octubre, l'historial del repositori va anotar la primera retirada. A «Algebraicity of Weil classes on split abelian eightfolds», escriu l'empresa, «un error de signe invalida un argument de cancel·lació de traces d'estabilització i la construcció que feien servir dos articles dependents». Per això cauen tres de cop: aquest manuscrit i els dos que s'hi recolzaven, sobre les correspondències de Kuga–Satake i la conjectura de Hodge racional per a productes de superfícies K3. Tots tres porten ara un avís que explica el buit i un enllaç al manuscrit arxivat.
La mateixa entrada revisa altres catorze manuscrits —reparacions de demostració, enunciats corregits, hipòtesis i dependències més clares— i actualitza tretze més perquè citin les edicions revisades. Fet el compte, el catàleg que va sortir el 6 d'octubre amb 722 manuscrits apareix el 7 amb 719.
Amb les baixes arriba el repartiment que el repositori no donava. Després de sumar sis formalitzacions i cinc addicions, l'empresa escriu que «això eleva el percentatge total de resultats principals formalitzats a 300 / 719 = ~42 %». El README ja es presenta així: 719 manuscrits repartits en 372 famílies.
En publicar, l'empresa havia escrit que s'esforçaria a arreglar «amb rapidesa» qualsevol problema. Tres manuscrits dels 722 publicats el 6 d'octubre són menys del mig per cent i la correcció va arribar en menys d'un dia: per aquí es veu el mecanisme funcionant a la velocitat promesa. D'altra banda, un sol error de signe va arrossegar tres textos perquè dos es recolzaven en la construcció del primer: així una errada es converteix en tres. Les dues lectures surten dels mateixos fets. L'historial no diu si els retirats portaven formalització en Lean.
Llegir-ne més: OpenAI — openai/math, historial del repositori, entrada del 7 d'octubre de 2026 ↗
L'examen se'ls va quedar petit
| Magnitud | Xifra | D'on surt |
|---|---|---|
| Manuscrits publicats el 6 d'octubre | 722 | Recompte del catàleg el dia de la seva publicació |
| Manuscrits el 7 d'octubre | 719 | README del repositori després de la retirada |
| Manuscrits retirats | 3 | Historial: un error de signe i els dos articles que en depenien |
| Manuscrits revisats | 14 | Historial: reparacions de demostració, enunciats corregits, hipòtesis i dependències més clares |
| Manuscrits actualitzats per citar les edicions revisades | 13 | Historial: canvien les referències i les dates de versió |
| Resultats principals formalitzats en Lean | 300 de 719 (~42 %) | Xifra donada per l'empresa el 7 d'octubre; en publicar no la donava |
| Famílies de resultats | 372 | Agrupen articles relacionats; cadascuna classificada per disciplina |
| Problemes plantejats al model | uns 4.000 | Al llarg de tota l'avaluació |
| Còmput per resultat | unes 3 hores de mitjana | Estimació de còmput equivalent de raonament de ChatGPT Pro, amb un model intern sense llançar |
| Famílies amb resum de raonament | 10 | Les úniques de les quals es publica el raonament abreujat |
El repositori explica per què l'empresa s'hi va posar: avalua els seus models en problemes oberts de recerca i va ampliar aquestes avaluacions «després que el rendiment en les nostres avaluacions matemàtiques existents se saturés».
La immensa majoria dels resultats va sortir del mateix procediment amb aquest model sense llançar: hores de còmput de raonament de ChatGPT Pro —el pla de pagament més car de ChatGPT— per resultat, i milers de problemes plantejats al llarg de l'avaluació. La sortida es va agregar en famílies de resultats i manuscrits, exigint «un nivell apropiat de rellevància».
Amb els manuscrits es publiquen un resum en PDF de les famílies, el seu mapa, el directori de preprints i una biblioteca Lean amb el catàleg de formalitzacions, que diu quines demostracions formals hi ha i a quin article correspon cadascuna. L'empresa diu també que explora repositoris allotjats per la comunitat.
Deu famílies amb el raonament a la vista
Només deu famílies porten a més un resum abreujat del raonament del model: entre elles, l'exponent d'irracionalitat de π, les conjectures de Mahler i les fites quasipolinòmiques per a progressions aritmètiques. La resta es publica sense aquesta finestra al procés.
El procediment fix té excepcions, i les assenyala la mateixa empresa: el treball sobre una regió lliure de zeros de la funció zeta de Riemann i el que anomena la demostració de la conjectura de Hodge per a varietats abelianes de tipus CM. I una precisió més: l'escrit de la regió lliure de zeros Re(s) > 11/12 va ser «editat per humans perquè es llegís millor».
Nou matemàtics que no cobren
El mateix dia que el catàleg, el grup assessor va publicar la seva valoració. Primer, el reconeixement: «És un esdeveniment important per a les matemàtiques, amb conseqüències tant per a les matemàtiques com per a la comunitat matemàtica que van molt més enllà dels resultats individuals». I agraeix la implicació de l'empresa.
I entre una cosa i l'altra, un advertiment sobre el seu propi paper: «Que AGMAI assessori no s'ha d'interpretar com un judici sobre l'impacte d'aquests resultats ni com un aval al procediment amb què OpenAI els va obtenir». Afegeix que no parla en nom de tota la comunitat matemàtica i que només aquesta comunitat pot fer la valoració que cal.
Després, l'avís. «Fer públic aquest treball és un primer pas. Aquesta publicació és el començament, no la culminació, del procés de comprensió humana i d'incorporació del treball al coneixement matemàtic». OpenAI diu que finançarà «una sèrie de tallers, congressos i programes especials» per entendre els grans resultats produïts per IA. I el límit: «El futur de la recerca matemàtica no pot consistir només a comprendre resultats produïts per laboratoris d'IA. Els matemàtics han de poder formular les seves pròpies preguntes, desenvolupar els seus propis enfocaments i explorar direccions que no hagin estat seleccionades com a exemples de les capacitats d'un sistema d'IA».
Un mes llarg d'anuncis matemàtics
El 5 de setembre de 2026 va arribar la formalització de l'últim teorema de Fermat. El 9 de setembre, OpenAI va anunciar que havia resolt el problema de l'existència i la suavitat de les equacions de Navier-Stokes, i l'anunci va aixecar una polèmica doble: si el model s'havia aprofitat de dades de matemàtics que feien servir els seus productes i si aquestes solucions ajuden o perjudiquen la matemàtica com a ciència. El 12 de setembre va caure l'últim problema de FrontierMath. I el 23 de setembre l'empresa explicava que treballava amb el grup assessor i que li havia plantejat més de 100 problemes.
Conclusió
El que s'ha publicat és un catàleg en marxa, i el seu propi historial ho va ensenyar en un dia: va sortir el 6 d'octubre amb 722 manuscrits i el 7 en tenia 719, tres menys per un error de signe. Dir-ne demostracions verificades continua sent explicar una altra notícia: formalitzats en Lean n'hi ha 300 de 719, i la resta espera que algú la revisi. És, gairebé amb les seves paraules, el que van dir els nou matemàtics el mateix dia: el començament, no la culminació.
Fonts primàries
- OpenAI — repositori openai/math: catàleg de 722 manuscrits (06-10-2026) i historial amb la retirada de tres i la xifra de formalització (07-10-2026) ↗
- Advisory Group on Mathematics and Artificial Intelligence (AGMAI) — declaració sobre la publicació de resultats matemàtics d’OpenAI (06-10-2026) ↗
- OpenAI — Sharing AI progress in mathematics (06-10-2026) ↗
- The Information — OpenAI publishes over 700 new math papers with AI-made solutions (07-10-2026) ↗
- AI Informator — la formalització en Lean de l'últim teorema de Fermat ↗
- AI Informator — OpenAI i el problema de Navier-Stokes ↗
- AI Informator — l'últim problema de FrontierMath i els 25 medallistes Fields ↗
- AI Informator — Tao i la comprensió matemàtica ↗
- AI Informator — el grup assessor de matemàtics i els més de 100 problemes ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris