Hardware
Google mete dos chips en su nueva TPU
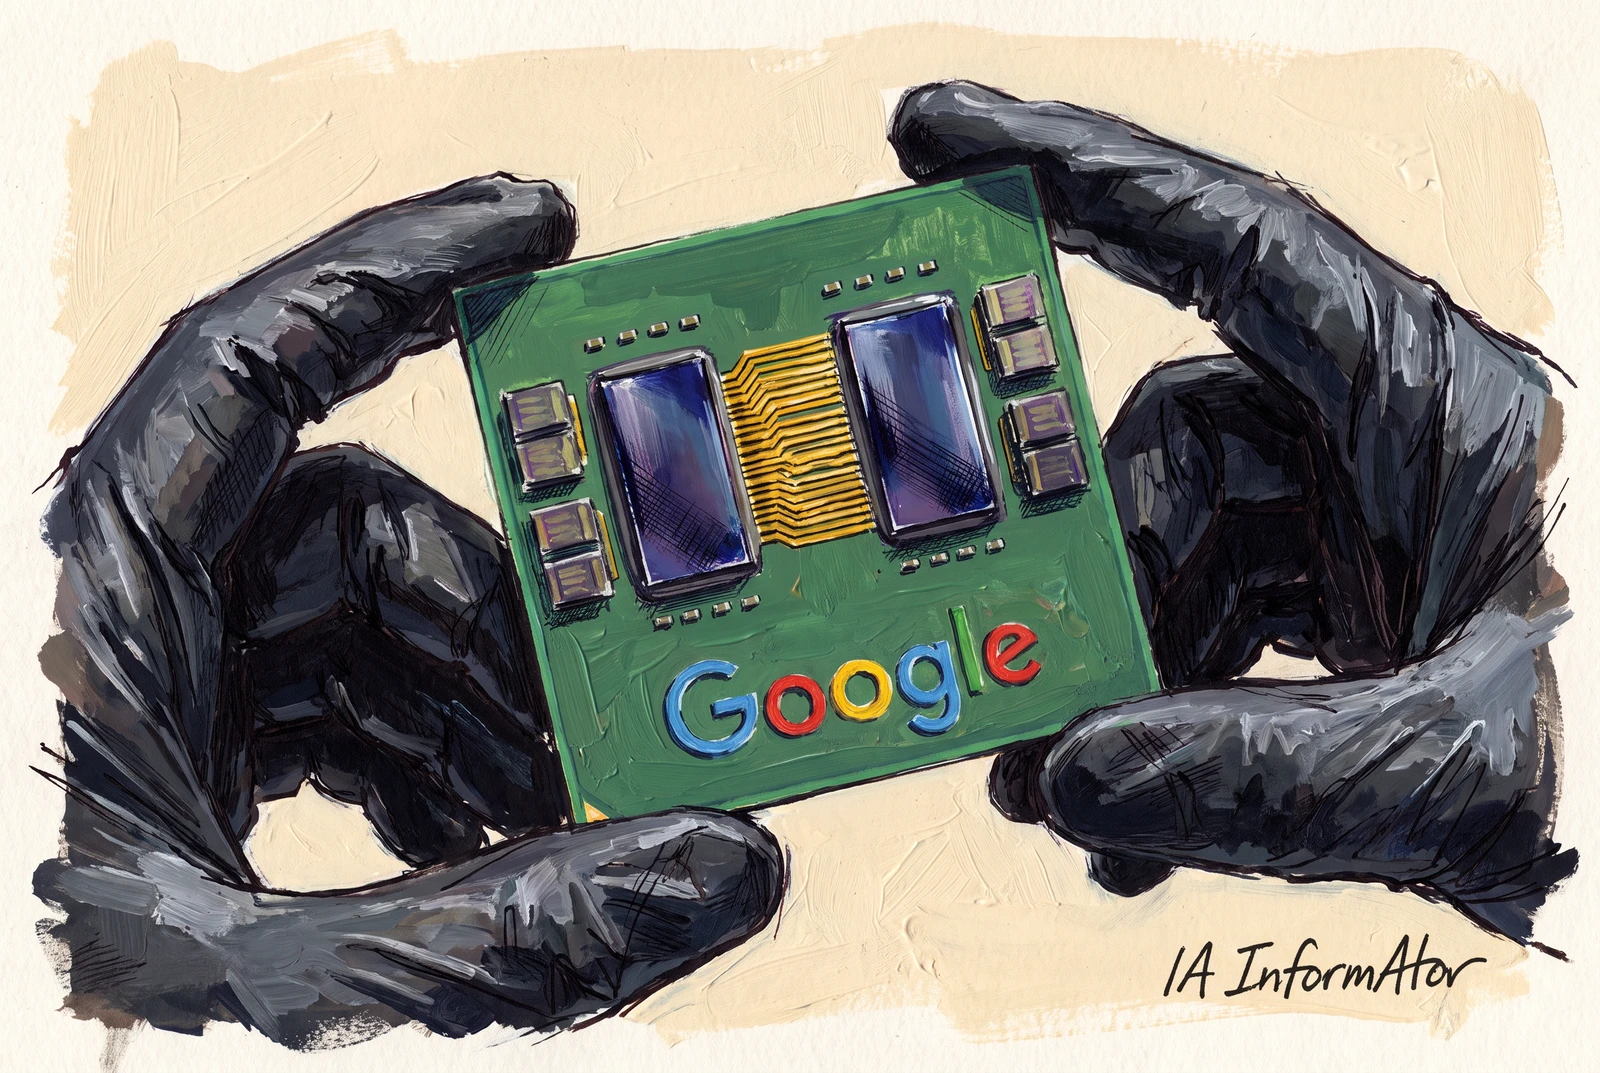
Google ha presentado dos sistemas nuevos de su octava generación de TPU, sus chips propios de IA: la TPU 8i Max, que junta dos chips en un solo encapsulado para trabajar con contextos enormes, y la TPU 8tx, que con procesadores de AMD protege los datos incluso mientras se usan, según Google. El anuncio no trae fecha de disponibilidad ni precio.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Según Google, la TPU 8i Max ofrece el doble de cálculo, de SRAM y de ancho de banda de HBM que la TPU 8i.
- La TPU 8tx usa el silicio de la TPU 8t con procesadores AMD EPYC de quinta generación y, según Google, tiene hasta la mitad de latencia que la 8t.
- Google afirma tener casi 100 clientes de TPU, pero no da sus nombres.
Cuatro TPU en un mismo año
Amin Vahdat, jefe de tecnología y vicepresidente sénior de IA e infraestructura de Google, presentó el 9 de noviembre de 2026 la TPU 8tx y la TPU 8i Max. Se suman a la TPU 8t, para entrenar modelos a gran escala, y a la TPU 8i, para razonar en tiempo real, que Google enseñó en abril en su conferencia Google Cloud Next. Según Google, aquellas dos ofrecían hasta 2,7 veces más rendimiento de entrenamiento y un 80 % mejor relación entre precio y rendimiento en inferencia, respectivamente, frente a la generación anterior.
La empresa dice que es la primera vez que presenta cuatro sistemas TPU en un solo año. Ninguna de las dos novedades es un chip nuevo: la 8tx reutiliza el silicio de la 8t y la 8i Max junta dos 8i.
TPU 8tx: datos protegidos también mientras se usan
La TPU 8tx está pensada, según Google, para inferencia confidencial en empresas de sectores regulados y gobiernos, y sirve también para entrenamientos pequeños. Combina el silicio de la 8t con procesadores centrales (CPU) AMD EPYC de quinta generación, y la empresa asegura que mantiene los datos y los pesos del modelo protegidos y aislados incluso mientras se usan.
Toma además de la 8i su red de baja latencia, Boardfly. Según Google, así una organización puede hacer un ajuste fino (fine-tuning) de sus modelos con datos privados, destilar modelos grandes en otros más pequeños y entrenar agentes con aprendizaje por refuerzo (RL, reinforcement learning) sin mover la información sensible de un clúster a otro.
TPU 8i Max: dos chips en uno
La TPU 8i Max está pensada, según Google, para ventanas de contexto enormes, como las de decenas de agentes que trabajan a la vez sobre un repositorio de código entero o sobre horas de vídeo. La solución ha sido juntar dos chips TPU 8i en un solo encapsulado.
El resultado, según la empresa, es el doble de memoria SRAM, la muy rápida que va dentro del chip, el doble de ancho de banda de la memoria HBM (High Bandwidth Memory), la que va junto a él, y el doble de cálculo. Como cabe el doble de silicio en el mismo espacio de bastidor, un centro de datos puede meter más cálculo sin ocupar más sitio.
El software para atraer clientes
Google afirma que las TPU son ya un negocio en rápido crecimiento con casi 100 clientes, entre ellos laboratorios frontier, firmas de trading, cadenas comerciales y universidades. Para atraer a más, publicó en octubre como código abierto TorchTPU, con el que el código de PyTorch y los modelos de Hugging Face funcionan directamente en TPU, según Google.
Suma un conjunto de agentes de código abierto para TPU, en vista previa, que se conecta a herramientas de programación como Claude Code, Cursor y Google Antigravity, y TPU Sync, que según la empresa reduce más de un 90 % el tiempo hasta el primer token. Google dice además que diseña los próximos chips con AlphaChip, de su laboratorio de IA Google DeepMind, y con Gemini, «en horas en lugar de semanas».
Lo que falta: fecha y precio
| Sistema | Para qué es | Qué lo distingue |
|---|---|---|
| TPU 8t | Entrenamiento a gran escala | Hasta 2,7 veces más rendimiento de entrenamiento que la generación anterior |
| TPU 8i | Razonamiento en tiempo real | Reduce hasta la mitad los retrasos de comunicación entre chips |
| TPU 8tx | Inferencia confidencial | CPU AMD EPYC de 5.ª generación; hasta 2 veces menos latencia que la 8t |
| TPU 8i Max | Contextos enormes | Dos chips 8i en un encapsulado: el doble de cálculo, SRAM y ancho de banda HBM que la 8i |
El anuncio no incluye fecha de disponibilidad ni precio de la TPU 8tx ni de la TPU 8i Max. Google tampoco da cifras absolutas de la 8i Max, solo la compara con la 8i, y todas las mediciones son de la propia empresa.
Conclusión
Según Google, su octava generación queda con un sistema para cada fase del trabajo con IA. Es una forma de competir con Nvidia con el sistema completo —chip, red y software— y no solo con el chip. Falta saber cuándo llegarán la 8tx y la 8i Max y a qué precio.
Fuentes primarias
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios