Hardware
Google encabeix dos xips a la seva nova TPU
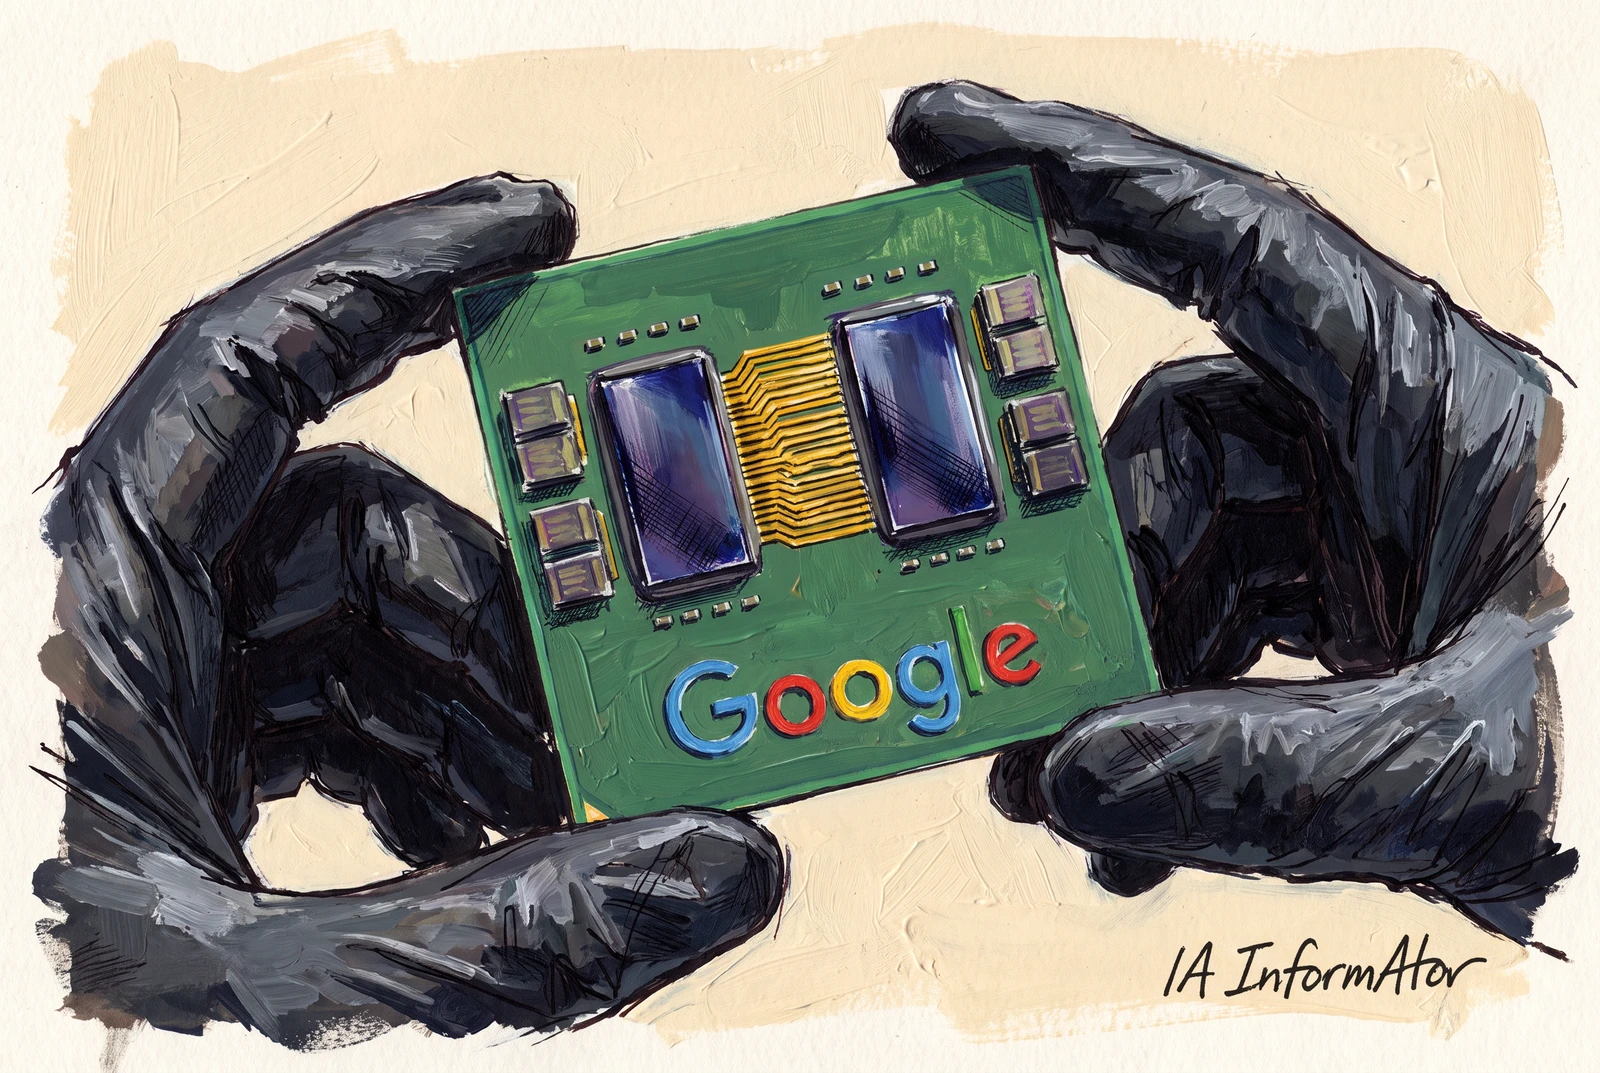
Google ha presentat dos sistemes nous de la vuitena generació de TPU, els seus xips propis d'IA: la TPU 8i Max, que uneix dos xips en un sol encapsulat per treballar amb contextos enormes, i la TPU 8tx, que amb processadors d'AMD protegeix les dades fins i tot mentre s'utilitzen, segons Google. L'anunci no inclou data de disponibilitat ni preu.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- Segons Google, la TPU 8i Max ofereix el doble de càlcul, de SRAM i d'amplada de banda d'HBM que la TPU 8i.
- La TPU 8tx fa servir el silici de la TPU 8t amb processadors AMD EPYC de cinquena generació i, segons Google, té fins a la meitat de latència que la 8t.
- Google afirma que té gairebé 100 clients de TPU, però no en diu els noms.
Quatre TPU en un mateix any
Amin Vahdat, cap de tecnologia i vicepresident sènior d'IA i infraestructura de Google, va presentar el 9 de novembre de 2026 la TPU 8tx i la TPU 8i Max. S'afegeixen a la TPU 8t, per entrenar models a gran escala, i a la TPU 8i, per raonar en temps real, que Google va mostrar a l'abril a la seva conferència Google Cloud Next. Segons Google, aquelles dues oferien fins a 2,7 vegades més rendiment d'entrenament i una relació entre preu i rendiment un 80 % millor en inferència, respectivament, respecte de la generació anterior.
L'empresa diu que és la primera vegada que presenta quatre sistemes TPU en un sol any. Cap de les dues novetats no és un xip nou: la 8tx reaprofita el silici de la 8t i la 8i Max uneix dues 8i.
TPU 8tx: dades protegides també mentre s'utilitzen
La TPU 8tx està pensada, segons Google, per a la inferència confidencial en empreses de sectors regulats i governs, i també serveix per a entrenaments petits. Combina el silici de la 8t amb processadors centrals (CPU) AMD EPYC de cinquena generació, i l'empresa assegura que manté les dades i els pesos del model protegits i aïllats fins i tot mentre s'utilitzen.
A més, pren de la 8i la seva xarxa de baixa latència, Boardfly. Segons Google, així una organització pot fer un ajust fi (fine-tuning) dels seus models amb dades privades, destil·lar models grans en d'altres de més petits i entrenar agents amb aprenentatge per reforç (RL, reinforcement learning) sense moure la informació sensible d'un clúster a un altre.
TPU 8i Max: dos xips en un
La TPU 8i Max està pensada, segons Google, per a finestres de context enormes, com les de desenes d'agents que treballen alhora sobre un repositori de codi sencer o sobre hores de vídeo. La solució ha estat unir dos xips TPU 8i en un sol encapsulat.
El resultat, segons l'empresa, és el doble de memòria SRAM, la molt ràpida que va dins del xip, el doble d'amplada de banda de la memòria HBM (High Bandwidth Memory), la que va al costat, i el doble de càlcul. Com que hi cap el doble de silici en el mateix espai de bastidor, un centre de dades pot encabir-hi més càlcul sense ocupar més lloc.
El programari per atraure clients
Google afirma que les TPU ja són un negoci en ràpid creixement amb gairebé 100 clients, entre els quals hi ha laboratoris frontier, firmes de trading, cadenes comercials i universitats. Per atraure'n més, a l'octubre va publicar com a codi obert TorchTPU, amb el qual el codi de PyTorch i els models de Hugging Face funcionen directament en TPU, segons Google.
Hi afegeix un conjunt d'agents de codi obert per a TPU, en versió preliminar, que es connecta a eines de programació com Claude Code, Cursor i Google Antigravity, i TPU Sync, que segons l'empresa redueix més d'un 90 % el temps fins al primer token. Google diu, a més, que dissenya els pròxims xips amb AlphaChip, del seu laboratori d'IA Google DeepMind, i amb Gemini, «en hores en lloc de setmanes».
El que falta: data i preu
| Sistema | Per a què serveix | Què el distingeix |
|---|---|---|
| TPU 8t | Entrenament a gran escala | Fins a 2,7 vegades més rendiment d'entrenament que la generació anterior |
| TPU 8i | Raonament en temps real | Redueix fins a la meitat els retards de comunicació entre xips |
| TPU 8tx | Inferència confidencial | CPU AMD EPYC de 5a generació; fins a 2 vegades menys latència que la 8t |
| TPU 8i Max | Contextos enormes | Dos xips 8i en un encapsulat: el doble de càlcul, SRAM i amplada de banda HBM que la 8i |
L'anunci no inclou data de disponibilitat ni preu de la TPU 8tx ni de la TPU 8i Max. Google tampoc no dona xifres absolutes de la 8i Max, només la compara amb la 8i, i totes les mesures són de la mateixa empresa.
Conclusió
Segons Google, la seva vuitena generació queda amb un sistema per a cada fase del treball amb IA. És una manera de competir amb Nvidia amb el sistema complet —xip, xarxa i programari— i no només amb el xip. Falta saber quan arribaran la 8tx i la 8i Max i a quin preu.
Fonts primàries
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris