
Investigación
SWE-Duel pone a los agentes a esconder y reparar errores
SWE-Duel propone un examen de programación que crea sus problemas durante la evaluación. Según sus autores, enfrentar a quienes introducen errores con quienes deben repararlos permite renovar las tareas y ajustar su dificultad a las capacidades de los participantes.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Los problemas se crean durante el examen para evitar que esas tareas concretas estén en datos de entrenamiento anteriores.
- Solo se admiten tareas que el propio agente autor puede reparar en una sesión nueva.
- El trabajo está bajo revisión; sus resultados describen las condiciones del torneo.
Un examen que prepara sus propias preguntas
El trabajo incluye investigadores con afiliación a Singapore Management University, una universidad autónoma de Singapur según su Ministerio de Educación, fundada con financiación del Gobierno según su propia historia institucional. Los autores parten de un problema: las pruebas con ejercicios fijos pueden acabar incorporadas a los datos con los que se entrenan los modelos. Además, sostienen que un conjunto de preguntas cerrado pierde dificultad a medida que los sistemas mejoran. Su propuesta cambia cuándo se preparan los ejercicios y quién los diseña.
El documento se presentó el 8 de octubre de 2026 y figura bajo revisión para ICLR 2027, sin que ese estado equivalga a una revisión por pares completada. Plantea un enfrentamiento en el que los participantes se alternan: primero preparan un cambio con un defecto escondido y después revisan el trabajo del contrario.
Esconder un fallo no basta
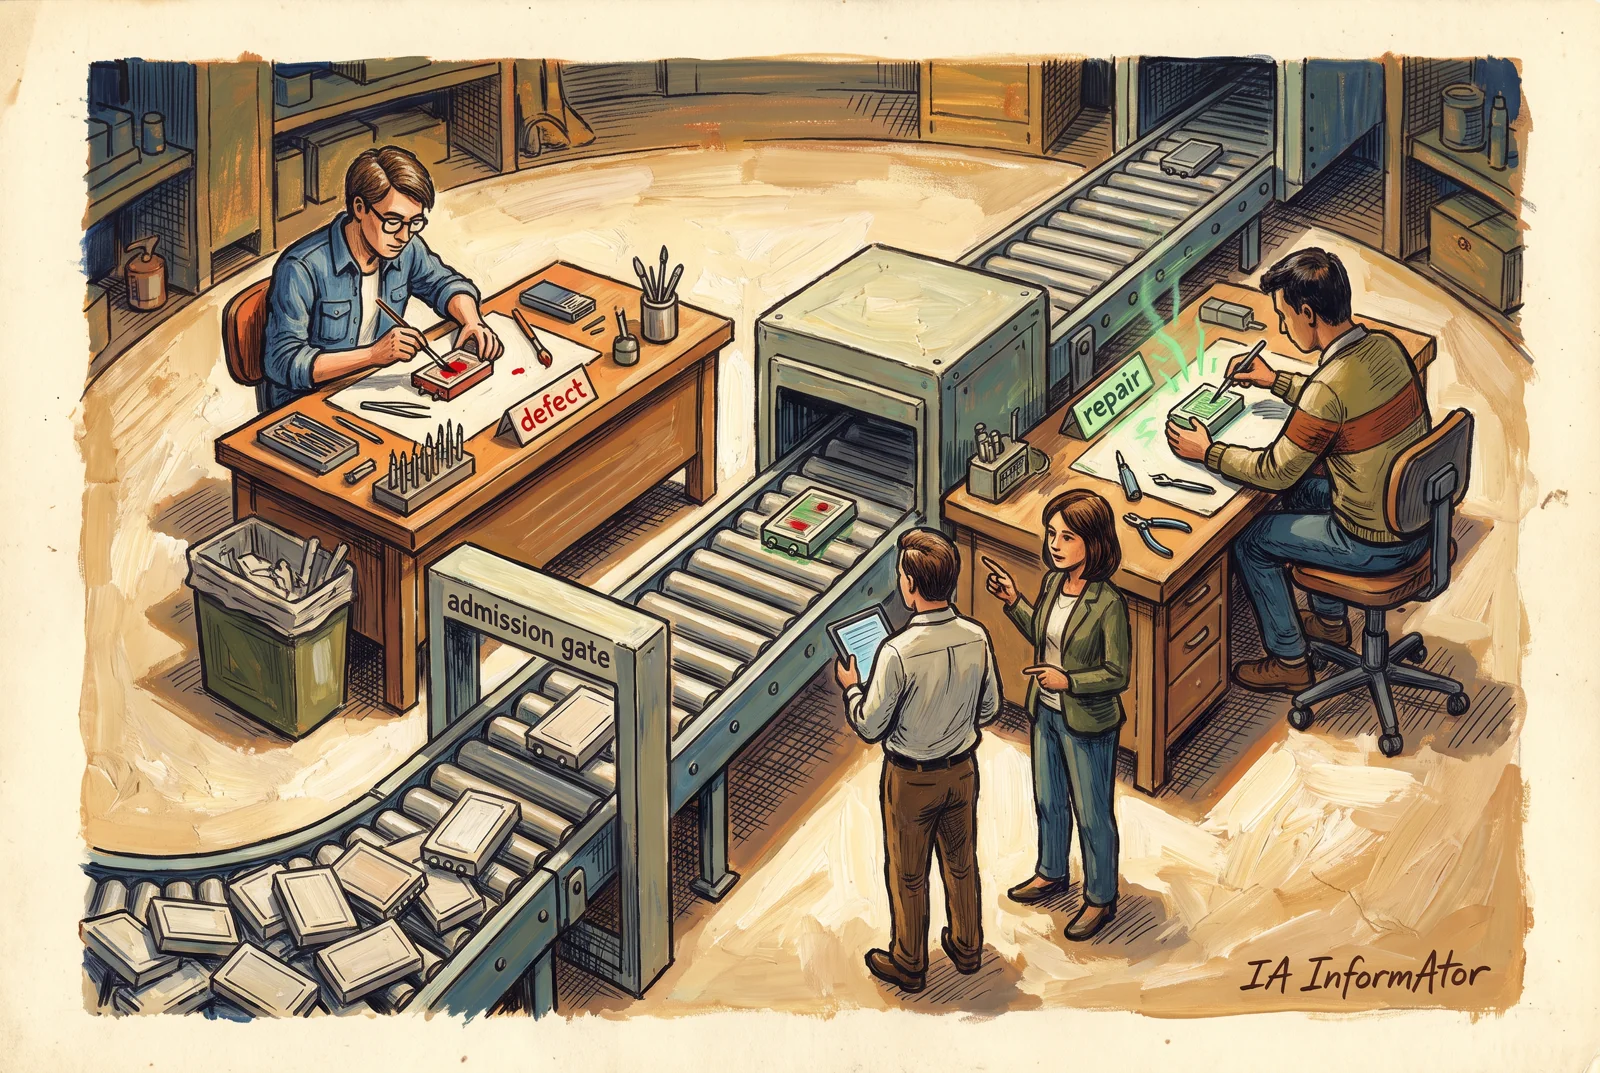
En cada turno, el agente que prepara la tarea trabaja sobre un proyecto real mediante sesiones con contextos separados. Propone una función nueva, la implementa y escribe pruebas para comprobarla. Después introduce un error sutil en esa función y prepara comprobaciones reservadas que permiten detectar el defecto. Así queda construido el problema que deberá afrontar su rival.
La tarea no entra automáticamente en el duelo. Según el protocolo descrito, debe superar tanto las comprobaciones de la función nueva como las que ya tenía el proyecto, y fallar precisamente en las destinadas a detectar el error introducido. Además, una sesión nueva del mismo agente debe poder repararlo sin conocer de antemano la solución.
El rival recibe el cambio para revisarlo sin que se le diga que contiene un fallo. Para ganar, su revisión debe superar todos los grupos de pruebas: los del proyecto, los de la nueva función y los del defecto. Después se intercambian los papeles. La condición de reparación previa busca excluir problemas imposibles, no premiar cualquier sabotaje.
Qué permiten concluir los resultados
Según los autores, el torneo reúne 11 combinaciones de modelo y entorno de trabajo, desarrollado sobre 15 proyectos de código y con 1.500 turnos. Ese es el alcance de la evaluación presentada: tareas creadas por los participantes y admitidas mediante las condiciones del propio examen.
Según los autores, GPT-5.5 con Codex CLI reparó el 98,3 % de los defectos que revisó. La cifra corresponde a esa combinación y a esos problemas. No permite afirmar que el modelo vaya a corregir esa proporción de los errores que encuentre en cualquier programa o situación de trabajo.
También conviene acotar la promesa sobre los datos de entrenamiento. Crear los ejercicios durante la evaluación impide que esas tareas concretas existan con anterioridad, según el argumento del artículo. Esa propiedad del diseño y el filtro de reparación no constituyen una demostración general de ausencia de contaminación en todos los materiales utilizados.
Conclusión
La propuesta desplaza el foco desde resolver un examen fijo hacia construir desafíos y responder a los del contrario. Su interés está en ese mecanismo; los resultados deben leerse dentro de las tareas, los filtros y las combinaciones evaluadas.
Fuentes primarias
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios