
Recerca
SWE-Duel posa els agents a amagar i reparar errors
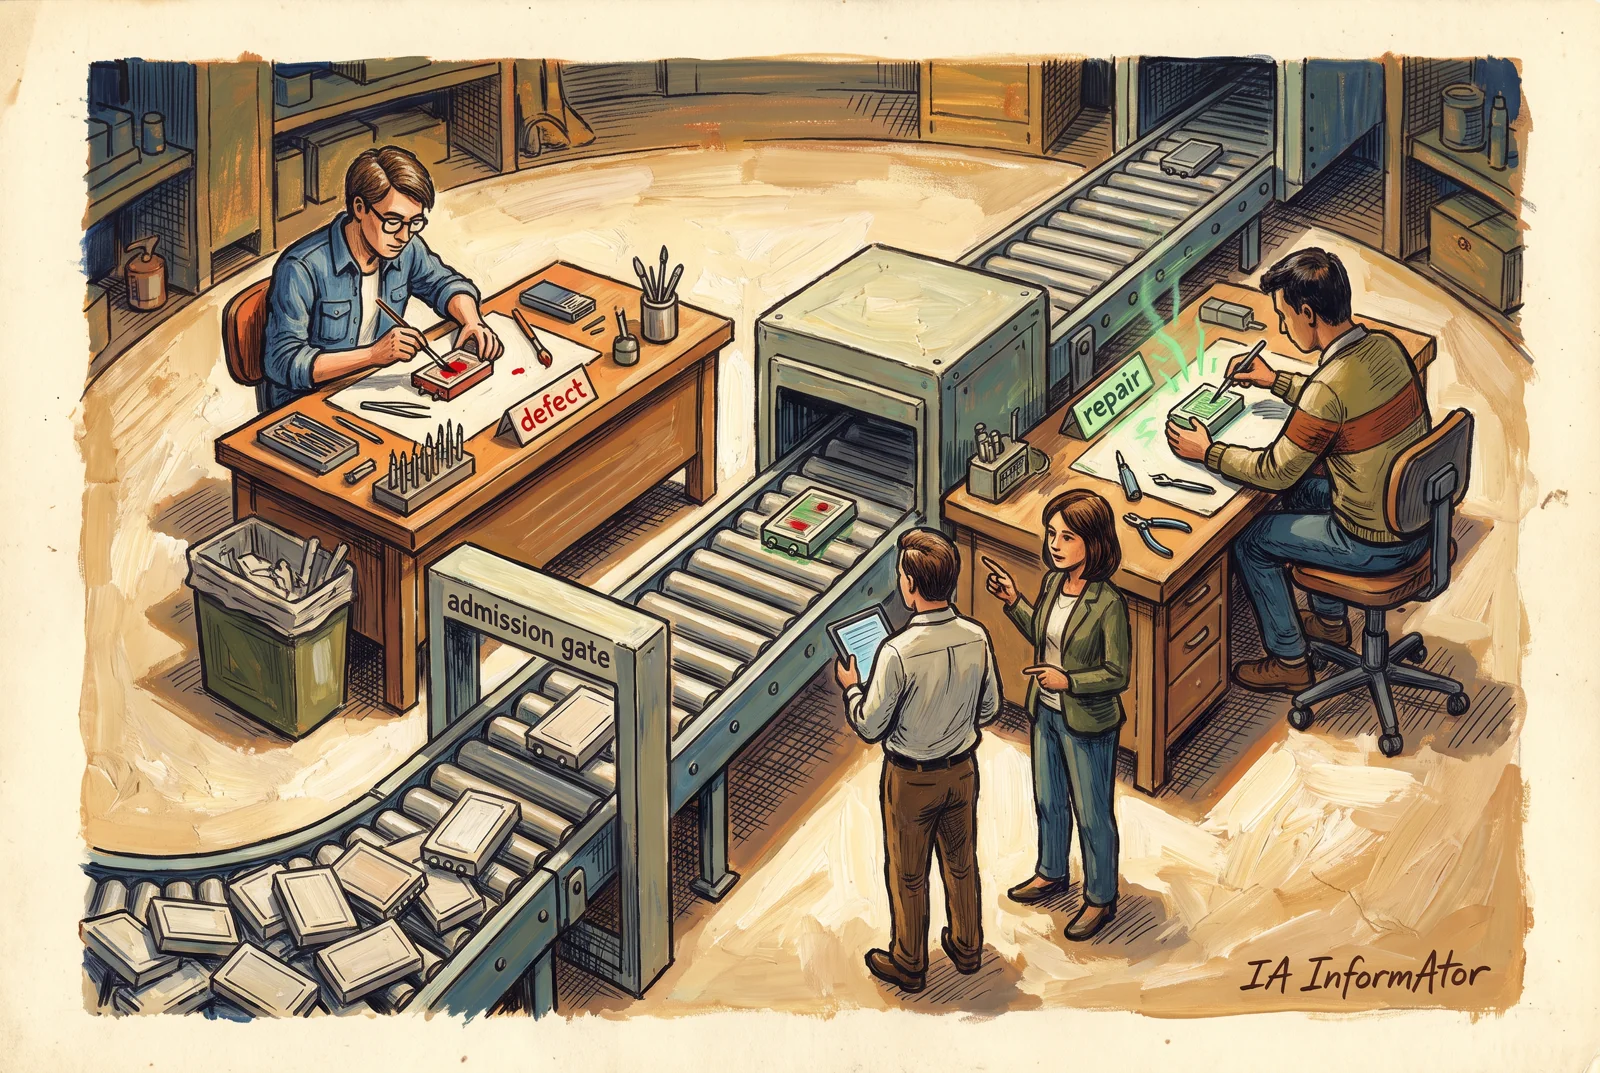
SWE-Duel proposa un examen de programació que crea els problemes durant l’avaluació. Segons els seus autors, enfrontar els agents que introdueixen errors amb els que els han de reparar permet renovar les tasques i ajustar-ne la dificultat a les capacitats dels participants.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- Els problemes es creen durant l’examen per evitar que aquestes tasques concretes siguin en dades d’entrenament anteriors.
- Només s’admeten tasques que el mateix agent que les ha creades pot reparar en una sessió nova.
- El treball està en procés de revisió; els resultats descriuen les condicions del torneig.
Un examen que prepara les seves pròpies preguntes
En el treball hi participen investigadors vinculats a Singapore Management University, una universitat autònoma de Singapur segons el Ministeri d’Educació del país, fundada amb finançament del Govern segons la seva pròpia història institucional. Els autors parteixen d’un problema: les proves amb exercicis fixos poden acabar incorporades a les dades amb què s’entrenen els models. A més, sostenen que un conjunt tancat de preguntes perd dificultat a mesura que els sistemes milloren. La seva proposta canvia quan es preparen els exercicis i qui els dissenya.
El document es va presentar el 8 d’octubre de 2026 i consta que està en procés de revisió per a ICLR 2027, cosa que no equival a haver completat una revisió per parells. Planteja un enfrontament en què els participants s’alternen: primer preparen un canvi amb un defecte amagat i després revisen la feina del contrari.
No n’hi ha prou d’amagar un error
En cada torn, l’agent que prepara la tasca treballa sobre un projecte real en sessions amb contextos separats. Proposa una funció nova, la implementa i escriu proves per comprovar-la. Després introdueix un error subtil en aquesta funció i prepara comprovacions reservades que permeten detectar el defecte. Així queda construït el problema que haurà d’afrontar el rival.
La tasca no entra automàticament en el duel. Segons el protocol descrit, ha de superar tant les comprovacions de la funció nova com les que ja tenia el projecte, i fallar precisament en les destinades a detectar l’error introduït. A més, una sessió nova del mateix agent ha de poder reparar-lo sense conèixer la solució per endavant.
El rival rep el canvi per revisar-lo sense que se li digui que conté un error. Per guanyar, la seva revisió ha de superar tots els grups de proves: els del projecte, els de la funció nova i els del defecte. Després s’intercanvien els papers. La condició de reparació prèvia busca excloure problemes impossibles, no premiar qualsevol sabotatge.
Què permeten concloure els resultats
Segons els autors, el torneig reuneix 11 combinacions de model i entorn de treball i es desenvolupa sobre 15 projectes de codi, amb 1.500 torns. Aquest és l’abast de l’avaluació presentada: tasques creades pels participants i admeses segons les condicions del mateix examen.
Segons els autors, GPT-5.5 amb Codex CLI va reparar el 98,3 % dels defectes que va revisar. La xifra correspon a aquesta combinació i a aquests problemes. No permet afirmar que el model corregirà aquesta proporció dels errors que trobi en qualsevol programa o situació de treball.
També convé delimitar la promesa sobre les dades d’entrenament. Crear els exercicis durant l’avaluació impedeix que aquestes tasques concretes existeixin amb anterioritat, segons l’argument de l’article. Aquesta propietat del disseny i el filtre de reparació no constitueixen una demostració general de l’absència de contaminació en tots els materials utilitzats.
Conclusió
La proposta desplaça el focus de resoldre un examen fix a construir reptes i respondre als del contrari. L’interès rau en aquest mecanisme; els resultats s’han de llegir dins dels límits de les tasques, els filtres i les combinacions avaluades.
Fonts primàries
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris