
Agentes
Google: El arnés que se remienda solo
Harness², presentado el 9 de octubre en arXiv, reescribe en cada tarea las instrucciones, la memoria y las herramientas de un agente de IA sin tocar el modelo. Según Google Cloud AI Research, que firma el trabajo con la Universidad Northwestern, un solo paso de mejora suma hasta 11,5 puntos en WorkBuddy-Bench.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Harness² no reentrena el modelo: cambia lo que lo rodea, de las instrucciones a los subagentes, y guarda lo aprendido para la tarea siguiente.
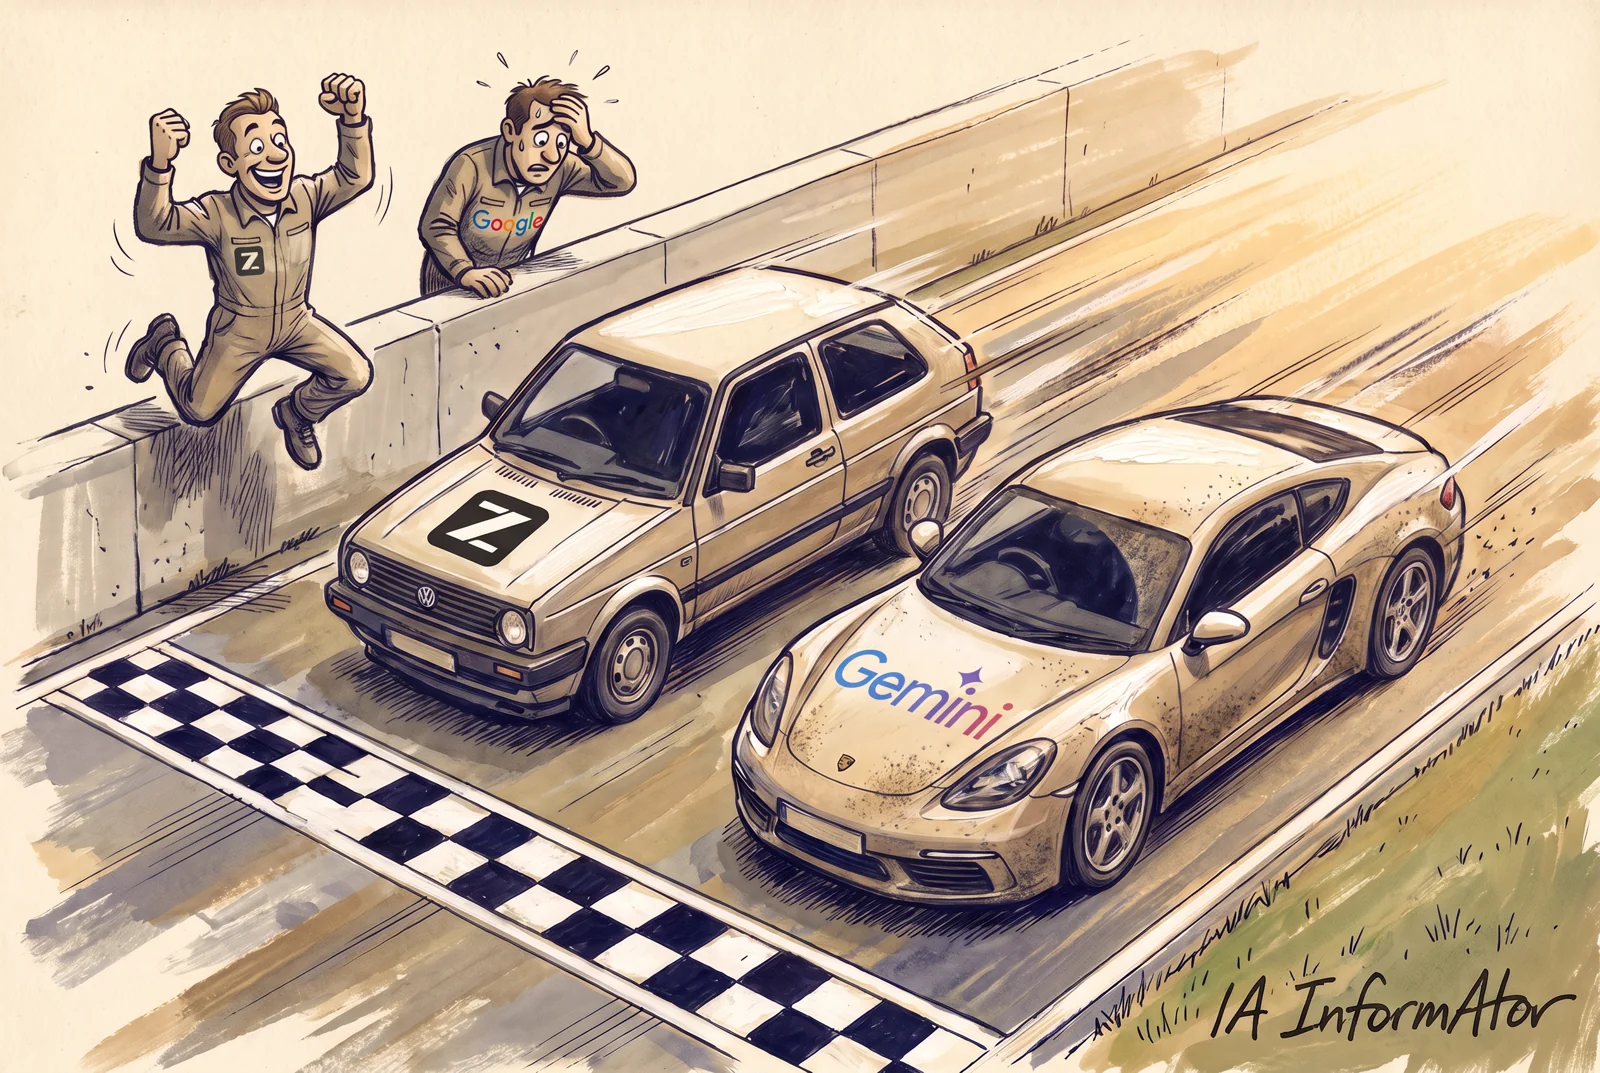
- Según Google Cloud AI Research, con el arnés mejorado GLM-5 supera en WorkBuddy-Bench a Gemini 3.5 Flash con su arnés de base.
- Las pruebas son de los propios autores, y el editor que reescribe el arnés por defecto es Claude Opus 4.8, de Anthropic.
Mismo modelo, otro arnés
Harness² es un marco para mejorar el arnés de un agente de IA, firmado por investigadores de la Universidad Northwestern y de Google Cloud AI Research y presentado el 9 de octubre en arXiv, el repositorio abierto donde los investigadores publican trabajos aún sin revisar. Google Cloud AI Research se presenta como el equipo que investiga para llevar la IA a los productos y la infraestructura de Google Cloud, y que explora una nueva clase de agentes «Co-X» para automatizar tareas humanas complejas.
Lo que cambia no es el modelo, sino lo que lo rodea. Harness² expone ocho piezas editables: instrucciones de sistema (system prompt), reglas de seguridad (guardrails), memoria, guía de uso de herramientas, subagentes, habilidades (skills), scripts y complementos (plugins).
Proponer, probar y componer
El sistema trabaja en dos niveles. En el de la tarea, aplica un paso de contraste que sus autores llaman Propose–Probe–Compose: propone cambios en el arnés, prueba su efecto en la misma tarea y compone un arnés mejorado a partir de las diferencias de comportamiento entre ejecuciones. No necesita conocer la respuesta correcta, algo clave en un mundo abierto, donde el agente se encuentra con tareas que nadie previó al diseñar su arnés.
En el segundo nivel, Harness² actualiza un arnés de mejora persistente con los arneses que ha adoptado y con las lecciones de cada tarea respaldadas por pruebas, para orientar las mejoras siguientes. Todo ello, sin tocar los pesos del modelo.
El modelo débil adelanta al fuerte
| Arnés de partida | WorkBuddy-Bench: GLM-5 con arnés mejorado | WorkBuddy-Bench: Gemini 3.5 Flash con arnés base | JobBench: mejora de Gemini 3.5 Flash | JobBench: mejora de GLM-5 |
|---|---|---|---|---|
| OpenCode | 75,7 | 72,4 | +4,5 | +3,6 |
| Codex | 75,3 | 74,5 | +1,4 | +1,2 |
Los autores lo midieron en tres benchmarks profesionales: WorkBuddy-Bench, de Tencent, con tareas de código, web y ofimática; JobBench, con trabajos profesionales de principio a fin, y LAB, la prueba de trabajo jurídico de Harvey AI. Según Google Cloud AI Research, un solo paso de mejora sube de forma constante a GLM-5 y a Gemini 3.5 Flash sobre su arnés de base, con ganancias de hasta 11,5 puntos en WorkBuddy-Bench, 4,5 en JobBench y 11,8 puntos porcentuales en LAB.
El dato que más llama la atención está en WorkBuddy-Bench: con el arnés mejorado, GLM-5, el modelo de Zhipu AI y la Universidad Tsinghua, supera a Gemini 3.5 Flash, de Google DeepMind, cuando este trabaja con su arnés original. Según Google Cloud AI Research, un modelo más débil con un arnés mejorado puede así superar a uno más fuerte con el suyo de origen.
La letra pequeña
Son pruebas de los propios autores, no una evaluación independiente. Los ejecutores, Gemini 3.5 Flash y GLM-5, trabajan congelados dentro de dos arneses de partida ya hechos: OpenCode, de SST, y Codex, de OpenAI, la creadora de ChatGPT. El editor que reescribe el arnés por defecto es Claude Opus 4.8, de Anthropic, y ese mismo modelo es el juez que puntúa las entregas en JobBench. Las cifras son medias de tres ejecuciones.
Según Google Cloud AI Research, la mejora tampoco depende de un editor más potente: cuando el mismo modelo hace de ejecutor y de editor, los cinco modelos probados, de GLM-5 a Claude Opus 5, mejoran en los tres benchmarks.
El código de Harness² se distribuye con licencia Apache 2.0, y el propio repositorio avisa: «No es un producto con soporte oficial de Google».
Conclusión
Harness² no trae un modelo nuevo, sino una manera de sacar más partido a los que ya existen. Según Google Cloud AI Research, el arnés pesa tanto que un modelo más débil bien equipado adelanta a otro más fuerte; queda que alguien ajeno a sus autores lo compruebe.
Fuentes primarias
- Google Research — README del repositorio google-research/harness2 en GitHub ↗
- Google Cloud AI Research — «Harness²: Recursive Agent Harnessing for an Open World», ficha y resumen en arXiv (2610.14224v1, 09-10-2026) ↗
- Tencent — «Tencent WorkBuddy Bench: A Multi-Domain Coding-Agent Benchmark with Contamination-Resistant Task Construction» (arXiv 2607.20911) ↗
- Google Research — «Cloud AI Research», página del equipo ↗
- Google Cloud AI Research — «Harness²: Recursive Agent Harnessing for an Open World», artículo completo (arXiv 2610.14224v1, 09-10-2026) ↗
- Zhipu AI — «GLM-5: from Vibe Coding to Agentic Engineering» (arXiv 2602.15763v2) ↗
- AI Informator — El arnés, no el modelo: cuatro mecanismos para que un agente no pierda el hilo en tareas largas (13-09-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios