
Agents
Google: l'arnès que s'adoba tot sol
Harness², presentat el 9 d'octubre a arXiv, reescriu a cada tasca les instruccions, la memòria i les eines d'un agent d'IA sense tocar el model. Segons Google Cloud AI Research, que signa el treball amb la Northwestern University, un sol pas de millora suma fins a 11,5 punts a WorkBuddy-Bench.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- Harness² no torna a entrenar el model: canvia el que l'envolta, de les instruccions als subagents, i desa el que ha après per a la tasca següent.
- Segons Google Cloud AI Research, amb l'arnès millorat, GLM-5 supera a WorkBuddy-Bench Gemini 3.5 Flash quan aquest treballa amb el seu arnès de base.
- Les proves són dels mateixos autors, i l'editor que reescriu l'arnès per defecte és Claude Opus 4.8, d'Anthropic.
El mateix model, un altre arnès
Harness² és un marc per millorar l'arnès d'un agent d'IA, signat per investigadors de la Northwestern University i de Google Cloud AI Research i presentat el 9 d'octubre a arXiv, el repositori obert on els investigadors publiquen treballs encara sense revisar. Google Cloud AI Research es presenta com l'equip que investiga per portar la IA als productes i a la infraestructura de Google Cloud, i que explora una nova classe d'agents «Co-X» per automatitzar tasques humanes complexes.
El que canvia no és el model, sinó el que l'envolta. Harness² exposa vuit peces editables: instruccions de sistema (system prompt), regles de seguretat (guardrails), memòria, guia d'ús d'eines, subagents, habilitats (skills), scripts i complements (plugins).
Proposar, provar i compondre
El sistema treballa en dos nivells. En el de la tasca, aplica un pas de contrast que els autors anomenen Propose–Probe–Compose: proposa canvis a l'arnès, en prova l'efecte en la mateixa tasca i compon un arnès millorat a partir de les diferències de comportament entre execucions. No necessita conèixer la resposta correcta, una cosa clau en un món obert, on l'agent es troba amb tasques que ningú no va preveure quan se'n va dissenyar l'arnès.
En el segon nivell, Harness² actualitza un arnès de millora persistent amb els arnesos que ha adoptat i amb les lliçons de cada tasca avalades per proves, per orientar les millores següents. I tot això, sense tocar els pesos del model.
El model feble avança el fort
| Arnès de partida | WorkBuddy-Bench: GLM-5 amb arnès millorat | WorkBuddy-Bench: Gemini 3.5 Flash amb arnès base | JobBench: millora de Gemini 3.5 Flash | JobBench: millora de GLM-5 |
|---|---|---|---|---|
| OpenCode | 75,7 | 72,4 | +4,5 | +3,6 |
| Codex | 75,3 | 74,5 | +1,4 | +1,2 |
Els autors ho van mesurar en tres benchmarks professionals: WorkBuddy-Bench, de Tencent, amb tasques de codi, web i ofimàtica; JobBench, amb feines professionals de principi a fi, i LAB, la prova de treball jurídic de Harvey AI. Segons Google Cloud AI Research, un sol pas de millora fa pujar de manera constant GLM-5 i Gemini 3.5 Flash per sobre del seu arnès de base, amb guanys de fins a 11,5 punts a WorkBuddy-Bench, 4,5 a JobBench i 11,8 punts percentuals a LAB.
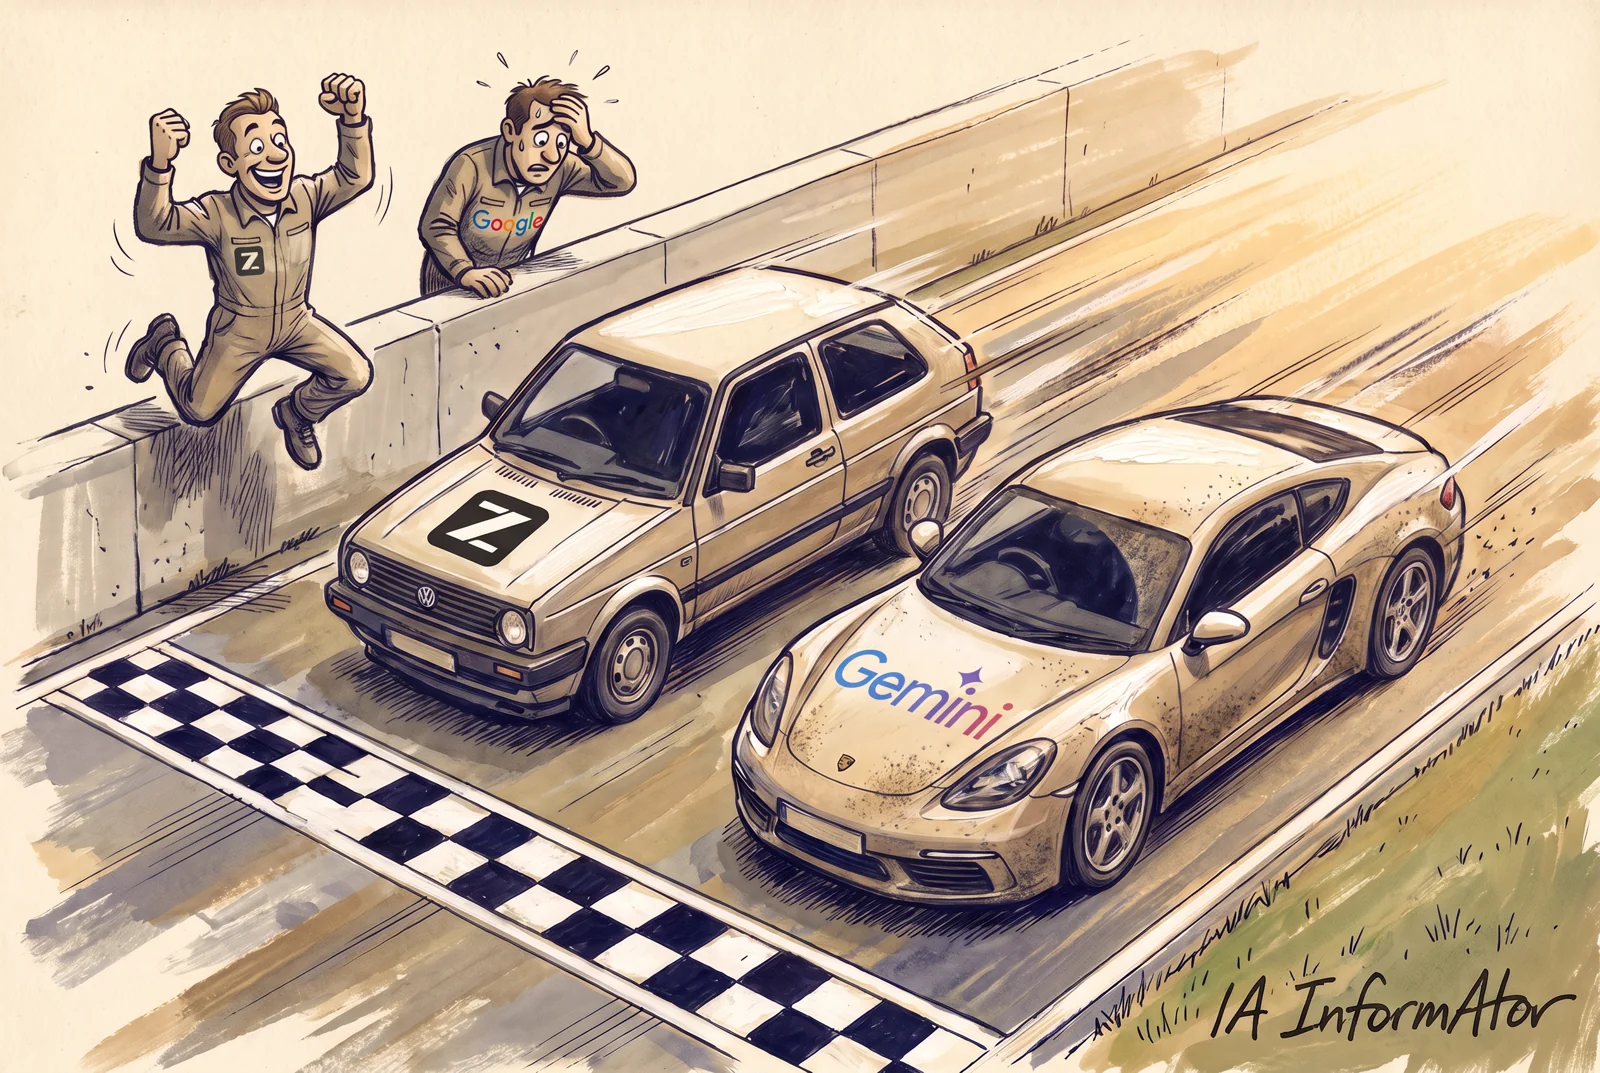
La dada que més crida l'atenció és a WorkBuddy-Bench: amb l'arnès millorat, GLM-5, el model de Zhipu AI i la Tsinghua University, supera Gemini 3.5 Flash, de Google DeepMind, quan aquest treballa amb el seu arnès original. Segons Google Cloud AI Research, un model més feble amb un arnès millorat pot superar així un de més fort que treballa amb el d'origen.
La lletra petita
Són proves dels mateixos autors, no pas una avaluació independent. Els executors, Gemini 3.5 Flash i GLM-5, treballen congelats dins de dos arnesos de partida ja fets: OpenCode, de SST, i Codex, d'OpenAI, la creadora de ChatGPT. L'editor que reescriu l'arnès per defecte és Claude Opus 4.8, d'Anthropic, i aquest mateix model és el jutge que puntua els lliuraments a JobBench. Les xifres són mitjanes de tres execucions.
Segons Google Cloud AI Research, la millora tampoc no depèn d'un editor més potent: quan el mateix model fa d'executor i d'editor, els cinc models provats, de GLM-5 a Claude Opus 5, milloren en els tres benchmarks.
El codi de Harness² es distribueix amb llicència Apache 2.0, i el mateix repositori avisa: «No és un producte amb suport oficial de Google».
Conclusió
Harness² no porta un model nou, sinó una manera de treure més partit dels que ja existeixen. Segons Google Cloud AI Research, l'arnès pesa tant que un model més feble ben equipat avança un altre de més fort; ara cal que algú aliè als autors ho comprovi.
Fonts primàries
- Google Research — README del repositorio google-research/harness2 en GitHub ↗
- Google Cloud AI Research — «Harness²: Recursive Agent Harnessing for an Open World», ficha y resumen en arXiv (2610.14224v1, 09-10-2026) ↗
- Tencent — «Tencent WorkBuddy Bench: A Multi-Domain Coding-Agent Benchmark with Contamination-Resistant Task Construction» (arXiv 2607.20911) ↗
- Google Research — «Cloud AI Research», página del equipo ↗
- Google Cloud AI Research — «Harness²: Recursive Agent Harnessing for an Open World», artículo completo (arXiv 2610.14224v1, 09-10-2026) ↗
- Zhipu AI — «GLM-5: from Vibe Coding to Agentic Engineering» (arXiv 2602.15763v2) ↗
- AI Informator — L'arnès, no el model: quatre mecanismes perquè un agent no perdi el fil en tasques llargues (13-09-2026) ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris