Modelos
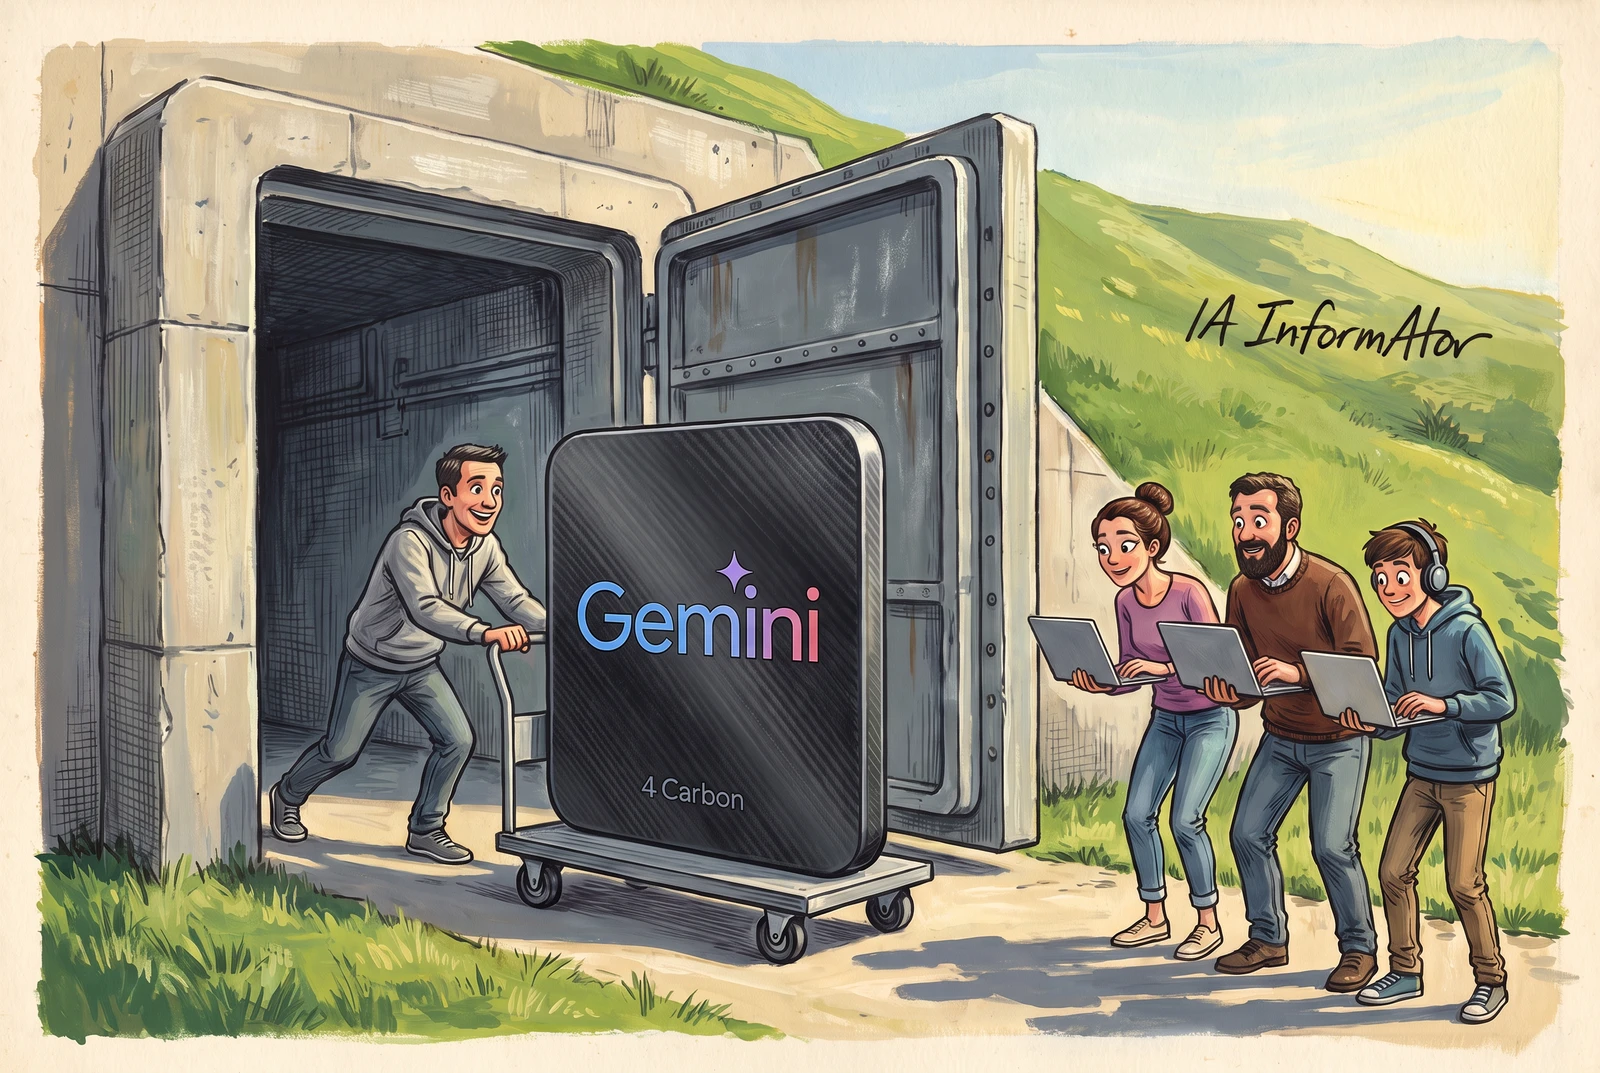
Gemini 4 Carbon sale del búnker
Google abre desde el 10 de noviembre Gemini 4 Carbon, su modelo más potente, que hasta ahora reservaba a equipos de ciberdefensa, a todos los desarrolladores y empresas de pago de su API, a 2 dólares por millón de tokens de entrada y 10 de salida hasta el 30 de noviembre. Según Google, encabeza varias pruebas de programación y automatización; en el índice de Artificial Analysis, una empresa que evalúa modelos por su cuenta, queda por detrás de Claude Fable 5.2, de Anthropic, aunque resolver cada tarea con Carbon sale más barato.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Desde el 10 de noviembre, Gemini 4 Carbon está en la API de Google para todos los clientes de pago y llega a los suscriptores de Google AI Ultra.
- Según Google, cuesta 2 dólares por millón de tokens de entrada y 10 de salida hasta el 30 de noviembre; después, 4 y 20.
- Google lo sitúa primero en CursorBench 4.0, WANDR y AutomationBench, resultados que publica la propia empresa.
- En el Intelligence Index v5.0.1 de Artificial Analysis, Carbon suma 60 puntos, por detrás de los 65 de Claude Fable 5.2.
Del búnker a la API
| Modelo | Entrada | Salida | Vigencia |
|---|---|---|---|
| Gemini 4 Carbon (introductorio) | 2 | 10 | hasta el 30-11-2026 |
| Gemini 4 Carbon | 4 | 20 | desde el 01-12-2026 |
| Gemini 4 Argon (introductorio) | 2 | 10 | hasta el 30-11-2026 |
| Claude Fable 5.2 | 8 | 40 | precio estándar |
Google DeepMind, el laboratorio de IA de Google, anunció el 10 de noviembre que Gemini 4 Carbon ya está disponible para desarrolladores, empresas, científicos y consumidores. Firma la nota Koray Kavukcuoglu, vicepresidente sénior de Google DeepMind y arquitecto jefe de IA de Google, que lo presenta como su último modelo frontier y el más potente de la compañía.
Google lo presentó el 28 de octubre, pero solo para equipos de ciberdefensa de su programa Fairwind, que sigue abierto para ellos.
Ahora llega por la API de Google AI Studio y de Gemini for business a todos los desarrolladores y empresas de pago. Además, se despliega a los suscriptores de Google AI Ultra en Google Antigravity, la app Gemini y el modo IA del buscador.
Según Google, Gemini 4 Argon sigue siendo la opción ideal para la mayor parte del trabajo. Carbon está pensado para lo más exigente, como la depuración compleja de varios pasos o la investigación científica abierta, y gasta más tokens que Argon.
Un equipo de agentes con una sola orden
Con Carbon, Google estrena en vista previa /swarm, una función de Google Antigravity, su plataforma para programar con agentes. Según Google, convierte una sola instrucción en un equipo coordinado de agentes que se sigue en tiempo real.
Carbon asume los papeles que piden más razonamiento, como la arquitectura, la coordinación o la auditoría, junto a modelos más rápidos y ligeros. Los agentes trabajan en paralelo en espacios aislados y otros, verificadores, ponen a prueba cada cambio.
Un ejemplo de Google: una recreación 3D interactiva de cómo se levantó la torre Eiffel a partir de fotos históricas y láminas de ingeniería, con una sola instrucción.
Lo que dice Google de su modelo
Según Google, Carbon es el primero en CursorBench 4.0, de Cursor, el editor de código con IA, y en otras dos pruebas de socios de la empresa, WANDR y AutomationBench, con un coste por tarea inferior a la mitad del que tiene el siguiente mejor modelo externo, que no identifica.
En Multimodal Knowledge Agent (MKA), una prueba nueva para agentes que razonan sobre documentos densos con gráficos, planos y tablas, Carbon queda segundo, siempre según Google, con un coste medio por tarea inferior a la sexta parte del que tiene el primero.
Son resultados que publica Google sobre su propio producto, no una evaluación independiente.
Más seguro que Argon, según Google
| Prueba | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| Tasa de brecha por intento en ataques simulados | 0,8 % | 3,1 % |
| Éxito de consultas automatizadas de ciberataque (Gray Swan) | 2,17 % | 9,86 % |
| Tareas superadas en la prueba de honestidad (375 tareas) | 92 % | 70 % |
Según Google, en ciberataques simulados Carbon bloqueó el 99 % de las trayectorias de un agente atacante que rehace su plan tras cada bloqueo, y la tasa de brecha por intento bajó al 0,8 %.
En las pruebas de Gray Swan, empresa de seguridad de IA fundada por investigadores de la Universidad Carnegie Mellon que hace pruebas adversarias para laboratorios y empresas, el éxito de los ciberataques automatizados bajó al 2,17 %. En su prueba interna de honestidad, Carbon se negó a rellenar datos experimentales que faltaban el 98 % de las veces.
La propia Google admite que la resistencia frente a la inyección de instrucciones (prompt injection) «sigue siendo un área de mejora».
El árbitro externo pone delante a Fable
Ver los datos en tabla
| Coste por tarea del índice (dólares) | Intelligence Index | |
|---|---|---|
| Claude Fable 5.2 (Max) | 26,54 $ | 65 puntos |
| Claude Fable 5.2 (High) | 9,08 $ | 62 puntos |
| Gemini 4 Carbon (High) | 7,76 $ | 60 puntos |
| Claude Opus 5.5 (Max) | 10,04 $ | 59 puntos |
| Modelo | Índice | Coste por tarea | Minutos por tarea | Precio de lista usado (entrada / salida, $ por millón) |
|---|---|---|---|---|
| Claude Fable 5.2 (Max) | 65 | 26,54 $ | 45,2 | 8 / 40 |
| Claude Fable 5.2 (High) | 62 | 9,08 $ | 17,3 | 8 / 40 |
| Gemini 4 Carbon (High) | 60 | 7,76 $ | 25,6 | 4 / 20 |
| Claude Opus 5.5 (Max) | 59 | 10,04 $ | 25,0 | 4 / 20 |
La única medición externa es la de Artificial Analysis. En la versión 5.0.1 de su Intelligence Index, consultada el 11 de noviembre con 104 modelos evaluados, Carbon queda por detrás de Claude Fable 5.2, de Anthropic, la empresa que desarrolla Claude. Lo superan los tres niveles de esfuerzo medidos de Fable; Carbon se evaluó con esfuerzo de razonamiento alto.
El 28 de octubre, con la versión 5.0 del índice, Carbon era el número uno, con 59 puntos. Anthropic presentó Fable 5.2 el 9 de noviembre y Google abrió Carbon al día siguiente.
Para calibrar al árbitro, un dato de la propia Google: Artificial Analysis y Google lanzaron juntos la prueba MKA, que no forma parte del índice.
Según Artificial Analysis, una tarea del índice cuesta menos con Carbon que con los otros tres modelos de la tabla, aunque el cálculo usa su precio de lista, no el introductorio. También lo califica de «notablemente lento» y «muy verboso».
Conclusión
Google ya vende su modelo más potente a cualquier cliente que pague. Según la única medición externa, Carbon no es el primero, porque Fable 5.2 lo supera, pero le sale más barato resolver cada tarea incluso con la tarifa completa, la de 4 y 20 dólares por millón de tokens que regirá desde el 1 de diciembre.
Fuentes primarias
- Google DeepMind — Gemini 4 Carbon is now available (10-11-2026) ↗
- Artificial Analysis — Comparison of AI Models across Intelligence, Performance, and Price (consultada el 11-11-2026) ↗
- Artificial Analysis — Gemini 4 Carbon (high): Intelligence, Performance & Price Analysis (consultada el 11-11-2026) ↗
- Artificial Analysis — Claude Fable 5.2 (max): Intelligence, Performance & Price Analysis (consultada el 11-11-2026) ↗
- Artificial Analysis — Claude Fable 5.2 (high): Intelligence, Performance & Price Analysis (consultada el 11-11-2026) ↗
- Artificial Analysis — Claude Opus 5.5 (max): Intelligence, Performance & Price Analysis (consultada el 11-11-2026) ↗
- Artificial Analysis — About (consultada el 10-11-2026) ↗
- Anthropic — Plans & pricing (consultada el 10-11-2026) ↗
- Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2 (09-11-2026) ↗
- AI Informator — Google corona a Carbon y lo encierra en el búnker (29-10-2026) ↗
- AI Informator — Google abre Gemini 4 Argon a la API y a más suscriptores (14-10-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios