Aprenent IA
Models tabulars: la IA que ja no cal entrenar
Un model fundacional tabular és un model preentrenat una sola vegada que després prediu sobre el full de càlcul de qualsevol sense tornar a entrenar-se: se li ensenyen les files que ja estan resoltes i emplena la que falta. La idea fa anys que funciona amb el text i amb les imatges, però amb les taules —el format de dades més avorrit i més estès que hi ha— ha trigat a arribar, perquè no hi ha un internet de taules per gratar. Això és el que fan per dins, el que costa executar-los i per què «pesos oberts» no vol dir que els puguis fer servir a la feina.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- Un model fundacional tabular es preentrena una sola vegada i després prediu sobre taules que no ha vist mai, sense entrenar un model nou per a cada problema ni ajustar comandaments a mà.
- TabPFN-3.5, de Prior Labs, està preentrenat exclusivament amb dades sintètiques i té 220 milions de paràmetres, davant dels 53 milions de la versió anterior de classificació; la seva variant Fast es queda en 84 milions.
- Com a demostració, i segons les xifres publicades pel seu equip, TabPFN-3.5 va batre la solució guanyadora de la competició Otto de Kaggle del 2015 —0,375 davant de 0,382, i en aquesta mètrica guanya el nombre més baix— amb les dades crues, els ajustos per defecte, al voltant d'un minut en una GPU RTX PRO 6000 i sense haver vist mai aquell conjunt de dades.
- A Causilo, de Nums AI, la crida d'ajust no canvia el model per dins: desa les files d'entrenament com a context i prediu en una sola passada endavant, igual que un model de llenguatge al qual es posen tres exemples al missatge.
- Cap dels dos no es pot portar a producció sense una llicència a part: TabPFN-3.5 distribueix el seu model només per a ús no comercial i Causilo, només per a recerca i avaluació.
Gairebé totes les dades serioses d'una organització viuen en un full de càlcul
Quan es parla d'intel·ligència artificial gairebé sempre es parla de text, d'imatges o de veu. Però les dades amb què treballa de debò gairebé qualsevol organització —un banc, un hospital, una botiga, un ajuntament— no són res d'això: són una taula. Files i columnes, el que cap en un full de càlcul o surt d'una consulta a una base de dades.
Cada fila és un cas: un client, un pacient, una transacció. Cada columna és una característica d'aquest cas: l'edat, l'import, el codi postal, el resultat d'una analítica. I en alguna d'aquestes columnes hi ha el que de debò interessa saber: si el client tornarà el préstec, si la transacció és un frau, quantes unitats es vendran el mes que ve.
La feina consisteix sempre en el mateix: es tenen milers de files en què aquesta columna ja està emplenada i es vol emplenar-la a les files noves. És el problema més avorrit i més estès de l'aprenentatge automàtic, i fins fa ben poc es resolia d'una manera que no s'assemblava gens al que fan els models de llenguatge.
Emplenar aquesta columna es fa de dues maneres, i convé saber quina és quina
La diferència no és un tecnicisme, perquè canvia el que es pot demanar. Una classificació respon «això és un frau» i, si el model és honest, hi afegeix amb quanta seguretat ho diu. Una regressió respon «se'n vendran 4.200 unitats», i aquí la seguretat s'expressa d'una altra manera: donant un recorregut probable en lloc d'una xifra solta.
Els dos models que serveixen d'exemple en aquesta peça fan les dues coses, però no amb els mateixos topalls ni amb les mateixes opcions. Convé tenir-ho present en llegir qualsevol anunci: un model pot ser excel·lent classificant i quedar-se curt en regressió, i les llistes de resultats gairebé mai barregen les dues.
Durant quinze anys, el que millor va funcionar sobre taules no van ser les xarxes neuronals
És un dels pocs racons de l'aprenentatge automàtic on les xarxes neuronals no es van endur el gat a l'aigua. Mentre el text i les imatges canviaven de tecnologia cada dos anys, la predicció sobre taules es continuava fent amb arbres, i funcionava molt bé.
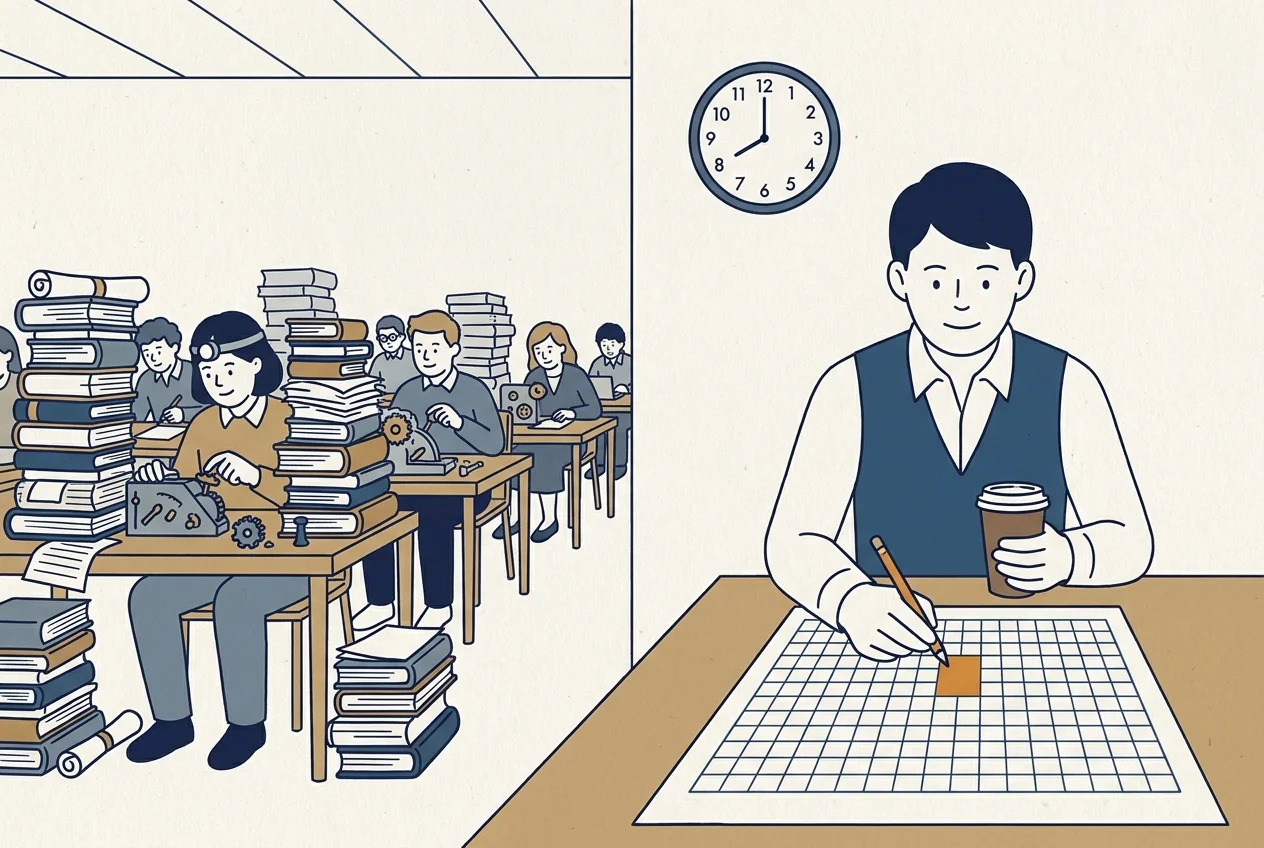
Però aquest mètode té una característica que el defineix: no hi ha un model que serveixi per a tot. Es pren la taula, s'entrena un model a la seva mida i aquest model val per a aquella taula i per a cap més. Si demà arriba un altre conjunt de dades, amb unes altres columnes, es comença de zero. Cada problema, el seu model.
La feina de debò no era entrenar, era ajustar
Entrenar un model d'arbres és barat i ràpid. El car ve després: buscar la combinació de comandaments amb què aquell model rendeix de debò sobre aquella taula concreta. Es fa a mà, amb ofici, o amb una cerca automàtica que prova combinacions fins que una guanya.
Aquest és el cost amagat del mètode clàssic, i no es paga una vegada: es paga amb cada taula nova. Per això la promesa d'un model fundacional tabular no és només «encerta més», sinó «se salta aquest pas». Val la pena guardar aquesta idea, perquè al final de la peça torna convertida en l'argument pràctic de tot plegat.
Les taules han estat les últimes a tenir el seu model fundacional, i el motiu és curiós
Un model de text es preentrena llegint internet, i un model d'imatges, mirant fotos. Què llegeix un model tabular? Aquí hi ha el problema: no existeix un internet de taules. Les taules valuoses són privades —són les dels clients, les dels pacients, les de les vendes— i no estan publicades enlloc.
I hi ha una segona dificultat, més de fons. Qualsevol text està fet de les mateixes paraules, així que un model de llenguatge entrenat amb uns textos n'entén uns altres. Les taules, no: cadascuna té les seves columnes, amb els seus noms, les seves unitats i el seu significat. Una columna anomenada «valor» pot ser euros, un percentatge o un codi. Un model tabular ha de saber tractar columnes que no ha vist mai, sense que ningú li expliqui què són.
No és cosa de dos equips petits: Google és autora del model tabular TabFM i LG AI Research —el centre de recerca en intel·ligència artificial del grup sud-coreà LG— és autor d'EXAONE Tabular. Però els dos exemples amb què s'entén millor la tècnica són TabPFN-3.5 i Causilo, perquè han explicat amb detall com estan fets.
La primera clau: entrenar-lo amb milions de taules que no existeixen
TabPFN-3.5 està preentrenat exclusivament amb dades sintètiques. És la resposta al problema anterior: si no hi ha un internet de taules per gratar, es fabriquen les taules. El model no aprèn fets sobre clients o pacients; aprèn a resoldre el tipus de problema que és una taula.
Això té una conseqüència que sol passar inadvertida i que a Europa pesa: un model preentrenat només amb dades sintètiques no duu a dins les dades personals de ningú, perquè mai no les va veure. El que va veure van ser milions de problemes inventats que s'assemblen als reals.
I té un altre avantatge, menys evident: es pot triar el temari. Qui fabrica els problemes decideix en què insistir, i aquí és on cada equip hi posa el seu criteri sobre quines taules són difícils.
Les taules que més costen són amples, agrupades i d'alta cardinalitat
El generador de dades sintètiques de TabPFN-3.5 està fet per primar taules amples, agrupades i d'alta cardinalitat. Amples vol dir amb moltes columnes. Agrupades, amb files que no són independents entre si perquè pertanyen a un mateix grup: diverses visites d'un mateix pacient, diverses compres d'un mateix client.
Aquests tres trets no estan triats a l'atzar: són exactament els que descriuen les taules d'una empresa de debò, i els que pitjor se'ls donen als mètodes clàssics. Un model entrenat expressament amb problemes així arriba més ben preparat a la taula que li posin al davant.
L'examen que TabPFN-3.5 va aprovar sense haver-lo estudiat
La demostració que el seu equip publica és elegant perquè es pot comprovar. El 2015 es va celebrar a Kaggle —la plataforma de competicions de ciència de dades propietat de Google— la competició Otto, i la solució guanyadora va ser el resultat de mesos de feina d'un equip humà sobre aquell conjunt de dades concret.
TabPFN-3.5 va batre aquesta marca: 0,375 davant de 0,382, i en aquesta mètrica guanya el nombre més baix. Ho va fer amb les dades crues, amb els ajustos per defecte, al voltant d'un minut en una GPU RTX PRO 6000 i sense haver vist mai aquell conjunt de dades, perquè el seu preentrenament és només sintètic.
Convé llegir la dada pel que és. És un resultat verificable sobre un conjunt concret, no una prova que aquests models superin en general els arbres potenciats per gradient. El que hi ha publicat avui són, sobretot, els resultats que cada equip mesura als bancs de proves que tria, i això s'ha de dir cada vegada.
La segona clau: el model no estudia per al teu examen, mira els exemples i respon
Aquest és el punt que més costa i el que de debò explica la diferència. A les biblioteques clàssiques d'aprenentatge automàtic es crida una funció d'ajust per entrenar el model amb les dades. A Causilo aquesta mateixa crida existeix i es fa servir igual, però no fa el que un suposa: no actualitza el model. Desa les files d'entrenament com a context i prou.
La predicció arriba després en una sola passada endavant: el model rep alhora les files resoltes i la fila per resoldre, i contesta. No hi ha cicle d'entrenament, ni èpoques, ni corba de pèrdua per vigilar.
L'analogia que funciona millor és aquesta: no és un alumne que es tanca a estudiar per a un examen concret, és un alumne que ja sap examinar-se i a qui ensenyes el temari just abans de la pregunta. Tot l'esforç es va fer una vegada, al preentrenament; el que passa amb la teva taula és només una lectura.
Per dins, Causilo comprimeix cada fila en tres fases
L'enginyeria d'aquests models rau en com s'encabeix una taula dins d'una xarxa. Causilo ho fa en tres fases. La primera és el refinament: agrupa les característiques de tres en tres i els aplica 16 incrustacions sinus/cosinus apreses, una manera de convertir nombres solts en alguna cosa que la xarxa pugui comparar.
La segona és la compressió: cada fila sencera, tingui les columnes que tingui, es redueix a un vector fix de 512 dimensions. Aquesta és la peça que permet tractar taules amb formes molt diferents amb la mateixa màquina, perquè a partir d'aquí totes les files ocupen el mateix.
La tercera és l'aprenentatge en context pròpiament dit: un bloc de predicció de 12 capes que mira les files resoltes i la fila per resoldre i dona la resposta. I per damunt de tot plegat hi ha el truc d'escala dels tokens latents, que és el que fa viable treballar amb taules amples.
A TabPFN-3.5 tant li fa que la columna vingui en euros o en logaritmes
TabPFN-3.5 introdueix dues peces amb aquest propòsit: característiques de Fourier apreses —ones de freqüències diferents amb què el model representa un nombre, en comptes de prendre'l tal qual— i rangs ECDF calculats en context, que substitueixen cada valor per la proporció de files que queden per sota d'ell.
L'efecte és el que descriu el requadre: tant li fa en quines unitats vingui la columna. En el mètode clàssic, decidir si una variable hi entra en brut, en logaritme o normalitzada és part de l'ofici i consumeix hores. Aquí deixa de ser una decisió.
No és un detall menor per a qui hagi de fer servir això: bona part de la feina d'un científic de dades no és modelar, és preparar columnes. Tot el que el model s'empassa tal qual és temps que no es gasta.
Són models petits al costat dels de llenguatge
| Model | Paràmetres | Files màximes | Llicència dels pesos |
|---|---|---|---|
| TabPFN-3.5 | 220 milions | 1 milió | no comercial |
| TabPFN-3.5-Fast (alfa) | 84 milions | — | no comercial |
| TabPFN-3 (anterior) | 53 milions (classificació) | — | no comercial |
| Causilo | no publicat | — | recerca (Causilo License v1.0) |
Aquí hi ha una de les sorpreses. Un model fundacional tabular no cal que sigui gegant: TabPFN-3.5 té 220 milions de paràmetres, quatre vegades més que els 53 milions de la versió anterior de classificació, i la seva variant Fast, encara en alfa, es queda en 84 milions.
La mida importa per una raó molt concreta: decideix si el model cap en la targeta gràfica que un té. I com que aquests models són petits, caben en moltes més màquines que un model de llenguatge.
Llegir-ne més: MarkTechPost — Prior Labs Releases TabPFN-3.5 ↗
Cadascun declara els seus propis límits, i són el primer que cal mirar
TabPFN-3.5 declara que admet fins a un milió de files, amb 6.000 característiques recomanades i fins a 20.000 admeses. Són xifres que cobreixen de sobres la taula d'una empresa mitjana, i convé comprovar-les abans que cap altra: un model excel·lent que no accepti el teu nombre de columnes no serveix de res.
Causilo declara classificació de fins a 10 classes i admet valors absents —caselles buides, que en una taula real són la norma— i característiques categòriques, les columnes el contingut de les quals és una etiqueta i no un nombre. A la seva versió 1.0.1 hi afegeix regressió de mediana i de quantils, amb 999 quantils natius.
Aquest últim detall és més important del que sembla. Un model que dona quantils no respon «se'n vendran 4.200 unitats», respon «el més probable són 4.200, i en el pitjor dels casos raonables, 2.900». Amb aquesta segona resposta es pot planificar un magatzem; amb la primera, no.
Executar-los costa, i no hi ha un guanyador únic
| Model | Ajust (s) | Predicció (s) | Memòria de GPU |
|---|---|---|---|
| Causilo | 2,504 | 0,251 | 8,15 GiB |
| TabICLv2 | 3,449 | 0,303 | 8,37 GiB |
| TabPFN-3 | 4,18 | 0,686 | 0,88 GiB |
Nums AI ha publicat un mesurament de les tres opcions en una mateixa targeta, una GPU H100, i per cada 1.000 files. L'interessant no és qui guanya, sinó que ningú no guanya en tot. TabICLv2, un altre model tabular inclòs a la comparació, queda al mig en temps d'ajust i de predicció, però és el que més memòria de GPU demana dels tres.
Causilo és el més ràpid en ajust i en predicció, però demana 8,15 GiB de memòria de GPU. TabPFN-3 és el més lent dels tres i, alhora, el que menys memòria necessita: 0,88 GiB, gairebé deu vegades menys que els altres dos. En una targeta petita, el lent és l'únic que arrenca.
Com sempre amb les xifres de rendiment, cal dir qui les mesura. Aquestes les mesura i les comunica Nums AI, que és l'autora d'un dels tres models comparats.
Per comparar models tabulars hi ha un banc de proves comú
Un banc de proves comú és l'única manera que dos anuncis siguin comparables. Quan cada equip tria les seves taules, tots guanyen a les seves; quan tots passen per les mateixes 51, les diferències comencen a significar alguna cosa.
Això no treu que cada equip publiqui a més els seus propis mesuraments, que és el que passa a la major part dels anuncis. És informació útil, però no és el mateix, i es llegeix d'una altra manera.
Dos anuncis poden dir tots dos que són els primers sense que cap menteixi
D'aquí surt la lliçó pràctica de tota la peça, la que serveix per llegir qualsevol anunci d'ara endavant: una puntuació Elo només té sentit dins de la seva pròpia llista i contra els seus propis rivals. Canvia la llista i canvia el nombre, sense que ningú hagi fet trampa.
Per això poden coincidir dos anuncis que es declaren primers i ser tots dos certs. Es comparen contra llistes diferents, o mesuren coses diferents, o un acota la seva afirmació amb una matisació que el titular es menja. Abans de creure's un primer lloc cal preguntar tres coses: en quina llista, contra qui i amb quina acotació.
Un conjunt de models no competeix a la mateixa categoria que un de sol
És l'acotació més freqüent i la que més s'escola. Nums AI anuncia Causilo com a primer de TabArena entre models individuals; aquestes tres últimes paraules deixen fora els conjunts, que són precisament el que sol ocupar el capdavant d'aquestes llistes.
No és un retret: acotar és el correcte, i l'acotació està dita. El problema apareix quan es repeteix el titular sense ella. Un model individual que guanya altres models individuals és una fita real i una cosa molt concreta, i és exactament això el que s'està dient.
«Pesos oberts» no vol dir que el puguis fer servir a la teva empresa
És la lletra petita que decideix si això es pot fer servir a la feina, i en tots dos casos diu que no sense més tràmit. TabPFN-3.5 publica pesos oberts només per a ús no comercial, sota la llicència tabpfn-3-license-v1.0; per a producció cal l'API de Prior Labs o una llicència comercial, i les variants Plus i Thinking són només d'API o per acord amb l'empresa.
Causilo reparteix la cosa en dues: el codi va amb llicència Apache-2.0, que sí que és lliure, però els pesos van sota Causilo License v1.0, només per a recerca i avaluació, i l'ús comercial exigeix una llicència a part.
La conclusió honesta és aquesta: en tots dos casos es pot descarregar, estudiar i avaluar el model, i en tots dos casos cal negociar abans de posar-lo a decidir sobre clients de debò. És un model de negoci perfectament legítim, però convé saber-ho abans de muntar-hi un pilot al damunt.
El coll d'ampolla d'una empresa mitjana no és la targeta gràfica
Els casos on això importa són els de sempre, i són molts: predir l'impagament d'un préstec, detectar frau en una transacció, estimar la demanda d'un producte, prioritzar quins pacients es visiten abans. Tots són taules, i en tots hi ha una columna que algú vol emplenar abans que passi.
El que canvia no és tant encertar una mica més com qui ho pot fer. Una empresa mitjana no s'encalla per falta de GPU: s'encalla perquè ningú de la casa no sap ajustar els comandaments d'un model d'arbres, i contractar qui en sàpiga costa més que el problema que es vol resoldre.
Un model que dona un resultat competitiu amb les dades crues i els ajustos per defecte ataca justament aquest punt. No substitueix el criteri —continua fent falta saber què es prediu, amb quines dades i amb quines conseqüències—, però treu del mig el peatge tècnic que deixava fora gairebé tothom.
Conclusió
Un model fundacional tabular no és un model de llenguatge més petit: és una altra manera d'encarar el problema més comú de l'aprenentatge automàtic, la de preentrenar una vegada amb problemes fabricats i després limitar-se a llegir la taula que li posin al davant. Les dues peces que ho fan possible són les dades sintètiques, que resolen la manca de taules públiques, i l'aprenentatge en context, que substitueix l'entrenament per una sola passada endavant. El que queda per veure és el de sempre: avui les xifres les publica i les mesura, sobretot, qui ven el model, i els bancs de proves comuns com TabArena tot just comencen a posar tothom a la mateixa llista. I encara que la tècnica convenci, la llicència continua manant: mentre els pesos es reparteixin per a recerca i l'ús comercial vagi a part, això es podrà estudiar a qualsevol lloc i desplegar a ben pocs.
Fonts primàries
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentarios