Aprendiendo IA
Modelos tabulares: la IA que ya no hay que entrenar
Un modelo fundacional tabular es un modelo preentrenado una sola vez que después predice sobre la hoja de cálculo de cualquiera sin volver a entrenarse: se le enseñan las filas que ya están resueltas y rellena la que falta. La idea lleva años funcionando con el texto y con las imágenes, pero con las tablas —el formato de datos más aburrido y más extendido que existe— ha tardado en llegar, porque no hay un internet de tablas que rascar. Esto es lo que hacen por dentro, lo que cuesta ejecutarlos y por qué «pesos abiertos» no quiere decir que puedas usarlos en el trabajo.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Un modelo fundacional tabular se preentrena una sola vez y después predice sobre tablas que no ha visto nunca, sin entrenar un modelo nuevo para cada problema ni ajustar mandos a mano.
- TabPFN-3.5, de Prior Labs, está preentrenado exclusivamente con datos sintéticos y tiene 220 millones de parámetros, frente a los 53 millones de la versión anterior de clasificación; su variante Fast se queda en 84 millones.
- Como demostración, y según las cifras publicadas por su equipo, TabPFN-3.5 batió la solución ganadora de la competición Otto de Kaggle de 2015 —0,375 frente a 0,382, y en esa métrica gana el número más bajo— con los datos crudos, los ajustes por defecto, en torno a un minuto en una GPU RTX PRO 6000 y sin haber visto nunca ese conjunto de datos.
- En Causilo, de Nums AI, la llamada de ajuste no cambia el modelo por dentro: guarda las filas de entrenamiento como contexto y predice en una sola pasada hacia delante, igual que un modelo de lenguaje al que se le ponen tres ejemplos en el mensaje.
- Ninguno de los dos se puede llevar a producción sin una licencia aparte: TabPFN-3.5 distribuye su modelo solo para uso no comercial y Causilo, solo para investigación y evaluación.
Casi todo el dato serio de una organización vive en una hoja de cálculo
Cuando se habla de inteligencia artificial casi siempre se habla de texto, de imágenes o de voz. Pero el dato con el que trabaja de verdad casi cualquier organización —un banco, un hospital, una tienda, un ayuntamiento— no es nada de eso: es una tabla. Filas y columnas, lo que cabe en una hoja de cálculo o sale de una consulta a una base de datos.
Cada fila es un caso: un cliente, un paciente, una transacción. Cada columna es una característica de ese caso: la edad, el importe, el código postal, el resultado de una analítica. Y en alguna de esas columnas está lo que de verdad interesa saber: si el cliente devolverá el préstamo, si la transacción es un fraude, cuántas unidades se venderán el mes que viene.
El trabajo consiste siempre en lo mismo: se tienen miles de filas en las que esa columna ya está rellena y se quiere rellenarla en las filas nuevas. Es el problema más aburrido y más extendido del aprendizaje automático, y hasta hace muy poco se resolvía de una manera que no se parecía en nada a lo que hacen los modelos de lenguaje.
Rellenar esa columna se hace de dos maneras, y conviene saber cuál es cuál
La diferencia no es un tecnicismo, porque cambia lo que se puede pedir. Una clasificación responde «esto es un fraude» y, si el modelo es honesto, añade con cuánta seguridad lo dice. Una regresión responde «se venderán 4.200 unidades», y ahí la seguridad se expresa de otra forma: dando un recorrido probable en lugar de una cifra suelta.
Los dos modelos que sirven de ejemplo en esta pieza hacen las dos cosas, pero no con los mismos topes ni con las mismas opciones. Conviene tenerlo presente al leer cualquier anuncio: un modelo puede ser excelente clasificando y quedarse corto en regresión, y las listas de resultados casi nunca mezclan las dos.
Durante quince años, lo que mejor funcionó sobre tablas no fueron las redes neuronales
Es uno de los pocos rincones del aprendizaje automático donde las redes neuronales no se llevaron el gato al agua. Mientras el texto y las imágenes cambiaban de tecnología cada dos años, la predicción sobre tablas se seguía haciendo con árboles, y funcionaba muy bien.
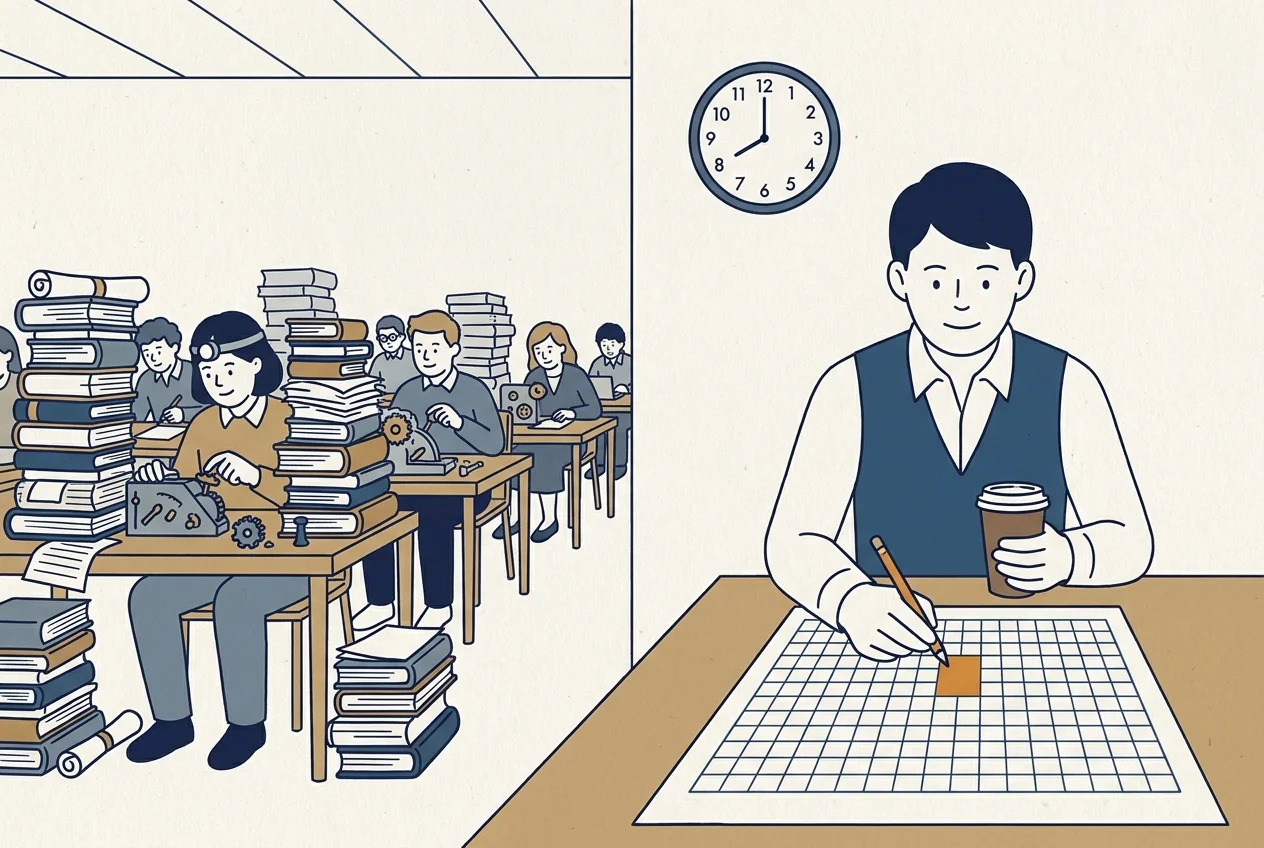
Pero ese método tiene una característica que lo define: no hay un modelo que sirva para todo. Se toma la tabla, se entrena un modelo a su medida y ese modelo vale para esa tabla y para ninguna otra. Si mañana llega otro conjunto de datos, con otras columnas, se empieza de cero. Cada problema, su modelo.
El trabajo de verdad no era entrenar, era ajustar
Entrenar un modelo de árboles es barato y rápido. Lo caro es lo de después: buscar la combinación de mandos con la que ese modelo rinde de verdad sobre esa tabla concreta. Se hace a mano, con oficio, o con una búsqueda automática que prueba combinaciones hasta que una gana.
Ese es el coste escondido del método clásico, y no se paga una vez: se paga con cada tabla nueva. Por eso la promesa de un modelo fundacional tabular no es solo «acierta más», sino «se salta ese paso». Merece la pena guardar esta idea, porque al final de la pieza vuelve convertida en el argumento práctico de todo esto.
Las tablas han sido lo último en tener su modelo fundacional, y el motivo es curioso
Un modelo de texto se preentrena leyendo internet, y un modelo de imágenes, mirando fotos. ¿Qué lee un modelo tabular? Ahí está el problema: no existe un internet de tablas. Las tablas valiosas son privadas —son las de los clientes, las de los pacientes, las de las ventas— y no están publicadas en ninguna parte.
Y hay una segunda dificultad, más de fondo. Cualquier texto está hecho de las mismas palabras, así que un modelo de lenguaje entrenado con unos textos entiende otros. Las tablas, no: cada una tiene sus columnas, con sus nombres, sus unidades y su significado. Una columna llamada «valor» puede ser euros, un porcentaje o un código. Un modelo tabular tiene que saber tratar columnas que no ha visto jamás, sin que nadie le explique qué son.
No es cosa de dos equipos pequeños: Google es autora del modelo tabular TabFM y LG AI Research —el centro de investigación en inteligencia artificial del grupo surcoreano LG— es autor de EXAONE Tabular. Pero los dos ejemplos con los que se entiende mejor la técnica son TabPFN-3.5 y Causilo, porque han explicado con detalle cómo están hechos.
La primera clave: entrenarlo con millones de tablas que no existen
TabPFN-3.5 está preentrenado exclusivamente con datos sintéticos. Es la respuesta al problema anterior: si no hay un internet de tablas que rascar, se fabrican las tablas. El modelo no aprende hechos sobre clientes o pacientes; aprende a resolver el tipo de problema que es una tabla.
Esto tiene una consecuencia que suele pasar desapercibida y que en Europa pesa: un modelo preentrenado solo con datos sintéticos no lleva dentro los datos personales de nadie, porque nunca los vio. Lo que vio fueron millones de problemas inventados que se parecen a los reales.
Y tiene otra ventaja, menos evidente: se puede elegir el temario. Quien fabrica los problemas decide en qué insistir, y ahí es donde cada equipo mete su criterio sobre qué tablas son difíciles.
Las tablas que más cuestan son anchas, agrupadas y de alta cardinalidad
El generador de datos sintéticos de TabPFN-3.5 está hecho para primar tablas anchas, agrupadas y de alta cardinalidad. Anchas quiere decir con muchas columnas. Agrupadas, con filas que no son independientes entre sí porque pertenecen a un mismo grupo: varias visitas de un mismo paciente, varias compras de un mismo cliente.
Esos tres rasgos no están elegidos al azar: son exactamente los que describen las tablas de una empresa de verdad, y los que peor se le dan a los métodos clásicos. Un modelo entrenado a propósito con problemas así llega mejor preparado a la tabla que le pongan delante.
El examen que TabPFN-3.5 aprobó sin haberlo estudiado
La demostración que su equipo publica es elegante porque se puede comprobar. En 2015 se celebró en Kaggle —la plataforma de competiciones de ciencia de datos propiedad de Google— la competición Otto, y la solución ganadora fue el resultado de meses de trabajo de un equipo humano sobre ese conjunto de datos concreto.
TabPFN-3.5 batió esa marca: 0,375 frente a 0,382, y en esa métrica gana el número más bajo. Lo hizo con los datos crudos, con los ajustes por defecto, en torno a un minuto en una GPU RTX PRO 6000 y sin haber visto nunca ese conjunto de datos, porque su preentrenamiento es solo sintético.
Conviene leer el dato por lo que es. Es un resultado verificable sobre un conjunto concreto, no una prueba de que estos modelos superen en general a los árboles potenciados por gradiente. Lo que hay publicado hoy son, sobre todo, los resultados que cada equipo mide en los bancos de pruebas que elige, y eso hay que decirlo cada vez.
La segunda clave: el modelo no estudia para tu examen, mira los ejemplos y responde
Este es el punto que más cuesta y el que de verdad explica la diferencia. En las bibliotecas clásicas de aprendizaje automático se llama a una función de ajuste para entrenar el modelo con los datos. En Causilo esa misma llamada existe y se usa igual, pero no hace lo que uno supone: no actualiza el modelo. Guarda las filas de entrenamiento como contexto y ya está.
La predicción llega después en una sola pasada hacia delante: el modelo recibe a la vez las filas resueltas y la fila por resolver, y contesta. No hay ciclo de entrenamiento, ni épocas, ni curva de pérdida que vigilar.
La analogía que mejor funciona es esta: no es un alumno que se encierra a estudiar para un examen concreto, es un alumno que ya sabe examinarse y al que le enseñas el temario justo antes de la pregunta. Todo el esfuerzo se hizo una vez, en el preentrenamiento; lo que pasa con tu tabla es solo una lectura.
Por dentro, Causilo comprime cada fila en tres fases
La ingeniería de estos modelos está en cómo se mete una tabla dentro de una red. Causilo lo hace en tres fases. La primera es el refinamiento: agrupa las características de tres en tres y les aplica 16 incrustaciones seno/coseno aprendidas, una manera de convertir números sueltos en algo que la red pueda comparar.
La segunda es la compresión: cada fila entera, tenga las columnas que tenga, se reduce a un vector fijo de 512 dimensiones. Esa es la pieza que permite tratar tablas con formas muy distintas con la misma máquina, porque a partir de ahí todas las filas ocupan lo mismo.
La tercera es el aprendizaje en contexto propiamente dicho: un bloque de predicción de 12 capas que mira las filas resueltas y la fila por resolver y da la respuesta. Y por encima de todo ello está el truco de escala de los tokens latentes, que es lo que hace viable trabajar con tablas anchas.
A TabPFN-3.5 le da igual que la columna venga en euros o en logaritmos
TabPFN-3.5 introduce dos piezas con ese propósito: características de Fourier aprendidas —ondas de distintas frecuencias con las que el modelo representa un número, en vez de tomarlo tal cual— y rangos ECDF calculados en contexto, que sustituyen cada valor por la proporción de filas que quedan por debajo de él.
El efecto es el que describe la cajita: da lo mismo en qué unidades venga la columna. En el método clásico, decidir si una variable entra en bruto, en logaritmo o normalizada es parte del oficio y consume horas. Aquí deja de ser una decisión.
No es un detalle menor para quien vaya a usar esto: buena parte del trabajo de un científico de datos no es modelar, es preparar columnas. Todo lo que el modelo se traga tal cual es tiempo que no se gasta.
Son modelos pequeños al lado de los de lenguaje
| Modelo | Parámetros | Filas máximas | Licencia de los pesos |
|---|---|---|---|
| TabPFN-3.5 | 220 millones | 1 millón | no comercial |
| TabPFN-3.5-Fast (alfa) | 84 millones | — | no comercial |
| TabPFN-3 (anterior) | 53 millones (clasificación) | — | no comercial |
| Causilo | no publicado | — | investigación (Causilo License v1.0) |
Aquí está una de las sorpresas. Un modelo fundacional tabular no necesita ser gigante: TabPFN-3.5 tiene 220 millones de parámetros, cuatro veces más que los 53 millones de la versión anterior de clasificación, y su variante Fast, todavía en alfa, se queda en 84 millones.
El tamaño importa por una razón muy concreta: decide si el modelo cabe en la tarjeta gráfica que uno tiene. Y como estos modelos son pequeños, caben en muchas más máquinas que un modelo de lenguaje.
Cada uno declara sus propios límites, y son lo primero que hay que mirar
TabPFN-3.5 declara que admite hasta un millón de filas, con 6.000 características recomendadas y hasta 20.000 soportadas. Son cifras que cubren de sobra la tabla de una empresa mediana, y conviene comprobarlas antes que ninguna otra: un modelo excelente que no acepte tu número de columnas no sirve para nada.
Causilo declara clasificación de hasta 10 clases y admite valores ausentes —celdas vacías, que en una tabla real son la norma— y características categóricas, las columnas cuyo contenido es una etiqueta y no un número. En su versión 1.0.1 añade regresión de mediana y de cuantiles, con 999 cuantiles nativos.
Ese último detalle es más importante de lo que parece. Un modelo que da cuantiles no responde «se venderán 4.200 unidades», responde «lo más probable es 4.200, y en el peor de los casos razonables, 2.900». Con esa segunda respuesta se puede planificar un almacén; con la primera, no.
Ejecutarlos cuesta, y no hay un ganador único
| Modelo | Ajuste (s) | Predicción (s) | Memoria de GPU |
|---|---|---|---|
| Causilo | 2,504 | 0,251 | 8,15 GiB |
| TabICLv2 | 3,449 | 0,303 | 8,37 GiB |
| TabPFN-3 | 4,18 | 0,686 | 0,88 GiB |
Nums AI ha publicado una medición de las tres opciones en una misma tarjeta, una GPU H100, y por cada 1.000 filas. Lo interesante no es quién gana, sino que nadie gana en todo. TabICLv2, otro modelo tabular incluido en la comparación, queda en medio en tiempo de ajuste y de predicción, pero es el que más memoria de GPU pide de los tres.
Causilo es el más rápido en ajuste y en predicción, pero pide 8,15 GiB de memoria de GPU. TabPFN-3 es el más lento de los tres y, a la vez, el que menos memoria necesita: 0,88 GiB, casi diez veces menos que los otros dos. En una tarjeta pequeña, el lento es el único que arranca.
Como siempre con las cifras de rendimiento, hay que decir quién las mide. Estas las mide y las comunica Nums AI, que es la autora de uno de los tres modelos comparados.
Para comparar modelos tabulares hay un banco de pruebas común
Un banco de pruebas común es la única forma de que dos anuncios sean comparables. Cuando cada equipo elige sus tablas, todos ganan en las suyas; cuando todos pasan por las mismas 51, las diferencias empiezan a significar algo.
Eso no quita que cada equipo publique además sus propias mediciones, que es lo que ocurre en la mayor parte de los anuncios. Es información útil, pero no es lo mismo, y se lee distinto.
Dos anuncios pueden decir los dos que son los primeros sin mentir ninguno
De aquí sale la lección práctica de toda la pieza, la que sirve para leer cualquier anuncio de aquí en adelante: una puntuación Elo solo tiene sentido dentro de su propia lista y contra sus propios rivales. Cambia la lista y cambia el número, sin que nadie haya hecho trampa.
Por eso pueden coincidir dos anuncios que se declaran primeros y ser los dos ciertos. Se comparan contra listas distintas, o miden cosas distintas, o uno acota su afirmación con una coletilla que el titular se come. Antes de creerse un primer puesto hay que preguntar tres cosas: en qué lista, contra quién y con qué acotación.
Un conjunto de modelos no compite en la misma categoría que uno solo
Es la acotación más frecuente y la que más se cuela. Nums AI anuncia Causilo como primero de TabArena entre modelos individuales; esas tres últimas palabras dejan fuera a los conjuntos, que son precisamente lo que suele ocupar la cabeza de estas listas.
No es un reproche: acotar es lo correcto, y la acotación está dicha. El problema aparece cuando se repite el titular sin ella. Un modelo individual que gana a otros modelos individuales es un logro real y una cosa muy concreta, y es exactamente eso lo que se está diciendo.
«Pesos abiertos» no quiere decir que puedas usarlo en tu empresa
Es la letra pequeña que decide si esto se puede usar en el trabajo, y en los dos casos dice que no sin más trámite. TabPFN-3.5 publica pesos abiertos solo para uso no comercial, bajo la licencia tabpfn-3-license-v1.0; para producción hace falta la API de Prior Labs o una licencia comercial, y las variantes Plus y Thinking son solo de API o de acuerdo con la empresa.
Causilo reparte la cosa en dos: el código va con licencia Apache-2.0, que sí es libre, pero los pesos van bajo Causilo License v1.0, solo para investigación y evaluación, y el uso comercial exige una licencia aparte.
La conclusión honesta es esta: en los dos casos se puede descargar, estudiar y evaluar el modelo, y en los dos casos hay que negociar antes de ponerlo a decidir sobre clientes de verdad. Es un modelo de negocio perfectamente legítimo, pero conviene saberlo antes de montar un piloto encima.
El cuello de botella de una empresa mediana no es la tarjeta gráfica
Los casos donde esto importa son los de siempre, y son muchos: predecir el impago de un préstamo, detectar fraude en una transacción, estimar la demanda de un producto, priorizar qué pacientes se ven antes. Todos son tablas, y en todos hay una columna que alguien quiere rellenar antes de que ocurra.
Lo que cambia no es tanto acertar un poco más como quién puede hacerlo. Una empresa mediana no se atasca por falta de GPU: se atasca porque nadie de la casa sabe ajustar los mandos de un modelo de árboles, y contratar a quien sepa cuesta más que el problema que se quiere resolver.
Un modelo que da un resultado competitivo con los datos crudos y los ajustes por defecto ataca justo ese punto. No sustituye al criterio —sigue haciendo falta saber qué se predice, con qué datos y con qué consecuencias—, pero quita del medio el peaje técnico que dejaba fuera a casi todo el mundo.
Conclusión
Un modelo fundacional tabular no es un modelo de lenguaje más pequeño: es otra forma de encarar el problema más común del aprendizaje automático, la de preentrenar una vez con problemas fabricados y después limitarse a leer la tabla que le pongan delante. Las dos piezas que lo hacen posible son los datos sintéticos, que resuelven la falta de tablas públicas, y el aprendizaje en contexto, que sustituye el entrenamiento por una sola pasada hacia delante. Lo que queda por ver es lo de siempre: hoy las cifras las publica y las mide, sobre todo, quien vende el modelo, y los bancos de pruebas comunes como TabArena apenas están empezando a poner a todos en la misma lista. Y aunque la técnica convenza, la licencia sigue mandando: mientras los pesos se repartan para investigación y el uso comercial vaya aparte, esto se podrá estudiar en cualquier sitio y desplegar en muy pocos.
Fuentes primarias
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios