
Aprenent IA
El mateix preu per token, gairebé vuit vegades més car
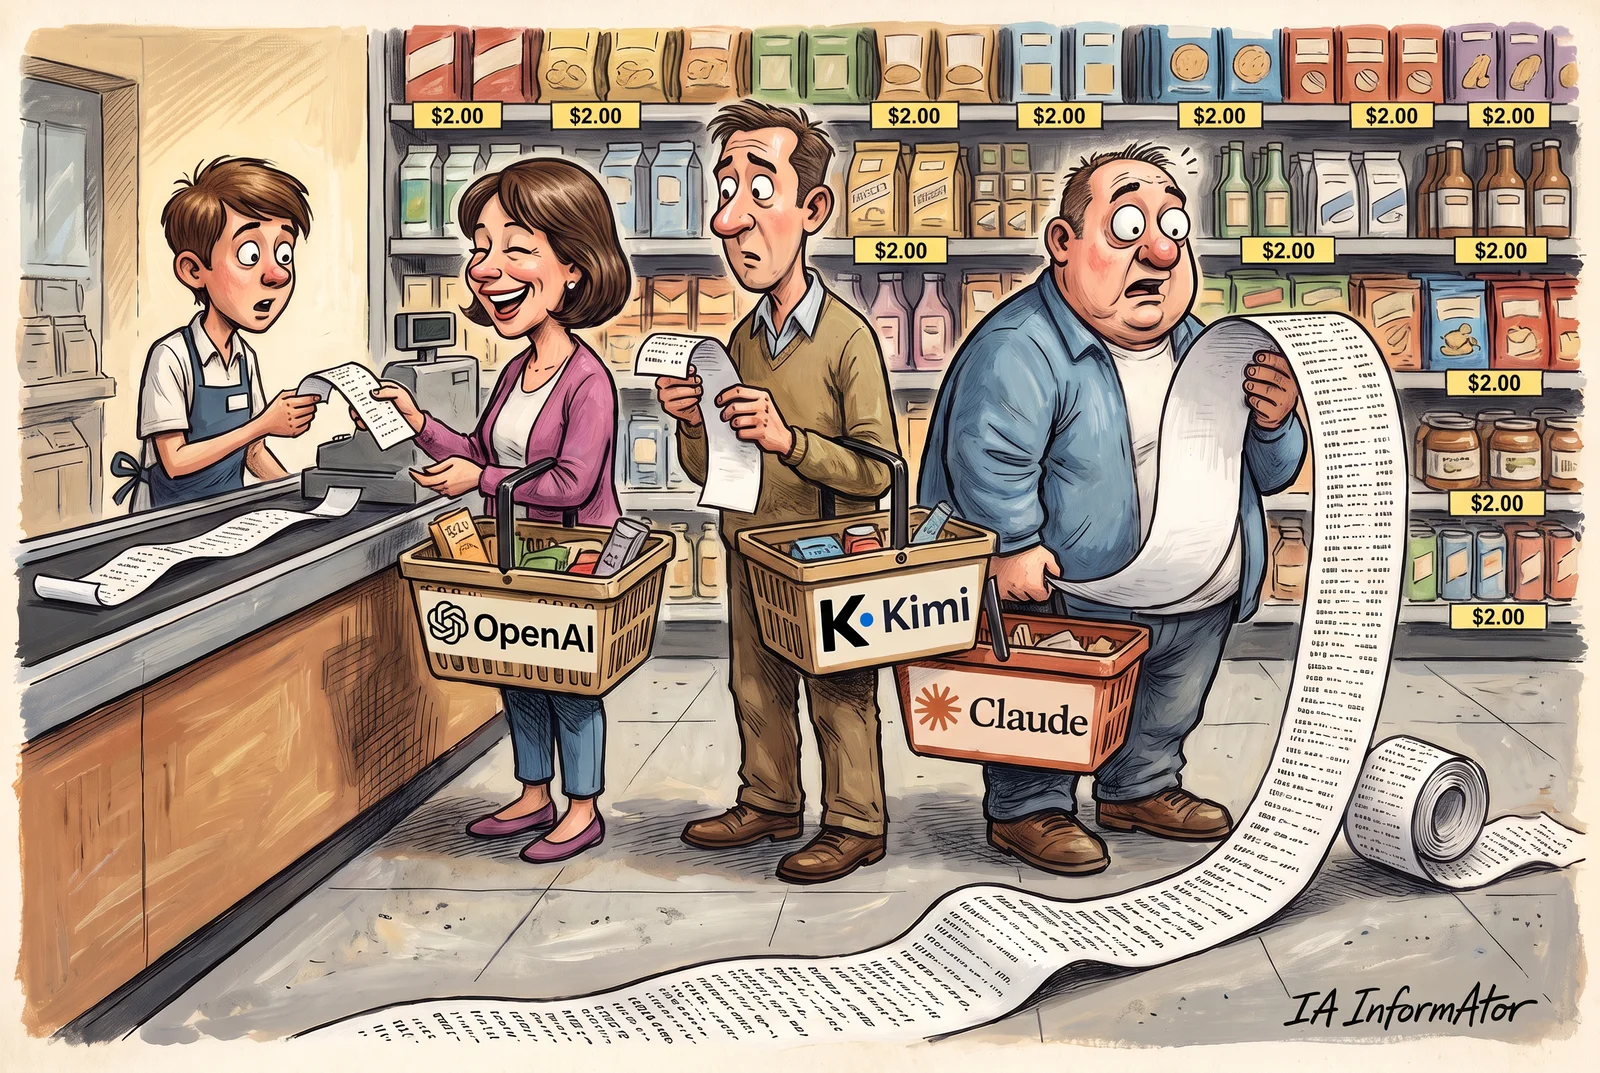
GPT-6.1 Sol, Kimi K3.1 Pro i Claude Sonnet 5.5 cobren el mateix, 2 dòlars per milió de tokens d'entrada i 10 per milió de sortida, però acabar una tasca amb cadascun costa 1,27, 3,68 i 10,02 dòlars, segons l'índex que Artificial Analysis, una empresa que avalua models d'IA, va publicar el 27 d'octubre. El preu per token no és el cost per tasca: aquí tens el càlcul i el mètode per fer-lo amb la teva pròpia feina abans de triar model.
En resum
- Amb la mateixa tarifa per token, el cost per tasca de GPT-6.1 Sol, Kimi K3.1 Pro i Claude Sonnet 5.5 va d'1,27 a 10,02 dòlars a l'Intelligence Index v5.0 d'Artificial Analysis: 7,9 vegades de diferència.
- El que canvia és quant escriu cada model: per recórrer l'índex sencer, GPT-6.1 Sol va gastar 64 milions de tokens de sortida i Claude Sonnet 5.5, 340 milions.
- GPT-6 Astra és el més car per token de la comparativa i, tot i així, cada tasca li surt un 38 % més barata que a Claude Sonnet 5.5.
- El càlcul el pots fer tu: OpenRouter retorna a cada resposta els tokens gastats i l'import cobrat, i n'hi ha prou de repetir la mateixa tasca unes quantes vegades amb cada model.
- Moonshot AI promet publicar els pesos (open weights) de Kimi K3.1 Pro com a molt tard el 4 de novembre; a 28 d'octubre encara no són públics.
Tres models amb la mateixa tarifa i tres factures
Anthropic cobra per Claude Sonnet 5.5 el mateix que OpenAI per GPT-6.1 Sol, i Moonshot AI, l'empresa de Pequín que desenvolupa els models Kimi, va posar aquesta mateixa tarifa a Kimi K3.1 Pro, que va llançar el 23 d'octubre: 2 dòlars per milió de tokens d'entrada i 10 per milió de sortida. Amb aquesta etiqueta, qualsevol diria que tant és quin triïs.
No és igual. A l'Intelligence Index v5.0 d'Artificial Analysis, acabar una tasca va costar 1,27 dòlars amb GPT-6.1 Sol, 3,68 amb Kimi K3.1 Pro i 10,02 amb Claude Sonnet 5.5. Amb el mateix preu per token, el més car gasta 7,9 vegades el que gasta el més barat.
El motiu és que la tarifa diu quant val cada token, però no quants en necessitarà el model. Aquest nombre depèn de com treballa: quant raona abans de respondre, quant escriu i quantes vegades torna sobre la feina feta. Aquí tens el mètode: com es fa el càlcul i com comprovar-lo amb la teva pròpia tasca.
Set models mesurats amb el mateix criteri
| Model (esforç) | Entrada ($/M tokens) | Sortida ($/M tokens) | Cost per tasca | Tokens de sortida (índex sencer) | Puntuació v5.0 |
|---|---|---|---|---|---|
| GPT-6.1 Sol (max) | 2,00 | 10,00 | 1,27 $ | 64 M | 55 |
| Kimi K3.1 Pro | 2,00 | 10,00 | 3,68 $ | 110 M | 46 |
| Claude Sonnet 5.5 (max) | 2,00 | 10,00 | 10,02 $ | 340 M | 54 |
| Claude Opus 5.5 (max) | 4,00 | 20,00 | 10,04 $ | 220 M | 58 |
| GPT-6 Astra (max) | 10,00 | 50,00 | 6,24 $ | 54 M | 57 |
| GLM-5.3 (max) | 1,40 | 4,40 | 5,01 $ | 140 M | 32 |
| DeepSeek V4.1 Flash 1017 (max) | 0,30 | 1,20 | 0,60 $ | 170 M | 32 |
La versió 5.0 de l'índex es va publicar el 27 d'octubre. La taula reuneix set models amb el que cobra cadascun per token i el que li va costar, per tasca, recórrer l'índex. Tots estan mesurats pel mateix tercer i amb el mateix mètode, de manera que les xifres es poden comparar entre si.
De la taula en surten tres lliçons. La primera ja l'hem vista: tres models amb la mateixa tarifa i factures d'1,27 a 10,02 dòlars. I pagar més no compra més nota: GPT-6.1 Sol puntua 55, un punt més que Claude Sonnet 5.5.
La segona, que el més car per token pot sortir barat. GPT-6 Astra cobra cinc vegades més que Sonnet 5.5 per token, però per tasca costa un 38 % menys, perquè escriu 6,3 vegades menys tokens de sortida.
La tercera és la inversa. GLM-5.3, de Z.ai —la marca de Zhipu AI, empresa de Pequín que cotitza a la borsa de Hong Kong com a Knowledge Atlas—, cobra menys de la meitat que Kimi K3.1 Pro en sortida (4,40 dòlars davant de 10) i 1,4 vegades menys en entrada, i per tasca costa un 36 % més. A l'extrem barat, DeepSeek V4.1 Flash cobra entre 7 i 17 vegades menys per token que K3.1 Pro, segons el tipus de token i l'hora.
El càlcul, a mà
| Concepte | Model A | Model B |
|---|---|---|
| Tokens d'entrada | 20.000 | 20.000 |
| Tokens de sortida | 5.000 | 15.000 |
| Cost d'entrada (tokens × 2 / 1.000.000) | 0,04 $ | 0,04 $ |
| Cost de sortida (tokens × 10 / 1.000.000) | 0,05 $ | 0,15 $ |
| Cost de la tasca | 0,09 $ | 0,19 $ |
La fórmula cap en una línia: cost d'una tasca = (tokens d'entrada × preu d'entrada + tokens de sortida × preu de sortida) / 1.000.000, amb els preus en dòlars per milió de tokens. Si una part de l'entrada es llegeix de la memòria cau, aquests tokens se sumen a part, a la seva pròpia tarifa.
Un exemple didàctic, amb números rodons inventats per fer el càlcul, no mesurats: una tasca en què el model llegeix 20.000 tokens, resolta per dos models amb la mateixa tarifa de 2 i 10 dòlars. El model A escriu 5.000 tokens; el B, el triple. L'entrada els costa el mateix, la sortida del B costa el triple i la seva factura total, una mica més del doble.
A la taula d'Artificial Analysis passa el mateix a escala real: per recórrer l'índex sencer, GPT-6.1 Sol va escriure 64 milions de tokens de sortida i Sonnet 5.5, 340 milions, més de cinc vegades més.
L'esforç multiplica la sortida
A la taula d'Artificial Analysis, gairebé tots els models apareixen amb l'esforç al màxim, «max», que és l'ajust en què més raonen. Si la teva tasca no en necessita tant, abaixar l'esforç és la palanca més directa per abaratir cada tasca, i convé mesurar-la igual que es mesura un canvi de model.
A la taula de Terminal-Bench de més avall, Moonshot dona per a Kimi K3.1 Pro dos graons d'esforç, i el més alt encerta més i costa més per tasca, segons les seves pròpies dades.
La conseqüència pràctica: el cost per tasca d'un model no és una xifra fixa. Quan comparis, fes servir el mateix esforç en tots o, millor encara, prova uns quants graons i queda't amb el més baix que resolgui bé la teva tasca.
La memòria cau abarateix el que es repeteix
A Kimi K3.1 Pro, per exemple, llegir de la memòria cau costa 0,20 dòlars per milió de tokens, una desena part dels 2 dòlars de l'entrada normal. Si la teva tasca envia sempre el mateix context llarg i només canvia la pregunta, la memòria cau pot canviar molt la factura.
I aquí tampoc no són iguals els tres models que cobren el mateix per token: la lectura de memòria cau de Claude Sonnet 5.5 i la de GPT-6.1 Sol costen la meitat que la de K3.1 Pro.
Per aprofitar-la, la part que es repeteix ha d'arribar idèntica a cada petició; com s'activa depèn de cada proveïdor, així que consulta'n la documentació. A la prova del final, el camp `cached_tokens` et diu quants tokens s'han llegit de la memòria cau.
Kimi K3.1 Pro: tarifa més baixa, la mateixa factura
| Model | Entrada ($/M tokens) | Sortida ($/M tokens) | Memòria cau ($/M tokens) | Tokens de sortida per tasca | Cost per tasca |
|---|---|---|---|---|---|
| Kimi K3 | 3,00 | 15,00 | 0,30 | 48.000 | Pràcticament igual que K3.1 Pro |
| Kimi K3.1 Pro | 2,00 | 10,00 | 0,20 | 55.000 | 1,98 $ |
Kimi K3.1 Pro és l'exemple de manual. Moonshot li va abaixar la tarifa un 33 % respecte a Kimi K3, en entrada, en sortida i en memòria cau. Però el model nou escriu més: segons Artificial Analysis, gastava 55.000 tokens de sortida per tasca, un 14 % més que els 48.000 de K3. Resultat: el cost per tasca es va quedar pràcticament igual, en 1,98 dòlars.
Compte amb les versions de l'índex. Aquestes xifres són de la versió 4.3, la vigent el dia del llançament, en què K3.1 Pro va treure 55 punts i va quedar quart. El 27 d'octubre Artificial Analysis va estrenar la versió 5.0, amb un altre conjunt de proves, i en aquesta en treu 46 i costa 3,68 dòlars per tasca. Les dues versions no es poden comparar entre si: quan llegeixis una puntuació, mira de quina versió és.
Els pesos, promesos per al 4 de novembre
Kimi K3.1 Pro encara no és un model de pesos oberts. Moonshot promet publicar els pesos complets com a molt tard el 4 de novembre de 2026 i no ha anunciat amb quina llicència. A 28 d'octubre, Artificial Analysis el classifica com a propietari i anota que els pesos no s'han publicat.
Per al cost importa per una raó: mentre els pesos no es publiquin, la tarifa de K3.1 Pro és la que fixa Moonshot. Si arriben i la llicència ho permet, altres proveïdors el podran oferir amb els seus propis preus, i caldrà tornar a mesurar el cost per tasca amb cadascun.
Terminal-Bench: la dada que posa Moonshot
| Model (esforç) | Entrada / sortida ($/M tokens) | Cost per tasca | Encert | Qui ho mesura |
|---|---|---|---|---|
| GPT-6.1 Sol (max) | 2 / 10 | 1,92 $ | 58,2 % | tbench.ai |
| Kimi K3.1 Pro (max) | 2 / 10 | ≈5,2 $ | 65,7 % | Moonshot [dada del fabricant, lectura del seu gràfic] |
| Kimi K3.1 Pro (high) | 2 / 10 | ≈4,1 $ | ≈53 % | Moonshot [dada del fabricant, lectura del seu gràfic] |
| GPT-6 Astra (max) | 10 / 50 | 9,90 $ | 58,2 % | tbench.ai |
| Claude Opus 5.5 (max) | 4 / 20 | 14,30 $ | 64,9 % | tbench.ai |
| Claude Sonnet 5.5 (max) | 2 / 10 | 22,22 $ | 61,8 % | tbench.ai |
| GLM-5.3 (max) | 1,40 / 4,40 | 8,27 $ | 41,8 % | tbench.ai |
Moonshot va presentar K3.1 Pro amb un gràfic de Terminal-Bench 4.0 en què el model surt a uns 5 dòlars per tasca, davant dels 14,30 de Claude Opus 5.5. Aquest cost de K3.1 Pro el va mesurar la mateixa Moonshot: el model no figura a la classificació pública de tbench.ai, el web de la prova, que es presenta com a allotjat per Stanford, Harbor i el Laude Institute, una organització a cavall entre l'acadèmia i la indústria finançada per tecnòlegs a títol individual.
Els costos dels rivals sí que surten de tbench.ai, però el gràfic de Moonshot deixa fora GPT-6.1 Sol, que en aquesta classificació encerta el 58,2 % de les tasques a 1,92 dòlars cadascuna, amb el mateix preu per token que K3.1 Pro. Entre els models que mesura tbench.ai amb aquesta tarifa, GPT-6.1 Sol torna a ser el més barat per tasca i Sonnet 5.5, el més car.
Les puntuacions també canvien segons qui mesuri, com recull la nota de la taula. Per això aquestes dades van a part de la primera taula: és una altra prova, amb un altre mètode, i no es barregen a la mateixa columna.
Fes-ho tu: la mateixa tasca en dos models
Les taules de tercers mesuren les seves tasques, no les teves. Per saber quin model et surt més barat, el més fiable és mesurar-ho amb la teva pròpia feina, i no cal muntar res complicat.
Pas 1: tria una tasca real i decideix abans de començar què compta com a ben resolta: el codi passa les proves, el resum recull els punts clau, la classificació coincideix amb la teva. Sense aquest criteri no sabràs què estàs pagant.
Pas 2: envia el mateix prompt, amb el mateix esforç, als models que vulguis comparar a través d'OpenRouter, un servei que encamina peticions a molts models de laboratoris diferents.
Pas 3: llegeix l'objecte `usage` de cada resposta. Segons la documentació d'OpenRouter, arriba en totes sense demanar res més i inclou `prompt_tokens` (entrada), `completion_tokens` (sortida), `total_tokens`, `completion_tokens_details.reasoning_tokens` (els de raonament), `prompt_tokens_details.cached_tokens` (els llegits de la memòria cau) i `cost`, que la documentació defineix com l'import total carregat al teu compte i presenta com a cost en crèdits.
Pas 4: repeteix. Una execució no és una mitjana: el mateix model pot gastar més o menys tokens en dos intents de la mateixa tasca. Artificial Analysis i Terminal-Bench fan la mitjana de moltes tasques; Terminal-Bench, en concret, de 330 intents per model i esforç. No en necessites tants, però sí uns quants per model.
Pas 5: divideix. Suma el `cost` de totes les execucions d'un model i divideix-lo entre les que han resolt bé la tasca. Aquest és el seu cost per tasca resolta, la xifra que compara de debò: un model barat que falla la meitat de les vegades et fa pagar dos intents per cada encert.
Conclusió
La tarifa per token és el preu de la matèria primera; el que pagues és la feina acabada. Amb el mateix preu per token, GPT-6.1 Sol, Kimi K3.1 Pro i Claude Sonnet 5.5 costen per tasca d'1,27 a 10,02 dòlars a l'índex d'Artificial Analysis, i amb la teva tasca l'ordre pot ser un altre. La regla per triar és una: el cost per tasca resolta, mesurat amb els teus prompts, el teu esforç i el teu criteri d'encert, no la tarifa ni la puntuació que un altre va treure a la seva prova. I convé repetir el càlcul quan canviï alguna cosa: un model nou, una altra versió de l'índex o, en el cas de K3.1 Pro, uns pesos que arribin a altres proveïdors.
Fonts primàries
- Artificial Analysis — Artificial Analysis Intelligence Index v5 (27-10-2026) ↗
- Artificial Analysis — Kimi K3.1 Pro (ficha del modelo) ↗
- Artificial Analysis — Kimi K3.1 Pro launch benchmarks (23-10-2026) ↗
- Artificial Analysis — About ↗
- Kimi (Moonshot AI) — Kimi K3.1 Pro ↗
- Kimi API — Pricing ↗
- Kimi API — Kimi K3.1 Pro quickstart ↗
- Moonshot AI — About ↗
- TechCrunch — China's Moonshot AI raises $2B at $20B valuation (07-05-2026) ↗
- Terminal-Bench — Leaderboard ↗
- Laude Institute — About ↗
- OpenRouter — Usage Accounting ↗
- Anthropic — Pricing ↗
- OpenAI — API pricing ↗
- Z.ai — Pricing ↗
- DeepSeek — Models & Pricing ↗
- AI Informator — Sonnet 5.5: la mitad por token y un 28 % más por tarea (02-10-2026) ↗
- AI Informator — Sol y Sonnet: Empate a 2 y 10 dólares (30-09-2026) ↗
- AI Informator — Kimi K3.1 Pro ya se puede usar (24-10-2026) ↗
La continuació natural
Aprèn IA al teu ritme amb els nostres cursos gratuïts.
A la nostra plataforma d'aprenentatge TAKU podràs accedir a aquest i a molts altres cursos de manera totalment gratuïta.
APRENDRE AMB TAKU
Comentaris