Aprenent IA
Els secrets de la marca d'aigua de Claude
La marca d'aigua de Claude no escriu res invisible ni amaga metadades: intervé en l'instant en què el model tria cada paraula i deixa que una clau secreta decideixi quina de les candidates igual de vàlides surt sortejada. Ho expliquen així, amb les mateixes peces, l'anàlisi independent que l'ha mesurada i la mateixa Anthropic a la pàgina on explica el seu sistema. D'aquesta arquitectura se'n dedueixen totes les propietats: aguanta una edició lleugera, cau amb una reescriptura, va sencera en una traducció i gairebé desapareix en codi.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- La marca d'aigua de Claude es basa en SynthID-Text, l'esquema que Google DeepMind va publicar a la revista Nature el 2024, i Anthropic la resumeix a la seva pròpia pàgina, del 14 d'agost del 2026, en una frase: la marca només canvia la font de l'aleatorietat amb què es tria entre paraules.
- No s'insereix res al text ni hi ha caràcters ocults: la clau secreta fixa els valors pseudoaleatoris que decideixen quina de diverses paraules igual d'acceptables surt triada a cada pas, i el detector recalcula aquests valors amb la mateixa clau i puntua el passatge per la mitjana de tots els seus tokens.
- Dos casos ensenyen el mecanisme millor que una definició: quan Claude corregeix un text d'una persona gairebé no queda res on la marca es pugui agafar, i quan tradueix la marca hi va sencera, perquè aleshores cada paraula la tria ell.
- A la mesura independent que Alexander Nemecek, Vipin Chaudhary i Erman Ayday van publicar el 9 de setembre del 2026, el detector va arribar a un AUROC de 0,78 i 0,82 en prosa, però de 0,55 i 0,57 en codi, on 0,5 és exactament l'atzar; Anthropic diu, pel seu costat, que allà on la sortida ha de ser exacta la marca ni tan sols s'aplica.
- Entre el 25 % i el 31 % de les mostres de codi van sortir idèntiques, caràcter a caràcter, amb marca i sense, perquè en codi el model gairebé no té res a triar.
La marca no s'afegeix al text: s'aplica en l'instant de triar cada paraula
Una marca d'aigua estadística d'aquest tipus actua en el moment en què el model tria cada paraula. Entre les candidates que considera acceptables, afavoreix lleugerament les que una clau secreta assenyala. Al text no se li afegeix res i el text es llegeix amb normalitat, perquè cap de les paraules triades no era impròpia: simplement va resultar ser l'assenyalada.
Un detector que guardi aquesta mateixa clau sí que pot comptar amb quina freqüència apareixen les tries afavorides i, sobre un passatge llarg, jutjar si el text va sortir del model. D'aquí ve el nom de la família: marques basades en el mostreig, sampling-based en la literatura tècnica, perquè el mostreig és l'únic punt on intervenen.
Anthropic, l'empresa que desenvolupa Claude, ho diu amb les mateixes paraules a la pàgina on explica com funciona la seva marca, publicada el 14 d'agost del 2026 i actualitzada l'1 de setembre: al text no se li afegeix res i no hi ha caràcters ocults. Ni un espai de més, ni un caràcter invisible entre paraules, ni un camp amagat dins del fitxer.
No hi ha, doncs, cap caràcter que buscar ni cap camp que esborrar. El que hi ha és un patró repartit per tot el passatge, i només és llegible per a qui tingui la clau.
La primera família de marques decanta la balança abans del sorteig
Les marques estadístiques de text es reparteixen en dues famílies, i la distinció és el moll de l'os. La primera, anomenada distortion-based, és la que van descriure Kirchenbauer i els seus coautors el 2023: la clau parteix el vocabulari en dos conjunts i apuja la puntuació d'un d'ells abans de mostrejar.
L'efecte és que la distribució deixa de ser la que el model havia calculat. El text continua sent correcte, però ja no és el que hauria sortit sense marca, i aquesta desviació es pot mesurar. Aquesta és la família que apareix en gairebé totes les explicacions divulgatives del tema, i no és la de Claude.
La família de Claude no toca la balança: manipula el sorteig
El cost de deformar la distribució es paga justament aquí: en la primera família es pot expressar com una pujada de perplexitat. La segona família, distortion-free, neix de no voler-lo pagar.
En aquesta, la distribució del següent token es deixa intacta i la marca viatja en la font d'aleatorietat amb què es mostreja. La clau fixa els valors pseudoaleatoris que decideixen quina de diverses paraules igual d'acceptables surt sortejada, de manera que qualsevol resposta individual queda distribuïda exactament com hauria quedat sense marca d'aigua.
SynthID-Text pertany a aquesta segona família, i la marca d'aigua que Anthropic aplica a les respostes de Claude es basa en SynthID-Text. És la confusió més fàcil de cometre quan s'explica: el vocabulari de conjunts de paraules i puntuacions apujades descriu la família contrària, no la que porta Claude.
SynthID-Text tria la paraula amb un torneig entre candidates
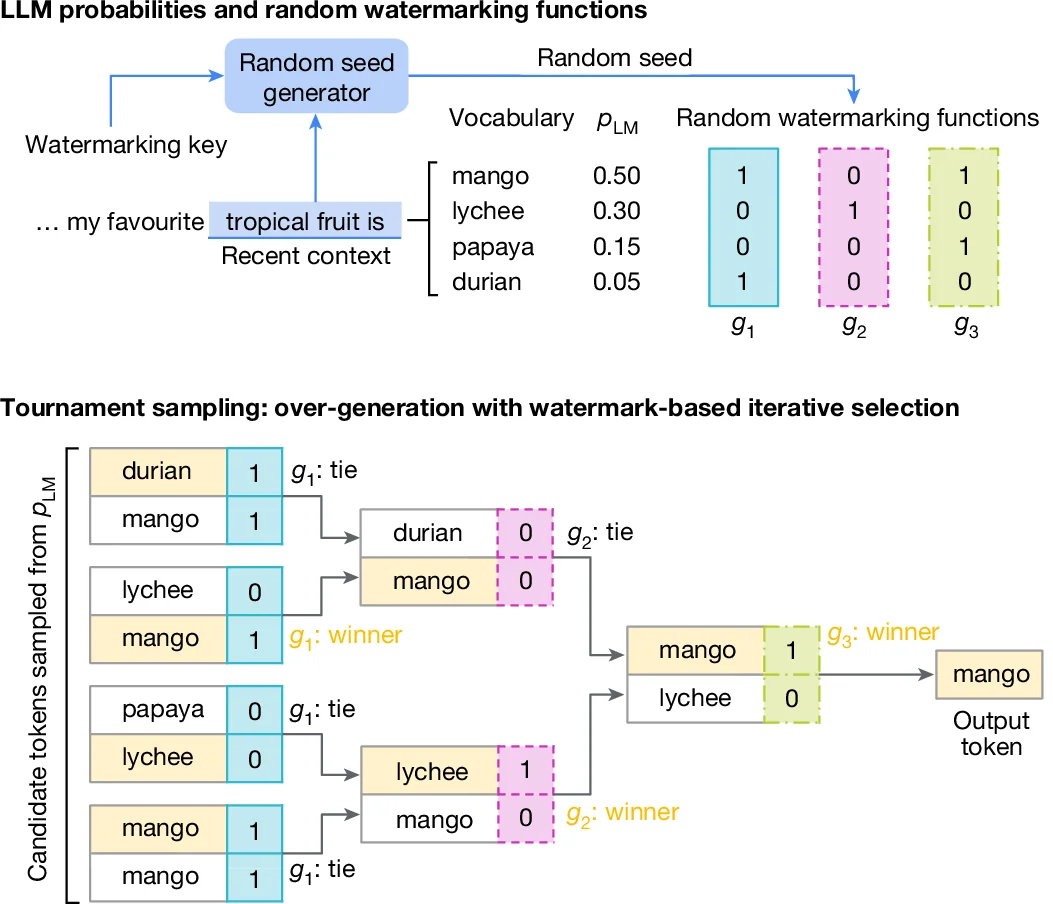
El mecanisme, pas a pas: a cada posició, el sistema mostreja diverses paraules candidates de la distribució del següent token i assigna a cadascuna un valor pseudoaleatori —un g-value— derivat de la clau i dels tokens anteriors. Després les fa competir en un torneig on avança la candidata amb el g-value més alt.
El nombre de capes del torneig és el comandament del sistema: com més capes, amb més força s'imposa la preferència de la clau. Amb poques, la marca queda tènue; amb moltes, el sorteig queda més dirigit.
El detector fa el camí invers. Recalcula el g-value de cada token del text amb la mateixa clau i puntua el passatge per la mitjana d'aquests valors; un llindar sobre aquesta mitjana decideix el veredicte.
Aquesta és, en una frase, la resposta a com es tria la paraula: no es canvia quines paraules són acceptables, es canvia quina de les acceptables surt sortejada.
Anthropic ho explica igual: la marca només canvia la font de l'atzar
La descripció del fabricant encaixa amb la de l'anàlisi independent fins i tot en l'ordre de les peces. Diu així: en comptes de fer servir un generador de nombres aleatoris qualsevol per triar la paraula següent, la marca d'aigua utilitza la clau i unes quantes de les paraules anteriors per determinar quina paraula ha de triar el model.
I situa l'esquema en una genealogia. La marca de text de Claude és una versió de l'enfocament SynthID-Text que Google DeepMind va publicar a Nature el 2024, i aquest pertany a una família de propostes que es remunta a una de Scott Aaronson del 2022, totes amb el mateix principi de disseny: en paraules d'Anthropic, la marca només canvia la font de l'aleatorietat que es fa servir per triar entre paraules.
La pàgina ho il·lustra amb una partida de Monopoly en què els moviments, en comptes de sortir dels daus, surten dels dígits de pi. La partida es juga igual, perquè l'única cosa que s'ha substituït és d'on ve l'atzar. La diferència és fora del tauler: qui sàpiga que les tirades venien de pi pot comprovar després la partida; qui no ho sàpiga hi veu tirades corrents.
Que l'explicació del fabricant i la del treball independent coincideixin importa. Una és la descripció de qui va construir el sistema, que des de fora no es pot comprovar; l'altra és la lectura de qui ha estudiat l'esquema sense tenir la clau de ningú. Quan totes dues descriuen la mateixa màquina amb les mateixes peces, entendre-la deixa de dependre de creure'n una.
La puntuació és acumulativa, i per això mana la llargada del passatge
- Gemma-2-9B
- Llama-3.1-8B
Ver los datos en tabla
| 200 tokens | 400 tokens | |
|---|---|---|
| Gemma-2-9B | 39% | 59% |
| Llama-3.1-8B | 39% | 56% |
Com que el detector puntua per la mitjana de tots els tokens, cada paraula del passatge hi aporta el seu sumand. Un text curt ofereix pocs sumands i la mitjana és inestable; un de llarg n'ofereix molts i la mitjana s'assenta. La marca no és en cap lloc concret del text: està repartida per tot el text.
A la mesura independent, la taxa d'encerts del detector sobre prosa millora de manera acusada en passar de dos-cents a quatre-cents tokens, i ho fa pràcticament igual en els dos models provats: no és la peculiaritat d'un model, és l'aritmètica d'una mitjana que necessita termes.
Anthropic diu el mateix del seu sistema desplegat: la detecció no funciona bé en mostres petites, on hi ha menys tries de paraula i, per tant, menys informació d'on estirar, i a mesura que el passatge s'allarga augmenta la confiança sobre si Claude hi va intervenir. És la mateixa mitjana explicada des de l'altra banda del taulell.
Una edició lleugera la deixa passar; una reescriptura completa l'esborra
D'aquesta mateixa aritmètica en surt la propietat que més se cita. Canviar unes quantes paraules mou uns quants sumands i la mitjana amb prou feines se'n ressent. Reescriure el text sencer substitueix tots els sumands per tokens que la clau no va triar, i la mitjana cau al nivell d'un text qualsevol.
Anthropic ho formula així: fins a cert punt, sí que es pot treure; una edició lleugera probablement no esborri la marca del tot, i una reescriptura completa en què se substitueixi cada paraula sí que ho farà. Convé llegir-ho com el que és, l'afirmació de la mateixa empresa sobre el seu sistema i no una avaluació externa, però és també el que prediu l'aritmètica de la mitjana.
I hi afegeix un incís que mereix que ens hi aturem. En el cas de la reescriptura completa, diu, és discutible que el text es pugui continuar descrivint com a generat per intel·ligència artificial. Si s'ha substituït cada paraula, el que esborra la marca és que ja no queda cap paraula triada pel model: el mètode no falla, es queda sense objecte.
El límit conegut de tota la família va en la mateixa direcció i està documentat des d'abans: parafrasejar i traduir redueixen substancialment la detectabilitat, segons un treball de Krishna i els seus coautors del 2023 que el preprint recull entre les referències. Google reconeix aquesta mateixa debilitat davant la paràfrasi i la traducció a la seva pròpia publicació.
Corregir i traduir: dos casos que ensenyen el mecanisme millor que una definició
Hi ha dos casos que ensenyen el mecanisme millor que qualsevol definició, i els explica la mateixa Anthropic. El primer: quan Claude corregeix un text escrit per una persona, el que retorna està en general només lleugerament editat i, com que gairebé totes les paraules són de la persona, hi ha molt poc —si és que hi ha res— on la marca es pugui agafar.
El segon és just el contrari. Una traducció feta per Claude sí que porta marca, i la porta sencera, perquè en aquest cas cada paraula la tria ell: traduir un text ja marcat n'esborra bona part del senyal, però traduir amb Claude el crea de nou.
Posats l'un al costat de l'altre, els dos casos diuen la idea central sense cap fórmula: la marca s'agafa a les paraules que tria el model, i a cap més. No mesura de qui és la idea ni quanta feina ha fet la màquina; compta tries seves, i on no n'hi ha no hi ha res a comptar.
Per això el mateix sistema es queda gairebé mut davant d'un document que Claude ha repassat de dalt a baix i parla alt i clar davant d'una traducció de la mateixa llargada. La diferència és en quantes de les paraules finals van sortir d'un sorteig seu.
El senyal depèn del tot de quanta tria va tenir el model
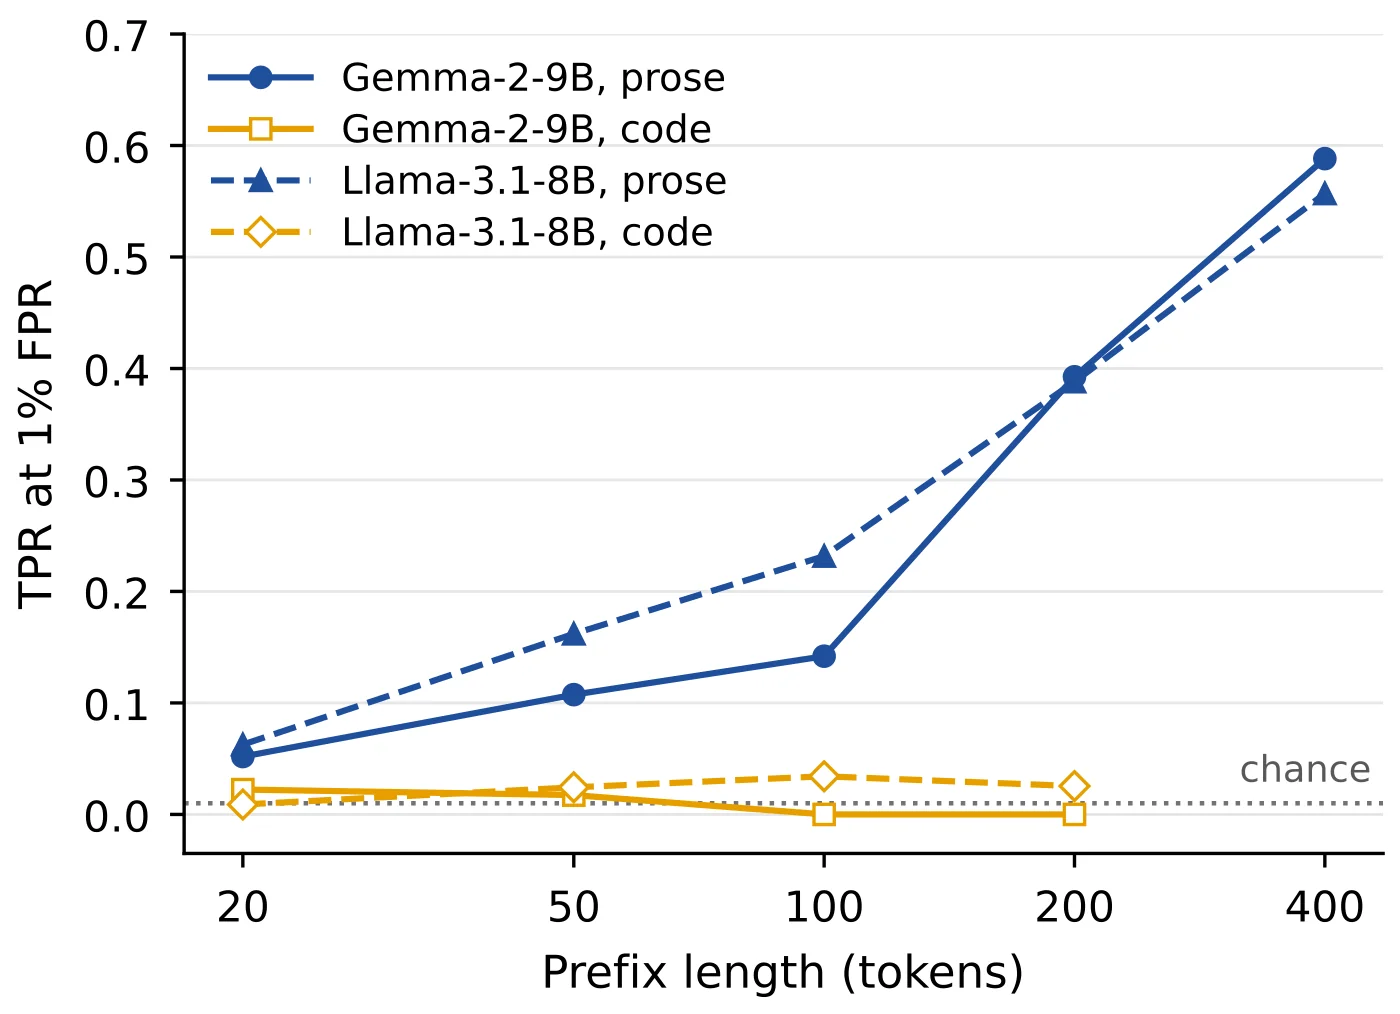
Aquesta és la limitació estructural del mètode, i la part que més falta fa explicar bé. El senyal depèn del tot de l'entropia de la distribució del següent token. Allà on el següent token està gairebé determinat —codi, sortida estructurada, respostes factuals breus—, hi ha poc que la clau pugui decidir, i la marca queda tènue o directament absent.
El preprint ho il·lustra amb dos exemples que s'entenen sols. Després de «es va asseure al…» hi caben moltíssimes continuacions acceptables, i aquí la clau té marge de sobres. Després de «for i in» ve «range(» gairebé amb seguretat: no hi ha res a decidir, així que tampoc no hi ha res a marcar.
En codi el detector amb prou feines se separa de l'atzar
| Mesura | Gemma-2-9B | Llama-3.1-8B |
|---|---|---|
| Codi: encerts amb marca (pass@1) | 61,8 % | 60,7 % |
| Codi: encerts sense marca (pass@1) | 61,4 % | 63,8 % |
| Codi: diferència | +0,4 punts | −3,1 punts |
| Prosa: detecció a 200 tokens | 39 % | 39 % |
| Prosa: detecció a 400 tokens | 59 % | 56 % |
| Prosa: AUROC a llargada completa | 0,78 | 0,82 |
| Codi: AUROC a llargada completa | 0,55 | 0,57 |
El codi surt perjudicat dues vegades: per l'entropia de cada pas i per la llargada del passatge. A la mesura de Nemecek, Chaudhary i Ayday, menys d'una mostra de codi de cada cent va arribar ni tan sols als 200 tokens en Gemma, així que la mitjana es calcula sobre molt pocs termes i amb molt poc marge en cadascun.
Hi ha una dada que ho deixa encara més clar. Com que els dos braços de l'experiment, amb marca i sense, comparteixen la llavor de mostreig, entre el 25 % i el 31 % de les mostres de codi van sortir idèntiques, caràcter a caràcter, en tots dos casos. Quan no hi ha res a triar, posar-hi una marca no canvia el resultat.
Per això els valors d'AUROC en codi, 0,55 i 0,57, estan enganxats a aquest 0,5 que és l'atzar. En prosa el detector distingeix; en codi, pràcticament no distingeix res.
El fabricant diu del codi el mateix que va mesurar l'anàlisi independent
Anthropic descriu el seu sistema en codi en els mateixos termes. Diu que el codi, que en moltíssims casos ha de ser exacte, porta en general menys marca d'aigua que altres formes de text; i que allà on es requereix una sortida exacta —on no hi ha tria, i alguna cosa seria incorrecta o un tros de codi es trencaria si es triés un altre terme—, la marca senzillament no s'aplica.
Matisa que sí que es pot aplicar a les parts que tenen marge, com els comentaris dins del codi, però que per definició això tindrà un efecte insignificant sobre el codi produït. És la conseqüència de l'entropia explicada amb altres paraules: la marca només entra allà on hi havia diverses sortides igual de bones.
Que el fabricant i la mesura independent diguin el mateix és més fort que qualsevol dels dos per separat. Anthropic descriu un sistema desplegat al qual ningú de fora no té accés; el preprint mesura una implementació pública del mateix esquema amb el mètode a la vista. Dos camins que no comparteixen ni les dades ni els interessos arriben al mateix lloc: en codi el senyal gairebé no existeix, i en passatges curts tampoc.
En contingut de baixa entropia el cost no el paga l'usuari, sinó el proveïdor
El matís honest de tot plegat és que en contingut de baixa entropia la marca no fa malbé res. Els encerts en codi gairebé no es mouen quan s'activa i en bona part de les mostres el text resultant és literalment el mateix. El cost no cau sobre la qualitat que rep l'usuari, sinó sobre la detectabilitat que deu el proveïdor.
Convé recordar d'on surten aquestes xifres. Les van mesurar Alexander Nemecek, Vipin Chaudhary i Erman Ayday, de Case Western Reserve University, la universitat estatunidenca on treballen tots tres, i les van publicar el 9 de setembre del 2026. No són mesures sobre el sistema desplegat d'Anthropic, sinó sobre una implementació pública del mateix esquema i dos models de pesos oberts.
Conclusió
La marca d'aigua de Claude no és una etiqueta enganxada al text, sinó una manera de sortejar: la clau no decideix quines paraules valen, decideix quina de les que valen surt triada, i el detector reconstrueix aquest sorteig per puntuar el passatge sencer per la mitjana. Això és el que descriuen, per camins diferents i amb les mateixes peces, l'empresa que la va construir i l'anàlisi independent que ha mesurat l'esquema en què es basa. D'aquesta arquitectura se'n dedueixen totes les propietats sense necessitat de creure res a ningú: aguanta els retocs perquè la puntuació és una mitjana llarga; cau amb una reescriptura completa, encara que aleshores es pugui preguntar, com fa la mateixa Anthropic, si el que queda es pot continuar anomenant text generat per una màquina; va sencera en una traducció i gairebé no apareix quan el model només ha corregit el que va escriure una persona; i s'apaga en codi i en respostes breus perquè allà no hi havia res a triar. Són límits del mètode i no defectes d'una implementació concreta: qualsevol marca que viatgi en la font d'aleatorietat del mostreig els hereta, i cap afinació del torneig no crea entropia on no n'hi ha.
Fonts primàries
- Anthropic, «How Claude’s text watermark works», 14 d'agost del 2026, actualitzada l'1 de setembre del 2026 ↗
- Alexander Nemecek, Vipin Chaudhary i Erman Ayday, «Watermarks Without Verification: AI Text Watermarking After the EU AI Act», arXiv:2609.09604v1 [cs.CY], 9 de setembre del 2026 ↗
- S. Dathathri et al., «Scalable watermarking for identifying large language model outputs», Nature, vol. 634, núm. 8035, pp. 818-823, 2024 ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentarios