Aprendiendo IA
Los secretos de la marca de agua de Claude
La marca de agua de Claude no escribe nada invisible ni esconde metadatos: interviene en el instante en que el modelo elige cada palabra y deja que una clave secreta decida cuál de las candidatas igual de válidas sale sorteada. Lo cuentan así, con las mismas piezas, el análisis independiente que la ha medido y la propia Anthropic en la página en la que explica su sistema. De esa arquitectura se deducen todas sus propiedades: aguanta una edición ligera, se cae con una reescritura, va entera en una traducción y casi desaparece en código.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- La marca de agua de Claude está basada en SynthID-Text, el esquema que Google DeepMind publicó en la revista Nature en 2024, y Anthropic lo resume en su propia página, del 14 de agosto de 2026, en una frase: la marca solo cambia la fuente de la aleatoriedad con que se elige entre palabras.
- No se inserta nada en el texto ni hay caracteres ocultos: la clave secreta fija los valores pseudoaleatorios que deciden cuál de varias palabras igual de aceptables sale elegida en cada paso, y el detector recalcula esos valores con la misma clave y puntúa el pasaje por la media de todos sus tokens.
- Dos casos enseñan el mecanismo mejor que una definición: cuando Claude corrige un texto de una persona casi no queda nada a lo que la marca pueda agarrarse, y cuando traduce la marca va entera, porque ahí cada palabra la elige él.
- En la medición independiente que Alexander Nemecek, Vipin Chaudhary y Erman Ayday publicaron el 9 de septiembre de 2026, el detector alcanzó un AUROC de 0,78 y 0,82 en prosa, pero de 0,55 y 0,57 en código, donde 0,5 es exactamente el azar; Anthropic dice por su lado que donde la salida tiene que ser exacta la marca ni siquiera se aplica.
- Entre el 25 % y el 31 % de las muestras de código salieron idénticas, carácter a carácter, con marca y sin ella, porque en código el modelo casi no tiene nada que elegir.
La marca no se añade al texto: se aplica en el instante de elegir cada palabra
Una marca de agua estadística de este tipo actúa en el momento en que el modelo escoge cada palabra. Entre las candidatas que considera aceptables, favorece ligeramente aquellas que una clave secreta señala. Al texto no se le añade nada y el texto se lee con normalidad, porque ninguna de las palabras elegidas era impropia: simplemente resultó ser la señalada.
Un detector que guarde esa misma clave sí puede contar con qué frecuencia aparecen las elecciones favorecidas y, sobre un pasaje largo, juzgar si el texto salió del modelo. De ahí el nombre de la familia: marcas basadas en el muestreo, sampling-based en la literatura técnica, porque el muestreo es el único punto donde intervienen.
Anthropic, la empresa que desarrolla Claude, lo dice con las mismas palabras en la página en la que explica cómo funciona su marca, publicada el 14 de agosto de 2026 y actualizada el 1 de septiembre: al texto no se le añade nada y no hay caracteres ocultos. Ni un espacio de más, ni un carácter invisible entre palabras, ni un campo escondido en el fichero.
No hay, por tanto, un carácter que buscar ni un campo que borrar. Lo que hay es un patrón repartido por todo el pasaje, y solo es legible para quien tenga la clave.
La primera familia de marcas inclina la balanza antes del sorteo
Las marcas estadísticas de texto se reparten en dos familias, y la distinción es el corazón del asunto. La primera, llamada distortion-based, es la que describieron Kirchenbauer y sus coautores en 2023: la clave parte el vocabulario en dos conjuntos y sube la puntuación de uno de ellos antes de muestrear.
El efecto es que la distribución deja de ser la que el modelo había calculado. El texto sigue siendo correcto, pero ya no es el que habría salido sin marca, y ese desvío se puede medir. Esta es la familia que aparece en casi todas las explicaciones divulgativas del tema, y no es la de Claude.
La familia de Claude no toca la balanza: manipula el sorteo
El coste de deformar la distribución se paga precisamente ahí: en la primera familia se puede expresar como una subida de perplejidad. La segunda familia, distortion-free, nace de no querer pagarlo.
En ella, la distribución del siguiente token se deja intacta y la marca viaja en la fuente de aleatoriedad con la que se muestrea. La clave fija los valores pseudoaleatorios que deciden cuál de varias palabras igual de aceptables sale sorteada, de modo que cualquier respuesta individual queda distribuida exactamente como habría quedado sin marca de agua.
SynthID-Text pertenece a esta segunda familia, y la marca de agua que Anthropic aplica a las respuestas de Claude está basada en SynthID-Text. Es la confusión más fácil de cometer al contarlo: el vocabulario de conjuntos de palabras y puntuaciones subidas describe la familia contraria, no la que lleva Claude.
SynthID-Text elige la palabra mediante un torneo entre candidatas
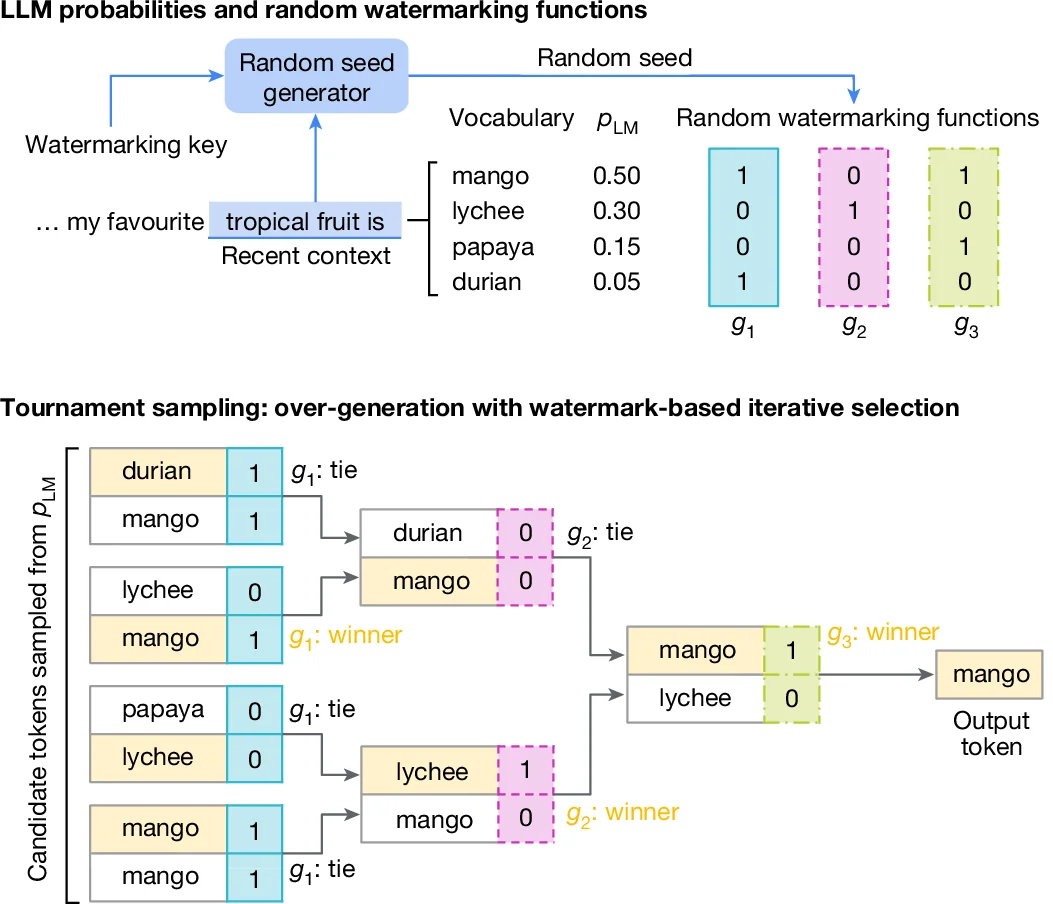
El mecanismo, paso a paso: en cada posición, el sistema muestrea varias palabras candidatas de la distribución del siguiente token y asigna a cada una un valor pseudoaleatorio —un g-value— derivado de la clave y de los tokens anteriores. Después las hace competir en un torneo en el que avanza la candidata con el g-value más alto.
El número de capas del torneo es el mando del sistema: cuantas más capas, con más fuerza se impone la preferencia de la clave. Con pocas, la marca queda tenue; con muchas, el sorteo queda más dirigido.
El detector hace el camino inverso. Recalcula el g-value de cada token del texto con la misma clave y puntúa el pasaje por la media de esos valores; un umbral sobre esa media decide el veredicto.
Esa es, en una frase, la respuesta a cómo se elige la palabra: no se cambia qué palabras son aceptables, se cambia cuál de las aceptables sale sorteada.
Anthropic lo cuenta igual: la marca solo cambia la fuente del azar
La descripción del fabricante encaja con la del análisis independiente hasta en el orden de las piezas. Dice así: en vez de usar un generador de números aleatorios cualquiera para elegir la siguiente palabra, la marca de agua usa la clave y unas cuantas de las palabras anteriores para determinar qué palabra debe elegir el modelo.
Y sitúa el esquema en una genealogía. La marca de texto de Claude es una versión del enfoque SynthID-Text que Google DeepMind publicó en Nature en 2024, y este pertenece a una familia de propuestas que se remonta a una de Scott Aaronson de 2022, todas con el mismo principio de diseño: en palabras de Anthropic, la marca solo cambia la fuente de la aleatoriedad que se usa para elegir entre palabras.
La página lo ilustra con una partida de Monopoly en la que los movimientos, en vez de salir de los dados, salen de los dígitos de pi. La partida se juega igual, porque lo único que se ha sustituido es de dónde viene el azar. La diferencia está fuera del tablero: quien sepa que las tiradas venían de pi puede comprobar después la partida; quien no lo sepa ve tiradas corrientes.
Que la explicación del fabricante y la del trabajo independiente coincidan importa. Una es la descripción de quien construyó el sistema, que desde fuera no se puede comprobar; la otra es la lectura de quien ha estudiado el esquema sin tener la clave de nadie. Cuando las dos describen la misma máquina con las mismas piezas, entenderla deja de depender de creerle a una de ellas.
La puntuación es acumulativa, y por eso manda la longitud del pasaje
- Gemma-2-9B
- Llama-3.1-8B
Ver los datos en tabla
| 200 tokens | 400 tokens | |
|---|---|---|
| Gemma-2-9B | 39% | 59% |
| Llama-3.1-8B | 39% | 56% |
Como el detector puntúa por la media de todos los tokens, cada palabra del pasaje aporta su sumando. Un texto corto ofrece pocos sumandos y la media es inestable; uno largo ofrece muchos y la media se asienta. La marca no está en ningún sitio concreto del texto: está repartida en todo él.
En la medición independiente, la tasa de aciertos del detector sobre prosa mejora de forma acusada al pasar de doscientos a cuatrocientos tokens, y lo hace prácticamente igual en los dos modelos probados: no es la peculiaridad de un modelo, es la aritmética de una media que necesita términos.
Anthropic dice lo mismo de su sistema desplegado: la detección no funciona bien en muestras pequeñas, donde hay menos elecciones de palabra y, por tanto, menos información de la que tirar, y a medida que el pasaje se alarga aumenta la confianza sobre si Claude intervino. Es la misma media contada desde el otro lado del mostrador.
Una edición ligera la deja pasar; una reescritura completa la borra
De esa misma aritmética sale la propiedad que más se cita. Cambiar unas cuantas palabras mueve unos pocos sumandos y la media apenas se resiente. Reescribir el texto entero sustituye todos los sumandos por tokens que la clave no eligió, y la media cae al nivel de un texto cualquiera.
Anthropic lo formula así: hasta cierto punto, sí se puede quitar; una edición ligera probablemente no borre la marca del todo, y una reescritura completa en la que se sustituya cada palabra sí lo hará. Conviene leerlo como lo que es, la afirmación de la propia empresa sobre su sistema y no una evaluación externa, pero es también lo que predice la aritmética de la media.
Y añade un inciso que merece pararse. En el caso de la reescritura completa, dice, es discutible que el texto pueda seguir describiéndose como generado por inteligencia artificial. Si se ha sustituido cada palabra, lo que borra la marca es que ya no queda ninguna palabra elegida por el modelo: el método no falla, se queda sin objeto.
El límite conocido de toda la familia va en la misma dirección y está documentado desde antes: parafrasear y traducir reducen sustancialmente la detectabilidad, según un trabajo de Krishna y sus coautores de 2023 que el preprint recoge entre sus referencias. Google reconoce esa misma debilidad ante la paráfrasis y la traducción en su propia publicación.
Corregir y traducir: dos casos que enseñan el mecanismo mejor que una definición
Hay dos casos que enseñan el mecanismo mejor que cualquier definición, y los cuenta la propia Anthropic. El primero: cuando Claude corrige un texto escrito por una persona, lo que devuelve está por lo general solo ligeramente editado y, como casi todas las palabras son de la persona, hay muy poco —si es que hay algo— a lo que la marca pueda agarrarse.
El segundo es justo el contrario. Una traducción hecha por Claude sí lleva marca, y la lleva entera, porque en ese caso cada palabra la elige él: traducir un texto ya marcado borra buena parte de la señal, pero traducir con Claude la crea de nuevo.
Puestos uno al lado del otro, los dos casos dicen la idea central sin una sola fórmula: la marca se agarra a las palabras que elige el modelo, y a ninguna más. No mide de quién es la idea ni cuánto trabajo ha hecho la máquina; cuenta elecciones suyas, y donde no las hay no hay nada que contar.
De ahí que el mismo sistema se quede casi mudo ante un documento que Claude ha repasado de arriba abajo y hable alto y claro ante una traducción de la misma longitud. La diferencia está en cuántas de las palabras finales salieron de un sorteo suyo.
La señal depende por completo de cuánta elección tuvo el modelo
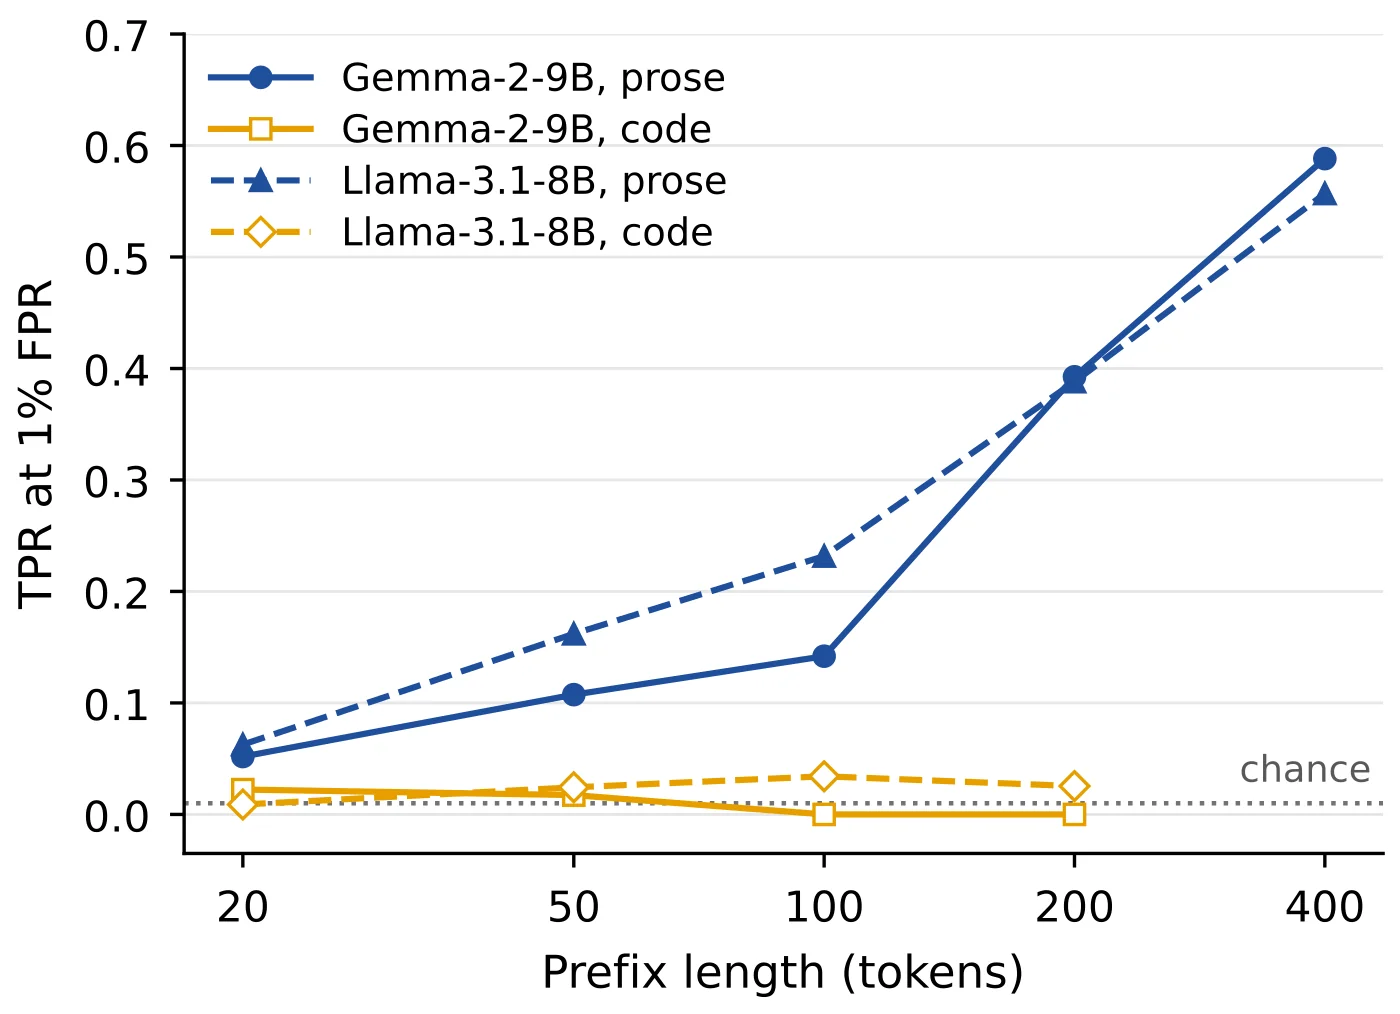
Esta es la limitación estructural del método, y la parte que más falta hace explicar bien. La señal depende por entero de la entropía de la distribución del siguiente token. Donde el siguiente token está casi determinado —código, salida estructurada, respuestas factuales breves—, hay poco que la clave pueda decidir, y la marca queda tenue o directamente ausente.
El preprint lo ilustra con dos ejemplos que se entienden solos. Después de «se sentó en el…» caben muchísimas continuaciones aceptables, y ahí la clave tiene margen de sobra. Después de «for i in» viene «range(» casi con seguridad: no hay nada que decidir, así que tampoco hay nada que marcar.
En código el detector apenas se separa del azar
| Medida | Gemma-2-9B | Llama-3.1-8B |
|---|---|---|
| Código: aciertos con marca (pass@1) | 61,8 % | 60,7 % |
| Código: aciertos sin marca (pass@1) | 61,4 % | 63,8 % |
| Código: diferencia | +0,4 puntos | −3,1 puntos |
| Prosa: detección a 200 tokens | 39 % | 39 % |
| Prosa: detección a 400 tokens | 59 % | 56 % |
| Prosa: AUROC a longitud completa | 0,78 | 0,82 |
| Código: AUROC a longitud completa | 0,55 | 0,57 |
El código sale perjudicado dos veces: por la entropía de cada paso y por la longitud del pasaje. En la medición de Nemecek, Chaudhary y Ayday, menos de una muestra de código de cada cien llegó siquiera a los 200 tokens en Gemma, así que la media se calcula sobre muy pocos términos y con muy poco margen en cada uno.
Hay un dato que lo deja todavía más claro. Como los dos brazos del experimento, con marca y sin ella, comparten la semilla de muestreo, entre el 25 % y el 31 % de las muestras de código salieron idénticas, carácter a carácter, en ambos casos. Cuando no hay nada que elegir, poner una marca no cambia el resultado.
Por eso los valores de AUROC en código, 0,55 y 0,57, están pegados a ese 0,5 que es el azar. En prosa el detector distingue; en código, prácticamente no distingue nada.
El fabricante dice del código lo mismo que midió el análisis independiente
Anthropic describe su sistema en código en los mismos términos. Dice que el código, que en muchísimos casos tiene que ser exacto, lleva por lo general menos marca de agua que otras formas de texto; y que allí donde se requiere una salida exacta —donde no hay elección, y algo sería incorrecto o un trozo de código se rompería si se eligiera otro término—, la marca sencillamente no se aplica.
Matiza que sí puede aplicarse en las partes que tienen margen, como los comentarios dentro del código, pero que por definición eso tendrá un efecto insignificante sobre el código producido. Es la consecuencia de la entropía contada con otras palabras: la marca solo entra donde había varias salidas igual de buenas.
Que el fabricante y la medición independiente digan lo mismo es más fuerte que cualquiera de los dos por separado. Anthropic describe un sistema desplegado al que nadie de fuera tiene acceso; el preprint mide una implementación pública del mismo esquema con el método a la vista. Dos caminos que no comparten ni los datos ni los intereses llegan al mismo sitio: en código la señal casi no existe, y en pasajes cortos tampoco.
En contenido de baja entropía el coste no lo paga el usuario, sino el proveedor
El matiz honesto de todo esto es que en contenido de baja entropía la marca no estropea nada. Los aciertos en código apenas se mueven al activarla y en buena parte de las muestras el texto resultante es literalmente el mismo. El coste no cae sobre la calidad que recibe el usuario, sino sobre la detectabilidad que debe el proveedor.
Conviene recordar de dónde salen estas cifras. Las midieron Alexander Nemecek, Vipin Chaudhary y Erman Ayday, de Case Western Reserve University, la universidad estadounidense en la que trabajan los tres, y las publicaron el 9 de septiembre de 2026. No son mediciones sobre el sistema desplegado de Anthropic, sino sobre una implementación pública del mismo esquema y dos modelos de pesos abiertos.
Conclusión
La marca de agua de Claude no es una etiqueta pegada al texto, sino una forma de sortear: la clave no decide qué palabras valen, decide cuál de las que valen sale elegida, y el detector reconstruye ese sorteo para puntuar el pasaje entero por la media. Eso es lo que describen, por caminos distintos y con las mismas piezas, la empresa que la construyó y el análisis independiente que ha medido el esquema en el que se basa. De esa arquitectura se deducen todas sus propiedades sin necesidad de creerle nada a nadie: aguanta los retoques porque la puntuación es una media larga; se cae con una reescritura completa, aunque entonces quepa preguntarse, como hace la propia Anthropic, si lo que queda puede seguir llamándose texto generado por una máquina; va entera en una traducción y casi no aparece cuando el modelo solo ha corregido lo que escribió una persona; y se apaga en código y en respuestas breves porque allí no había nada que elegir. Son límites del método y no defectos de una implementación concreta: cualquier marca que viaje en la fuente de aleatoriedad del muestreo los hereda, y ninguna afinación del torneo crea entropía donde no la hay.
Fuentes primarias
- Anthropic, «How Claude’s text watermark works», 14 de agosto de 2026, actualizada el 1 de septiembre de 2026 ↗
- Alexander Nemecek, Vipin Chaudhary y Erman Ayday, «Watermarks Without Verification: AI Text Watermarking After the EU AI Act», arXiv:2609.09604v1 [cs.CY], 9 de septiembre de 2026 ↗
- S. Dathathri et al., «Scalable watermarking for identifying large language model outputs», Nature, vol. 634, n.º 8035, pp. 818-823, 2024 ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios