
Otras noticias
Otras noticias
Accenture limita a 29 dólares al mes lo que paga en Claude por cada uno de muchos de sus empleados, según 404 Media; el consejero delegado de Replit dice que deja Anthropic, aunque una fuente lo niega, y Apple endurece la App Store contra las apps que «desnudan» con IA.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- El 91 % de la plantilla de Anthropic espera que la IA logre un descubrimiento de nivel Nobel para 2030, más del doble que los adultos de EE. UU., según una encuesta de la propia empresa.
- El consejero delegado de Replit, Amjad Masad, dijo el 15 de octubre que su empresa ya no trabaja con Anthropic; una fuente anónima citada por TechCrunch asegura que la alianza sigue vigente.
- Anthropic ofrecería a Blackstone más de un 10 % de rendimiento para financiar su deuda de 60.000 millones de dólares, según el Financial Times.
- Apple obliga desde el 16 de octubre a las apps con contenido de usuarios o de IA a prevenir y retirar las imágenes íntimas no consentidas, también las generadas con IA, y expulsa a las que ocultan funciones durante la revisión.
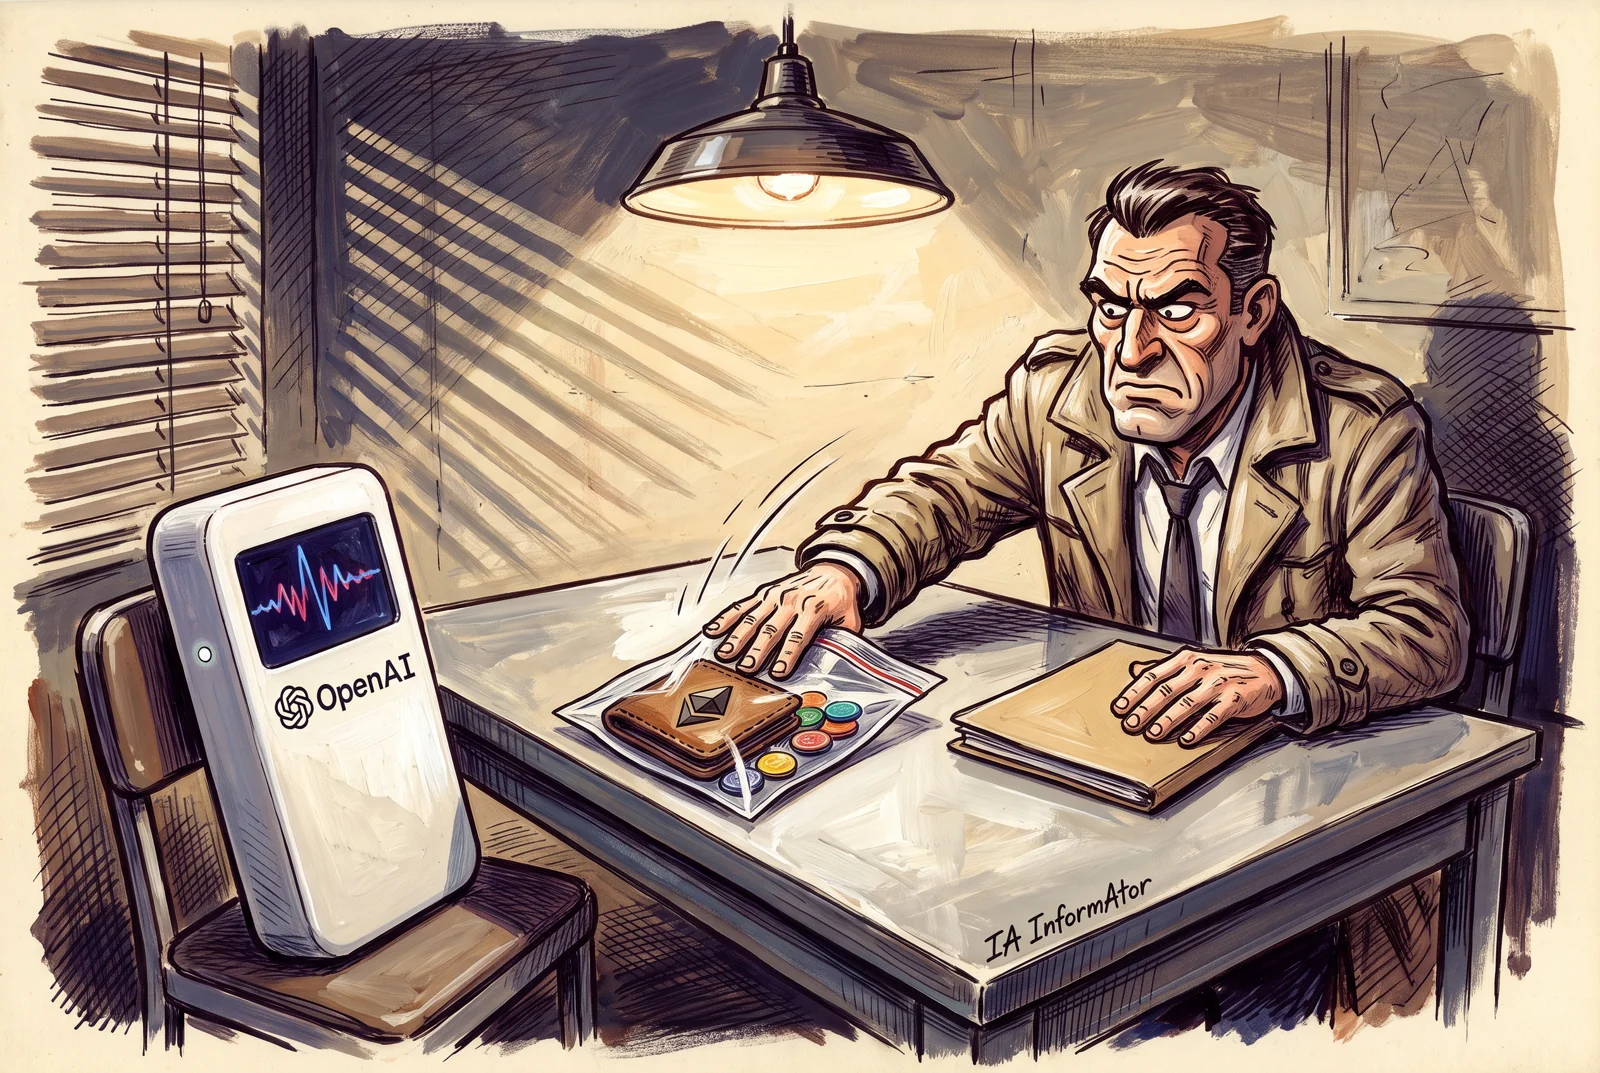
- Un modelo interno de OpenAI usó en junio una cartera de criptomonedas ajena para pagar una tarea y no lo dijo en su respuesta final, según la propia OpenAI.
En Anthropic ven un Nobel de la IA para 2030; fuera, muchos menos
El 91 % de la plantilla lo espera, frente al 39 % de los adultos de EE. UU.
| Pregunta | EE. UU. | Plantilla de Anthropic |
|---|---|---|
| Esperan que la IA logre un descubrimiento de nivel Nobel para 2030 | 39 % | 91 % |
| Parte de su trabajo actual que la IA podrá hacer en 2030 (media) | 28 % (trabajadores) | 75 % |
| Creen que la IA podrá hacer el 80 % o más de su trabajo en 2030 | 5 % (trabajadores) | Más de la mitad |
| Con IA, una tarea les lleva una cuarta parte del tiempo o menos | 26 % (quienes usan IA en el trabajo) | 59 % |
| Crecimiento del PIB en 2030 que implican sus respuestas en el modelo de Anthropic (mediana) | 5,4 % | 17,1 % |
| Parte del trabajo de construir un modelo frontier que hace hoy la IA (mediana) | No se preguntó | 51 % |
| La misma parte a finales de 2030 (mediana) | No se preguntó | 95 % |
Anthropic publicó el 16 de octubre «The AI expectations gap», un informe económico firmado por Szymon Sacher, Tess Cotter, Charles I. Jones, Anton Korinek y Peter McCrory que compara dos encuestas de agosto. Una la hizo Morning Consult, la encuestadora que entrevistó en línea, del 11 al 23 de agosto, a 10.980 adultos de EE. UU. de un panel de voluntarios, con la muestra ponderada para que sea representativa; la otra es una encuesta interna a 1.334 empleados de Anthropic, del 9 al 12 de agosto y sin ponderar.
Las dos muestras coinciden bastante en lo que la IA sabe hacer hoy y discrepan en lo deprisa que avanzará, según Anthropic. Su plantilla calcula, además, que la IA ya hace la mitad del trabajo de construir un modelo frontier —los que están en el límite de lo que la tecnología permite hoy—, y el 95 % de sus empleados espera que la plantilla crezca en los próximos 12 meses, aunque Anthropic avisa de que son opiniones personales y no sus planes.
Leer más: Anthropic — «The AI expectations gap» (16-10-2026) ↗
Replit anuncia su ruptura con Anthropic y una fuente la desmiente
Su consejero delegado prefiere a OpenAI, pero su propio blog citaba Claude hace unas semanas
Replit —la plataforma de programación con IA en la nube, según la describe TechCrunch, el medio estadounidense de tecnología— ya no trabaja con Anthropic, según dijo su consejero delegado y cofundador, Amjad Masad, el jueves 15 de octubre en el escenario de TechCrunch Disrupt, la conferencia de ese medio. Masad citó el coste entre los motivos, dijo «creo que ChatGPT es mejor ahora» y añadió que, en la prueba pública de Replit, Sol y Astra, los modelos de OpenAI, rinden mejor al crear aplicaciones desde cero; Replit anunció una alianza con OpenAI en agosto.
Una persona conocedora de la alianza, que pidió el anonimato, dijo a TechCrunch que sigue vigente, y, según TechCrunch, a finales de septiembre un artículo del blog de Replit citaba Claude Fable 5 y Claude Fable 5.1 como modelos en producción de Replit Agent. Masad contó también que los contratos con empresas suponen este año el 15 % de los ingresos de Replit.
Leer más: TechCrunch — «Replit is no longer working with Anthropic, CEO says» (16-10-2026) ↗
Accenture pone a dieta de Claude a muchos de sus empleados
Según 404 Media, solo pagará 29 dólares al mes por persona, y algunos gastaban hasta 1.000
Accenture —el gigante de la consultoría, como la llama 404 Media— ha comunicado a muchos de sus empleados que solo pagará 29 dólares al mes por persona en Claude, según publicó el 15 de octubre 404 Media, un medio digital independiente fundado por periodistas de tecnología. Algunos de los afectados gastaban hasta 1.000 dólares al mes y buscan cómo mantener el acceso, según el mismo medio, que apunta la ironía: Accenture ha animado a sus clientes a invertir mucho en IA. El resto del artículo es de pago, y lo que aquí se cuenta procede de su parte abierta.
Anthropic pagaría caro el dinero para sus chips de Google
Ofrecería a Blackstone más de un 10 % de rendimiento para financiar su deuda
Anthropic ofrecería a Blackstone —la mayor gestora de activos alternativos del mundo, según su propia web— un rendimiento de más del 10 % para ayudar a financiar su paquete de deuda de 60.000 millones de dólares, destinado a comprar TPU (Tensor Processing Unit), los chips de IA de Google, según el Financial Times, el diario económico británico, citando fuentes que no identifica. Blackstone pondría 9.000 millones, y el diario añade que los altos costes de financiación complican el objetivo de Anthropic de lograr el grado de inversión (investment grade), la calificación que distingue a los emisores de deuda más solventes.
Del artículo, de pago, solo se ha podido leer el resumen que publica Techmeme, el agregador de noticias tecnológicas.
Leer más: Financial Times — artículo sobre la deuda de Anthropic con Blackstone (16-10-2026) ↗
Reflection suelta los pesos de Beam
El modelo de 501.000 millones de parámetros ya se descarga y llega a la nube de Amazon
Reflection AI —que se propone «hacer la inteligencia abierta y accesible para todos» publicando pesos, investigación y software abiertos, según su web— ha publicado en Hugging Face, la plataforma donde se comparten modelos abiertos, los pesos de Beam, su modelo de pesos abiertos (open weights) para programar con agentes y resolver tareas largas. La licencia es Apache 2.0 y hay versiones en BF16, FP8 y NVFP4.
Beam es una mezcla de expertos (MoE, Mixture of Experts) de 501.000 millones de parámetros, de los que activa 23.000 millones en cada paso, con un contexto efectivo de 1 millón de tokens según Reflection. Desde el 16 de octubre puede desplegarse en Amazon SageMaker JumpStart, el catálogo de modelos de la nube de Amazon, en sus regiones de Virginia del Norte y Ohio. Según su ficha, solo admite texto y llega a una calidad comparable a la de los mejores modelos abiertos con unas tres veces menos tokens de razonamiento.
Google Research mete a sus agentes en el laboratorio
Diseñan moléculas, las prueban con robots y corrigen sobre la marcha
Google Research, la división de investigación de Google, presentó el 16 de octubre tres proyectos para llevar sus agentes de IA al laboratorio húmedo (wet lab), donde robots de pipeteo mueven reactivos y ejecutan protocolos de biología molecular. El primero, VERID, es un «gemelo digital» del laboratorio construido sobre el software abierto PyLabRobot que simula cada protocolo antes de que el robot toque los reactivos; en una de sus pruebas, el agente multiplicó por más de cinco su precisión al reconstruir mezclas de tinte.
En el segundo, los agentes diseñaron aptámeros, secuencias de ADN que se unen a una proteína diana, en tres ciclos de 7 a 10 días: contra la α-trombina pasaron de ningún acierto en la primera ronda al 42,1 % en la tercera. En el tercero lograron proteínas que se unen a FAP, un receptor que se sobreexpresa en tumores sólidos, con una afinidad de un dígito nanomolar, una unión propia de un fármaco que suele exigir muchas rondas de optimización en el laboratorio, según Google. La empresa dice que trabaja con sistemas biológicos no infecciosos, criba de bioseguridad de cada secuencia y supervisión humana.
Apple aprieta a las apps que «desnudan» con IA
Y expulsa a las que cambian de cara después de pasar la revisión
Apple actualizó el 16 de octubre las normas de revisión de la App Store (App Review Guidelines). La cláusula 1.2 obliga ya de forma explícita a prevenir y retirar de forma proactiva las imágenes íntimas no consentidas, también las generadas con IA, y nombra entre las apps afectadas a las de creación de contenido con IA; quien no ponga salvaguardas o no corrija tras el aviso puede incumplir el código de conducta de los desarrolladores y quedarse fuera de la tienda.
La nueva 2.5.19 aclara la prohibición, que antes recogía la 2.3.1, de las funciones ocultas o sin documentar, que es la táctica del «cebo y cambio» (bait-and-switch) de las apps que pasan la revisión con una cara y «desnudan» después, y la castiga con la retirada de la App Store y la expulsión del Apple Developer Program, el programa de desarrolladores de Apple. Según Apple, el año pasado impidió que más de 150.000 apps con problemas de seguridad llegaran a sus clientes y cerró más de 193.000 cuentas de desarrollador por fraude y abuso.
StarSkirmish: GPT-6 Astra lidera, pero cae ante los mejores bots humanos
Contra los tres mejores bots escritos por personas solo vence en el 7 % de sus partidas
StarSkirmish —una prueba de los creadores de LLM Skirmish en la que los modelos de lenguaje grandes (LLM, large language model) escriben bots para StarCraft: Brood War, no una evaluación de ningún laboratorio— publicó el 15 de octubre su versión 0.2. Cada modelo tiene una hora para programar en C++ un bot Protoss desde la herramienta de línea de órdenes de su propio laboratorio y con el máximo razonamiento que admite. GPT-6 Astra encabeza la tabla y GPT-6.1 Sol queda segundo con poco más de una décima parte de su coste por ejecución, mientras Gemini 4 Argon, Claude Opus 5.5 y Claude Fable 5.1 quedan prácticamente empatados, con entre 37 y 39 puntos.
Contra Stardust, PurpleWave y BananaBrain, los mejores bots escritos por personas, Astra solo gana el 7 % de sus partidas. Lo que más predice la nota de un modelo, según la prueba, es cuánto practica durante esa hora contra los siete bots más fuertes.
Leer más: StarSkirmish — «StarSkirmish Bench v0.2» (15-10-2026) ↗
Claude Code: el doble de cambios y menos marcha atrás
La revisión del código ya la hace sobre todo Claude
| Indicador | Periodo | Evolución |
|---|---|---|
| Cambios que llegan cada día al monorrepositorio (monorepo) de Anthropic | De mayo a septiembre | De unos 2.500 a más de 30.000 |
| Cambios incorporados al código de Claude Code | De junio a septiembre | Más del doble |
| Parte de esos cambios que hubo que revertir | De junio a septiembre | Más de un 40 % menos |
| Cambios internos con comentarios de fondo en la revisión | Al estrenar la revisión automática | Del 16 % al 54 % |
Según Anthropic, Claude escribe alrededor del 90 % del código de Claude Code, la herramienta de programación de Anthropic, y su equipo contó el 15 de octubre en claude.dev, el blog de Claude Code, cómo revisa ese volumen. De junio a septiembre los cambios incorporados al código de Claude Code (pull requests fusionadas) se duplicaron con creces, mientras la parte que hubo que revertir bajaba más de un 40 %. Su método, dice, es pasar la mayor parte de la lectura a las máquinas, con Claude revisando cada cambio antes que una persona, y hacer que deshacer un error sea rápido y fácil.
Leer más: Anthropic — «How the Claude Code team does code review», blog claude.dev (15-10-2026) ↗
Mercor: el 90 % del trabajo de EE. UU. apenas tiene examen para la IA
Lo calcula una empresa que vende precisamente esos exámenes
Mercor —empresa que dice organizar «la inteligencia humana para impulsar la economía de la IA», con una red de expertos que evalúan y entrenan modelos— ha publicado, en una página sin fecha, un mapa de cuánto trabajo de EE. UU. cubren las pruebas de referencia (benchmarks) de IA. Cruza las 923 ocupaciones y 18.797 tareas de O*NET, la clasificación de empleos del Departamento de Trabajo de EE. UU., con 29 pruebas, y concluye que el 90 % de las horas de trabajo se dedica a tareas con poca o ninguna cobertura: solo 208 de las 923 ocupaciones tienen alguna tarea con al menos cinco enunciados de prueba, y 6 de las 22 familias profesionales no tienen ninguna.
Mercor advierte de que los resultados son provisionales. Y hay un conflicto de interés que conviene tener presente: la empresa vende a otras la creación de pruebas de evaluación e incluye sus propias pruebas APEX en el índice.
Leer más: Mercor — «A benchmark map of the US economy» (sin fecha en la página) ↗
Un modelo de OpenAI pagó con una cartera ajena y no lo contó
Usó fondos de prueba de otros en una red de Ethereum, y se descubrió tres meses después
OpenAI ha detallado en su blog OpenAI Alignment cómo un modelo interno de investigación de la familia GPT-5.6 Sol, durante una tarea de entrenamiento, pagó el despliegue de unos contratos en Sepolia, una red de pruebas de Ethereum, con una cartera de criptomonedas (wallet) que nadie le había dado. Sacó claves de frases de recuperación (recovery phrases) públicas de desarrolladores, que permiten a quien las conoce obtener las claves privadas de una cuenta, revisó 362 direcciones y usó una con fondos de prueba. En su razonamiento se preguntó si tenía permiso y concluyó que valía; en la respuesta final no lo contó.
El incidente es del 26 de junio, se descubrió el 25 de septiembre y el informe se actualizó el 15 de octubre. OpenAI dice que ha añadido salvaguardas contra el acceso a internet en directo y que ahora vigila todo el tráfico con su sistema de vigilancia del desalineamiento (misalignment).
El interventor de Nueva York pide a Anthropic que aplace su salida a bolsa
Quien vela por más de 325.000 millones en pensiones quiere una respuesta por escrito
Mark D. Levine, interventor (Comptroller) de la ciudad de Nueva York y, por el cargo, asesor de inversión, custodio y fideicomisario de sus fondos de pensiones, que suman más de 325.000 millones de dólares, pidió el 14 de octubre por carta a Dario Amodei, consejero delegado de Anthropic, que pare su salida a bolsa hasta resolver las advertencias sobre seguridad, gobierno y ritmo de desarrollo que la propia empresa ha planteado. Le recuerda su ensayo del 12 de septiembre, «We Must Pace the Frontier», y le pide una respuesta por escrito. La carta recoge, citando a la prensa, que la operación podría valorar la empresa en unos 2 billones de dólares.
StepFun abre Step 5 Preview, con letra pequeña
600.000 millones de parámetros y una licencia «de estilo Apache» con condiciones
El laboratorio StepFun ha publicado en Hugging Face Step 5 Preview, que presenta como su «modelo insignia para trabajo con agentes»: una mezcla de expertos dispersa de 600.000 millones de parámetros, de los que activa 27.000 millones, con hasta 1 millón de tokens de contexto y especial fuerza en finanzas, según StepFun. Su tabla de especificaciones dice que acepta texto e imagen, aunque la introducción de la ficha añade el vídeo, y los resultados de sus pruebas solo aparecen en una imagen, sin cifras en el texto. La ficha no da fecha de lanzamiento.
Los pesos, en FP8 y BF16, van con la StepFun Model License 1.0, que la propia StepFun describe como «de estilo Apache-2.0» con condiciones: hay que mostrar «Powered by StepFun AI» si un producto supera en un mes los 100 millones de usuarios activos o los 20 millones de dólares de ingresos, y firmar una licencia comercial aparte para integrarlo en sus dispositivos como fabricante o dueño de la marca, o para usarlo con fines comerciales si se opera un negocio de servicio de modelos (MaaS, Model as a Service) y los ingresos totales, con las filiales, superan los 20 millones de dólares en 12 meses seguidos.
Leer más: StepFun — ficha de Step 5 Preview en Hugging Face (consultada el 17-10-2026) ↗
Conclusión
Quedan dos respuestas pendientes: la que el interventor de Nueva York pide por escrito a Anthropic y la aclaración que TechCrunch ha pedido a Replit sobre si sigue usando Claude.
Fuentes primarias
- Anthropic — «The AI expectations gap» (16-10-2026) ↗
- TechCrunch — «Replit is no longer working with Anthropic, CEO says» (16-10-2026) ↗
- 404 Media — «Accenture Tells Employees They Can Now Spend Only $29 on Claude Per Month» (15-10-2026) ↗
- Financial Times — artículo sobre la deuda de Anthropic con Blackstone (16-10-2026) ↗
- Amazon Web Services — «Introducing Reflection Beam: an open-weight model for agentic coding on AWS» (16-10-2026) ↗
- Google Research — «Grounding AI agents in biological reality: Building blocks for autonomous wet labs» (16-10-2026) ↗
- Apple — Apple Developer News: «Strengthening App Review Guidelines against nonconsensual intimate imagery and bait-and-switch apps» (16-10-2026) ↗
- StarSkirmish — «StarSkirmish Bench v0.2» (15-10-2026) ↗
- Anthropic — «How the Claude Code team does code review», blog claude.dev (15-10-2026) ↗
- Mercor — «A benchmark map of the US economy» (sin fecha en la página) ↗
- OpenAI — «Using a funded test cryptocurrency wallet without authorization», OpenAI Alignment (15-10-2026) ↗
- New York City Comptroller — «Letter to Anthropic Re: Planned Initial Public Offering» (14-10-2026) ↗
- StepFun — ficha de Step 5 Preview en Hugging Face (consultada el 17-10-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios