Análisis
DevDay de OpenAI: 28 anuncios en 53 minutos
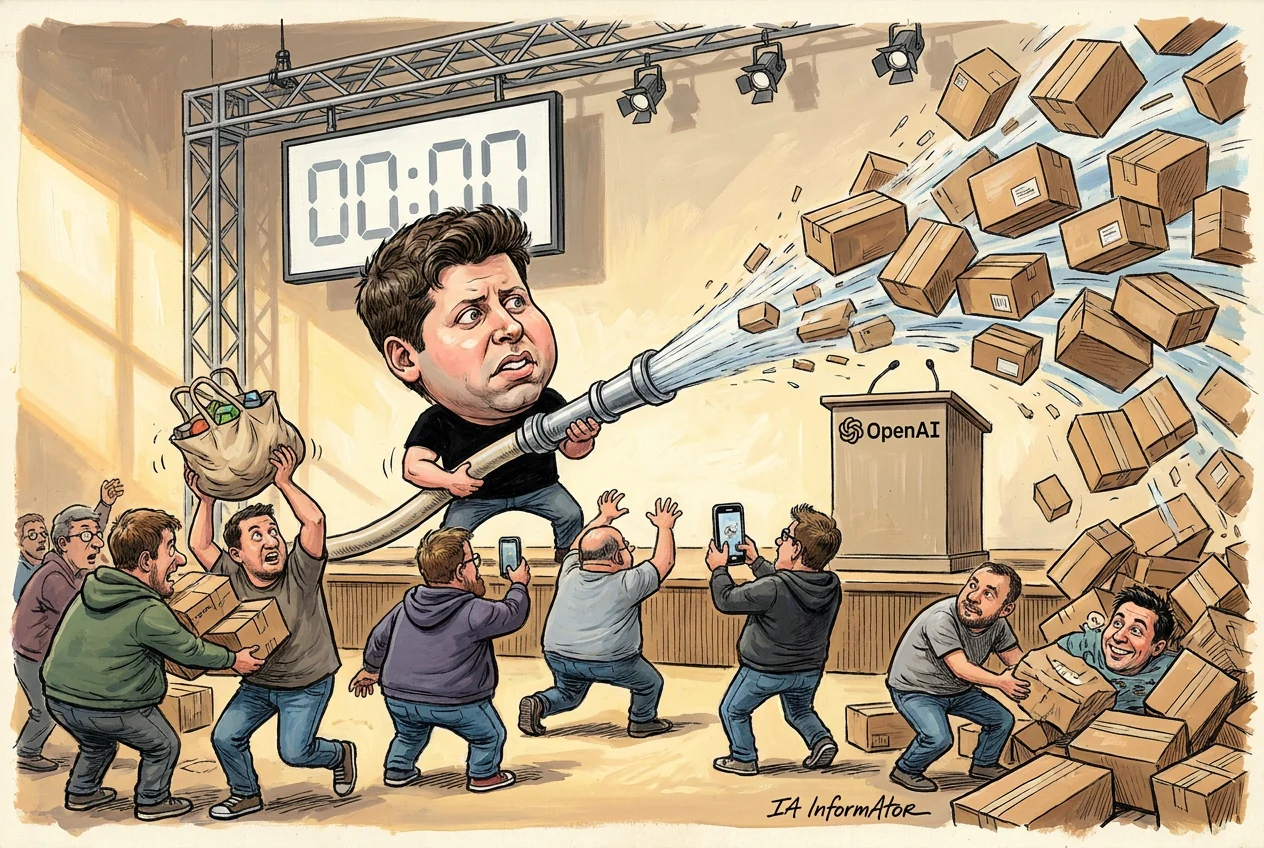
OpenAI reunió a unos 2.500 desarrolladores el martes 29 de septiembre en Fort Mason, San Francisco, y les soltó encima los 28 anuncios de este inventario en una presentación de unos 53 minutos. Abrió con los dots, agentes que no se apagan, y cerró pulsando en el escenario un botón que reinició los límites de uso de todo el planeta. En medio: un modelo nuevo, un modo de velocidad que cuesta seis veces más, un plan de 500 dólares al mes y una tienda para empresas. Esto es todo lo que se presentó, con su precio y con el estado real de cada cosa.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- El DevDay 2026 de OpenAI se celebró el martes 29 de septiembre en Fort Mason, San Francisco, ante unos 2.500 asistentes, y su presentación central duró unos 53 minutos.
- OpenAI habla de «más de veinte anuncios importantes»; el inventario de esta redacción son 28 entradas, algunas de las cuales agrupan dos anuncios hermanos, y al menos siete no están disponibles del todo porque salieron en vista previa, en beta cerrada o con la fecha sin concretar.
- Los dots, agentes siempre activos movidos por GPT-6 Astra, se conectan a más de 4.000 aplicaciones y el primero va incluido en los planes Pro y Business Premium, pero a los Pro no les llegan en el Espacio Económico Europeo, Suiza ni el Reino Unido.
- El modo Ultrafast alcanza 300 tokens por segundo, según OpenAI, y cuesta seis veces la tarifa estándar: 60 dólares por millón de tokens de entrada y 300 por millón de salida con GPT-6 Astra.
- OpenAI dice haber recortado un 45 % la espera hasta el primer token y acelerado más de un 30 % las llamadas a herramientas, con la Responses API multiplicando por cien su uso en un año y una fiabilidad por encima del 99 %.
La presentación duró 53 minutos y no dejó respirar
OpenAI llenó Fort Mason con unos 2.500 asistentes, según la cobertura en directo de la cadena económica estadounidense CNBC. En la calle, frente al recinto, hubo una concentración de protesta contra la inteligencia artificial. Dentro, la presentación arrancó poco después de las diez de la mañana en hora local y se cerró unos 53 minutos más tarde.
La propia OpenAI habla de «más de veinte anuncios importantes» en el resumen que publicó ese mismo día, repartidos en 25 fichas. El inventario de esta redacción son 28 entradas, y la cuenta cierra así: cuatro no tienen ficha propia en ese resumen —las cifras de rendimiento de la plataforma, los specialist dots, el regreso del Pro 200 junto al Pro 100, y el reinicio de límites con el harness de OpenClaw— y, en sentido contrario, una sola entrada reúne dos fichas, la de Pages y la de las diapositivas colaborativas. Sam Altman, consejero delegado de la compañía, recordó que ChatGPT lo usan unos 1.200 millones de personas a la semana.
El guion fue el de todos los años: primero un producto para todo el mundo, después modelos, después herramientas para desarrolladores y, al final, distribución. Lo que cambió es que el producto de apertura no era un modelo, sino un agente.
Los 28 anuncios, con su estado y su precio
| Anuncio | Qué es | Estado | Precio |
|---|---|---|---|
| GPT-6.1 Sol | Modelo de gama media, cerca de GPT-6 Astra por la quinta parte del precio | Disponible en la API y para Plus, Pro, Business, Enterprise y Edu, en ChatGPT Work y Codex; aún no en el chat | 2 dólares de entrada y 10 de salida por millón de tokens |
| Ultrafast | Modo de servicio hasta ocho veces más rápido, 300 tokens por segundo | Disponibilidad amplia para GPT-6 Astra: API, y ChatGPT Work y Codex con Pro 500 y Enterprise; en vista previa para GPT-5.6 Sol; para GPT-6.1 Sol, «en los próximos días» | Seis veces la tarifa estándar: 60 y 300 dólares por millón |
| Decisions API | El modelo elige entre respuestas fijadas de antemano | Vista previa limitada, con apertura amplia «en los próximos días» | Sin tarifa publicada y sin planes asignados |
| Agents API con computer use | La infraestructura de agentes de Codex, abierta como API | Beta pública desde el 10 de septiembre; computer use, desde el 29, en la API y, con Pro 500 y Enterprise, en Codex y ChatGPT Work | Sin recargo: se pagan los tokens y las herramientas |
| Bedrock Managed Agents con OpenAI | Agentes de OpenAI que corren enteros dentro de Amazon Web Services | Vista previa según la página de Amazon; el resumen de OpenAI no da disponibilidad | Precio no publicado |
| Private Intelligence | Retención cero con procesado privado de seguridad, más inferencia privada | La retención cero se configura ya; la inferencia privada llega en vista previa «este otoño» | Sin recargo publicado: el acceso se pide por formulario |
| Cifras de rendimiento de la plataforma | Un 45 % menos de espera al primer token y más de un 30 % en llamadas a herramientas | Ya en producción, según OpenAI | No aplica |
| Codex Cloud | Tareas de programación en la nube y entornos de desarrollo reutilizables | Disponible | Incluido en Plus, Pro, Business, Enterprise, Education y Healthcare |
| Codex CLI renovado | Terminal rehecha, voz en los dos sentidos y vista de agentes | Disponible | Incluido en todos los planes |
| Code Review en el escritorio | Revisión de cambios dentro de la aplicación de escritorio | GitHub, disponible; GitLab, en vista previa | Incluido en todos los planes |
| Codex Security Cloud | Escaneos de seguridad continuos que validan el hallazgo y preparan el parche | Disponible | Incluido en Pro, Business, Enterprise y Edu, en escritorio y web; abre el acceso a Daybreak Blue |
| dots | Agentes siempre activos con su propio ordenador en la nube | Despliegue gradual; beta en Enterprise, apagada por defecto | El primer dot, incluido en Pro y Business Premium |
| specialist dots y Microsoft Agent 365 | Agentes de empresa con identidad y credenciales propias | Vista previa, solo por pilotos acordados | Precio no publicado |
| ChatGPT Space | Lo que antes era Library: páginas vivas donde trabajan personas y agentes | Disponible en web y escritorio; en móvil, solo buscar, leer y compartir | Incluido en Pro, Business y Enterprise |
| Pages y presentaciones colaborativas | Documentos y diapositivas que editan a la vez el equipo y sus agentes | Pages, disponible; las diapositivas colaborativas, «en las próximas semanas» | Incluido en Pro, Business y Enterprise |
| Teams y Team Tasks | Equipos con tareas programadas o disparadas por un suceso | Disponible | Incluido en Business y Enterprise, con permiso del administrador |
| @ChatGPT en Slack y Microsoft Teams | ChatGPT contesta mencionado en los canales del equipo | Disponible, lo activa el administrador | Incluido en Business y Enterprise; la página de producto añade también Edu |
| Plugin de reuniones | Toma notas de la reunión sin meter un bot en la llamada | Beta en la aplicación de macOS; en Enterprise, «pronto» | Incluido en todos los planes Pro y Business |
| Perfiles compartibles | Perfil con los sites y los plugins que uno quiera exhibir | Disponible en todos los países | Incluido en Free, Go, Plus, Pro, Business y Enterprise |
| Plugin extensions | Plugins que se comportan como partes nativas de ChatGPT y de Codex | Disponible; en la web, «pronto» para Free y Go | Incluido en todos los planes |
| Creación, envío y descubrimiento de plugins | Revisión con seguimiento y actualizaciones sin reenviar el paquete entero | Disponible | Incluido en todos los planes; sin tarifa de envío publicada |
| Sites con plugins conectados | Webs publicadas desde ChatGPT que leen los plugins del visitante | Disponible, junto con base de datos y tareas programadas | Incluido en Business, Enterprise, Healthcare y Edu |
| MCP Events | El servidor avisa a ChatGPT cuando algo cambia, en vez de esperar la pregunta | Disponible, exige MCP 2.0 | Incluido en todos los planes |
| Sign in with ChatGPT | Entrar en aplicaciones de terceros y gastar allí la cuota del plan | Identidad en todo el mundo; gasto de cuota, solo en Plus y Pro | Sin coste añadido: consume el uso incluido del plan |
| OpenAI Marketplace | Tienda donde las empresas gastan en productos de terceros su compromiso con OpenAI | Disponible con 32 socios; el cliente de empresa registra su interés | Se paga con el compromiso de gasto ya firmado |
| Pro 500 | Plan con el mayor uso incluido de la gama Pro y con Ultrafast | Disponible | 500 dólares al mes |
| Pro 200 reabierto y Pro 100 | Vuelven las dos suscripciones, con menos uso incluido que antes | Disponible | 200 y 100 dólares al mes |
| Reinicio mundial de límites y OpenClaw Enterprise harness | Un reinicio de límites de uso para todo el planeta y un harness de empresa para la comunidad de código abierto | El reinicio se ejecutó en el acto; del harness no hay ni una página | Sin precio publicado |
La tabla que viene es el índice del día y conviene leerla antes que cualquier titular. Cada fila es una entrada del inventario y unas pocas agrupan dos anuncios hermanos. El estado es el que publica OpenAI, que en su resumen oficial pone una línea de disponibilidad en 22 de sus 25 fichas: «disponible» quiere decir que se puede usar hoy, y beta, vista previa o «pronto» quieren decir que no, aunque se enseñara en el escenario.
En la columna del precio aparece mucho «incluido en el plan». Eso significa que se paga con el uso mensual de la suscripción y que OpenAI no dice en ninguna parte a cuánto uso equivale un plan en cifras absolutas: solo compara unos planes con otros. Las tres fichas que se quedan sin esa línea también dicen algo: Bedrock Managed Agents, Private Intelligence y el propio Marketplace se piden por formulario.
Los dots abrieron el día y son el anuncio gordo
Los dots funcionan con GPT-6 Astra, tienen su propio ordenador en la nube y su propio navegador, y pueden escribir y probar código. A través de los plugins de ChatGPT se conectan a más de 4.000 aplicaciones, y heredan las que el usuario ya tenía enchufadas. Se les habla por ChatGPT en escritorio, web y móvil, también en Slack y en Microsoft Teams, y ellos contestan con avisos, preguntas o decisiones que hay que tomar.
Mandar mensajes de texto al dot está en una beta limitada a usuarios Pro de Estados Unidos, a través de un proveedor externo, y OpenAI avisa de que conviene no mandar información sensible por ahí. Cuando nadie le habla, el dot hace lo que la compañía llama investigación proactiva: rebusca en las aplicaciones conectadas con herramientas restringidas a solo lectura, que no pueden enviar mensajes ni cambiar contenidos. Hay reglas personalizables sobre qué puede hacer solo y qué tiene que pedir, y algunas tareas, como cambiar una contraseña, se quedan siempre en manos del usuario.
El reparto es desigual por geografía. A los usuarios Pro les llegan en todos los mercados menos el Espacio Económico Europeo, Suiza y el Reino Unido; a los de Business Premium, en todas las regiones donde ChatGPT funciona. En Enterprise, Edu y Healthcare es una beta que viene apagada y que tiene que encender el administrador del espacio de trabajo.
El precio tiene truco bueno y truco malo. El primer dot va incluido sin coste añadido en Pro y en Business Premium, y hablar con él no consume el uso del plan; pero cuando se le encarga una tarea en Codex o en ChatGPT Work, esa tarea sí cuenta como cualquier otra. El plan trae además una asignación para trabajo de fondo, con límites ampliados durante el primer mes desde el lanzamiento. Añadir más dots, o hacerlos más rápidos, se podrá en el futuro y no tiene precio publicado.
La demostración en directo se atascó: el dot de la pantalla tardó en responder y se quedó en un «sigo mirándolo». Lo cuenta el blog en directo de Simon Willison, desarrollador y escritor independiente que siguió el acto desde la sala con una entrada que le regaló OpenAI. La persona que hacía la demostración siguió adelante pidiéndole otra cosa.
Los specialist dots se quedan dentro de las empresas
El mismo día, OpenAI enseñó en vista previa los specialist dots: agentes que no pertenecen a una persona, sino a la organización. La empresa los da de alta con identidad propia, credenciales propias y acceso a los sistemas donde guarda sus datos, y les asigna responsabilidades acotadas. OpenAI dice haberlos probado por dentro en compras, procesamiento de facturas, marketing por correo, atención al cliente y contratación comercial; en el escenario puso otros ejemplos del trabajo intensivo que podrían escalar, como la contabilidad, el marketing o lo jurídico.
No se contratan: se pilotan. OpenAI dice que empieza con pilotos de empresa concretos, en los que sus ingenieros definen con cada cliente qué hace el agente, qué herramientas usa y cómo se revisa y aprueba su trabajo. No hay precio publicado ni fecha de disponibilidad general.
La pata de gobierno la pone Microsoft: las dos compañías trabajan para integrar los specialist dots en Agent 365, de modo que una empresa pueda administrarlos con los controles de seguridad que ya usa. Eso es un objetivo declarado, no un producto que esté funcionando.
Library pasa a llamarse Space y las páginas se mueven solas
ChatGPT Space es el sitio donde un equipo, ChatGPT, Codex y los dots trabajan sobre lo mismo. Lo que antes era Library se llama ahora Space para los planes Pro, Business y Enterprise. La pieza básica es la página: un documento que admite texto, investigación, imágenes, datos y código, que se puede mantener al día desde las herramientas conectadas y en el que se mencionan agentes como se menciona a un compañero.
Funciona en web y en escritorio, y va incluido sin coste aparte en los planes Pro, Business y Enterprise. En el móvil solo se pueden buscar, leer y compartir páginas: crear y editar desde el teléfono está anunciado como «pronto». Las diapositivas colaborativas, que varias personas y varios agentes pueden editar a la vez y que se exportan a PowerPoint o a Google Slides sin perder el formato, llegarán a esos mismos planes «en las próximas semanas»; las hojas de cálculo compartidas, más adelante.
El trabajo en grupo se reparte entre equipos, Slack y las reuniones
Teams y Team Tasks dan a un grupo de personas un sitio común y, sobre todo, tareas que se ejecutan solas: a una hora fija o cuando pasa algo, como la llegada de un mensaje a un canal de trabajo en Slack. Las tareas corren en la nube con la cuenta de servicio del equipo y con las conexiones que haya configurado la empresa, de modo que no hace falta que cada miembro enchufe su cuenta personal. En Enterprise, el administrador controla con dos permisos quién puede crear equipos y quién puede crear y gestionar sus tareas.
@ChatGPT entra en los canales de Slack y de Microsoft Teams: se le menciona en un hilo y ayuda a planificar un lanzamiento o a investigar un fallo, con el contexto de las herramientas conectadas y sin salir de la conversación. El resumen oficial lo da para Business y Enterprise —la página de producto añade Edu—, lo tiene que activar el administrador, pide aprobación antes de tocar nada y deja registro de auditoría. El detalle que importa en una empresa: los compañeros pueden aportar contexto y afinar el resultado en ese mismo hilo sin necesidad de tener licencia propia de ChatGPT.
El plugin de reuniones toma notas sin meter un bot en la llamada y deja el resumen con sus tareas pendientes en Space; el audio se borra en cuanto las notas están listas y no se puede recuperar ni volver a escuchar. Está en beta en la aplicación de escritorio de macOS para todos los planes Pro y todos los planes Business; iOS, Android y Windows son «pronto», y en Enterprise el resumen oficial dice «pronto» mientras el centro de ayuda habla de una alfa cerrada a la que se entra por el gestor de cuenta. OpenAI advierte de algo importante: el aviso de consentimiento que aparece en pantalla lo ve solo quien toma las notas, así que avisar al resto de la reunión es cosa suya.
Y un detalle menor con efecto público: los perfiles compartibles, que son el anuncio del día que llega a más gente. Cada cuenta tiene ya un perfil con nombre, foto, biografía, actividad y los sites y plugins que uno quiera exhibir, privado por defecto y compartible con un enlace del tipo chatgpt.com/u/usuario. Van incluidos desde el plan gratuito: Free, Go, Plus, Pro, Business y Enterprise, en todos los países, aunque el escaparate solo se gestiona desde web y escritorio. En Business, los perfiles se comparten con el resto del espacio de trabajo por defecto y solo el administrador puede cambiarlo.
Tres modelos, cuatro velocidades y una tarifa que se multiplica por seis
| Modelo y modo | Entrada | Entrada leída de la caché | Escritura en caché | Salida |
|---|---|---|---|---|
| GPT-6 Astra, estándar | 10 | 1 | 12,50 | 50 |
| GPT-6.1 Sol, estándar | 2 | 0,10 | 2,50 | 10 |
| GPT-6 Luna, estándar | 0,10 | 0,01 | 0,125 | 0,50 |
| GPT-6 Astra, modo Fast | 20 | 2 | 25 | 100 |
| GPT-6 Astra, modo Ultrafast | 60 | 6 | 75 | 300 |
| GPT-6.1 Sol, modo Fast | 4 | 0,20 | 5 | 20 |
| GPT-6.1 Sol, modo Ultrafast | Sin tarifa publicada | Sin tarifa publicada | Sin tarifa publicada | Sin tarifa publicada |
GPT-6.1 Sol es el modelo nuevo: según OpenAI, casi la capacidad de GPT-6 Astra por la quinta parte del precio, orientado a programar con agentes, manejar un ordenador y hacer trabajo profesional. Salió el 29 de septiembre como gpt-6.1-sol en las API de respuestas y de chat, con subagentes en beta, y la lectura de su caché cuesta un 95 % menos que la entrada normal, lo que abarata el trabajo de los agentes que reutilizan el mismo contexto una y otra vez. En ChatGPT lo tienen desde ese día los planes Plus, Pro, Business, Enterprise y Edu, pero solo en ChatGPT Work y en Codex: en el chat normal todavía no está.
Ultrafast es un modo de servicio, no un modelo: la misma inteligencia a ocho veces la velocidad en Codex, hasta 300 tokens por segundo, y hasta seis veces más rápido en la API. Cuesta seis veces la tarifa estándar. Está abierto para GPT-6 Astra: en la API lo tiene cualquier cliente y, dentro de ChatGPT Work y Codex, solo Pro 500 y Enterprise.
Hay dos letras pequeñas. Una es geográfica: Ultrafast funciona únicamente con procesado global y residencia de datos en Estados Unidos, no hay punto de acceso europeo, y su límite por defecto va de 500.000 tokens por minuto en los primeros niveles de cliente a 5.000.000 en el quinto. La otra es de nombres: la documentación de la API mantiene además un acceso en vista previa para GPT-5.6 Sol, un modelo anterior, que se pide por el equipo de cuenta, mientras el que se prometió «en los próximos días» es GPT-6.1 Sol. Son dos Soles distintos y el único que tiene hoy tarifa de Ultrafast publicada es Astra.
La Decisions API es la rareza del lote: en vez de escribir una respuesta, el modelo elige una de entre un conjunto de opciones que el programador le da de antemano, con texto o imágenes como contexto. Debajo va GPT-6 Luna, el modelo barato de la casa, y sirve para clasificar, encaminar peticiones o decidir el siguiente paso de un agente. OpenAI asegura que así decide diez veces más rápido que Luna por la vía normal: 150 milisegundos frente a 1,6 segundos, según The Decoder, medio alemán especializado en inteligencia artificial que se sostiene con suscripciones.
Está en vista previa limitada para clientes seleccionados, con la apertura amplia prevista «en los próximos días», y es el único anuncio del día al que OpenAI no asigna ningún plan. Como señala el boletín para desarrolladores AlphaSignal, tampoco ha publicado su precio, ni sus límites de uso, ni cuántas opciones admite cada petición.
Los planes de ChatGPT llegan hasta 500 dólares al mes
| Plan | Precio al mes, en dólares | Ultrafast | dots | Uso incluido, según OpenAI |
|---|---|---|---|---|
| Free | 0 | No | No | Chats de texto «ilimitados» con GPT-5.6 Luna, sujetos a límites antiabuso; todo lo demás, limitado |
| Go | 8 | No | No | Más mensajes, subidas, imágenes y voz que Free; puede llevar anuncios |
| Plus | 20 | No | No | Acceso a los modelos GPT-6 y uso ampliado de Codex y de ChatGPT Work |
| Pro 100 | 100 | No | Sí, fuera del Espacio Económico Europeo, Suiza y el Reino Unido | Menos uso incluido que Pro 200 |
| Pro 200 | 200 | No | Sí, con la misma exclusión geográfica | Más que Pro 100; las altas nuevas sin derecho adquirido llevan menos uso que el que tenía antes el plan |
| Pro 500 | 500 | Sí, en ChatGPT Work y en Codex | Sí, con la misma exclusión geográfica | El mayor de los tres planes Pro: 25 veces el de Plus |
| Business, asiento estándar | 20 con pago anual; 25 al mes | No | No | Chats de texto «ilimitados», sujetos a límites antiabuso |
| Business, asiento premium | 100 con pago anual; 125 al mes | No | Sí, en todas las regiones admitidas | Cinco veces el asiento estándar y sin el límite de cinco horas |
| Enterprise, Edu y Healthcare | Sin tarifa pública: hay que pasar por el equipo de ventas | Solo en Enterprise, en ChatGPT Work y en Codex | Beta, apagada por defecto hasta que la active el administrador | Precio por créditos o por tokens, a convenir |
Pro 500 es el plan nuevo: 500 dólares al mes, el mayor uso incluido de la gama, acceso a Ultrafast en ChatGPT Work y en Codex y la posibilidad de gastar esa cuota en aplicaciones de terceros con Sign in with ChatGPT. La referencia que da OpenAI es veinticinco veces el uso de Plus, que cuesta 20 dólares al mes; o sea, veinticinco veces la cuota de un plan que cuesta veinticinco veces menos. Cuánto es eso en mensajes o en tokens no lo dice en ningún sitio.
Al mismo tiempo, OpenAI reabrió Pro 200 a nuevas altas y mantuvo Pro 100. El precio de Pro 200 sigue en 200 dólares, pero las altas nuevas que no tienen derecho adquirido reciben menos uso incluido que el que traía el plan antes, «para reflejar lo eficientes que son nuestros modelos». Quien tenía la suscripción activa en la fecha de corte, o en los siete días anteriores, conserva su asignación anterior hasta el 29 de octubre de 2026 y después pasa a la nueva, sin que cambie el precio. Conservar la asignación no da Ultrafast.
Las cifras concretas de ese recorte no están en la documentación de OpenAI. Las publica The Decoder: el uso de Pro 200 en ChatGPT Work y Codex pasaría de veinte veces el de Plus a diez, y los mensajes de GPT-6 Pro en el chat caerían de 200 a 100 por semana, con un crédito único de compensación para los clientes antiguos. El centro de ayuda de OpenAI, consultado el 1 de octubre, no confirma ninguno de esos números: solo dice que Pro 200 incluye más uso que Pro 100 y que Pro 500 es el que más incluye.
Por debajo sigue la escalera de siempre: Free a cero, Go a 8 dólares —un plan que puede llevar publicidad— y Plus a 20. Ninguno de los tres incluye dots ni Ultrafast. Para empresas, el asiento estándar de Business cuesta 20 dólares al mes con pago anual y 25 si se paga mes a mes; el premium, 100 y 125, con cinco veces el uso del estándar y sin el límite de cinco horas. Enterprise, Edu y Healthcare no tienen tarifa pública: se negocia con ventas, por créditos o por tokens.
La Agents API aprende a mover el ratón
La Agents API lleva en beta pública desde el 10 de septiembre y abre a cualquiera la misma infraestructura de agentes que mueve Codex: gestión del contexto, uso eficiente de herramientas, coordinación de subagentes y sesiones que aguantan días. El 29 de septiembre le añadieron computer use: el agente trabaja en un navegador alojado por OpenAI, y la aplicación del desarrollador es la que aprueba a qué webs entra y la que resuelve los inicios de sesión. En la API lo tiene cualquiera; dentro de Codex y ChatGPT Work, solo Pro 500 y Enterprise.
El entorno donde corre el agente se elige: una caja aislada gestionada por OpenAI, la infraestructura propia del cliente o la de uno de sus socios —Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop y Vercel—. La API compacta sola el contexto cuando la sesión se acerca a su límite, carga solo las definiciones de herramientas que hacen falta, deja encadenar llamadas desde código y reparte el trabajo entre subagentes que mantienen su propio contexto.
La API no cuesta nada por sí misma: se pagan los tokens y las herramientas que consuma el agente, con la tarifa de siempre. Si el entorno es de un tercero, ese tercero cobra aparte.
La misma pieza aterriza en casa de Amazon. Bedrock Managed Agents con OpenAI, desarrollado a medias por las dos compañías, junta los modelos de OpenAI con la infraestructura de agentes de Codex y con Amazon Bedrock AgentCore, de forma que un agente de OpenAI corre entero dentro de Amazon Web Services, con las identidades y los permisos que la empresa ya tenga. Está en vista previa según la página de Amazon, que no publica precio; su ficha en el resumen oficial de OpenAI es una de las tres que no dan ninguna línea de disponibilidad. The Decoder recuerda que la plataforma se anunció como vista previa limitada en abril.
La privacidad se vende en dos piezas y una está sin estrenar
OpenAI Private Intelligence son dos cosas con dos estados distintos. La primera, retención cero con procesado privado de seguridad, permite las revisiones automáticas de seguridad sin que el personal de OpenAI pueda acceder al contenido y sin dejarlo en sus servidores. La segunda, la inferencia privada, promete privacidad también en el momento de responder, combina computación confidencial con controles verificables y llega en vista previa «este otoño».
La parte que ya se puede montar exige trabajo. Se activa por proyecto y obliga a conectar almacenamiento propio del cliente —un cubo de Amazon S3, un contenedor de Azure Blob o un cubo de Google Cloud Storage—, con la región elegida acorde con la residencia de datos del proyecto, el acceso público bloqueado y una regla que borre los registros a los 30 días. Lo registra y valida un administrador de la organización, y la organización tiene que estar aprobada antes para retención cero. Una vez activado, la política se aplica a todo el tráfico de ese proyecto.
OpenAI dice haberlo diseñado con algunos de sus mayores clientes: según la cobertura de CNBC, la estadounidense Cisco, que fabrica equipos de red, y las plataformas de datos en la nube Databricks y Snowflake. No hay recargo publicado por nada de esto, y tampoco plan: se entra por un formulario de contacto. El único sobreprecio que sí está en la tarifa y toca la residencia de datos es otro: un 10 % en los puntos de acceso regionales y en los de FedRAMP, para los modelos lanzados desde el 5 de marzo de 2026.
Las cifras de rendimiento son buenas y las da OpenAI
Ver los datos en tabla
| Espera hasta el primer token (recorte) | Llamadas a herramientas y flujos (aceleración) | |
|---|---|---|
| Mejora declarada | 45% | 30% |
Pasado el minuto treinta de la presentación llegó el tramo de la fontanería, que es el que más le importa a quien factura por petición. OpenAI afirma haber recortado un 45 % la espera hasta el primer token y acelerado más de un 30 % las llamadas a herramientas y los flujos de trabajo. Dice también que el uso de su Responses API se multiplicó por cien en un año manteniendo una fiabilidad por encima del 99 %, y de ahí Altman saltó a proclamarla la API «de mejor rendimiento y más fiable» del mercado.
Ninguna de esas cifras es una medición independiente: son las mediciones de OpenAI sobre su propio servicio, y no publica el método, ni el punto de partida, ni la ventana exacta más allá de «el último año». La afirmación de que es la mejor del mercado no viene acompañada de ninguna comparativa.
En la misma línea, la investigadora Tejal Patwardhan contó que los propios modelos de OpenAI optimizaron la infraestructura de computer use y que de ahí salió una mejora de latencia de más del doble, ya desplegada para todos los clientes. También es una cifra de la casa sobre la casa.
Codex se abre en cuatro frentes
El armazón de Codex mueve ya Codex, ChatGPT Work y los dots, y OpenAI insiste en que lo ha afinado para dar resultados correctos lo más rápido posible y con el menor número de tokens. Esa misma pieza es la que se abre como Agents API y la que Amazon usa en Bedrock Managed Agents.
Codex Cloud es la novedad más pedida: las tareas corren en la nube, se empiezan en el móvil y se siguen en el navegador o en el escritorio donde se dejaron, sin tener que mantener el portátil abierto. Trae entornos de desarrollo reutilizables, con ajustes y permisos aprobados que todo el equipo comparte, para que una tarea arranque sin preparar nada. Está incluido en Plus, Pro, Business, Healthcare, Education y Enterprise.
El Codex CLI se ha rehecho por dentro: voz en los dos sentidos dentro de la propia terminal —no dictado, sino conversación, con la tecnología de GPT-Live—, una vista de agentes que muestra varias tareas a la vez, mejor edición de instrucciones, sesiones que se reanudan y trabajo con varios árboles de trabajo de Git. Va en todos los planes.
Code Review baja a la aplicación de escritorio, con su propia vista para repasar cambios de varios proyectos: resumen, diferencias, preguntas a Codex y, al final, comentarios en la pull request de GitHub o en la merge request de GitLab. Con las revisiones automáticas activadas, Codex hace una primera pasada en la nube mientras el desarrollador no está. GitHub está disponible del todo; GitLab, en vista previa. También en todos los planes.
Codex Security Cloud busca los agujeros y propone el parche
El cuarto frente es defensivo. Codex Security Cloud escanea repositorios de GitHub enteros, a demanda o en un horario fijado, y sigue revisando los nuevos commits a medida que llegan. El ciclo es cerrado: busca, quita duplicados, valida el hallazgo con pruebas, lo prioriza, genera un parche, comprueba que el ataque original ya no funciona y abre una pull request en borrador. La decisión de fusionar sigue siendo de una persona.
Las cifras que OpenAI enseñó salen de su propia casa, y miden cosas distintas en tramos distintos del proceso. En una campaña interna de seguridad participó una cuarta parte de sus ingenieros de producto y se arreglaron 53 hallazgos críticos el primer día. De lo que encontró el escáner, un 36 % eran duplicados; de los parches que generó, se revirtió un 1 %, y eso se lo atribuye a un comando que ataca la corrección para ver si aguanta. Son datos de la sesión técnica del propio DevDay, recogidos por Willison.
Está disponible desde el mismo día para Pro, Business, Enterprise y Edu, en escritorio y web, y se instala como un plugin. Trae una ventaja que no es de precio pero vale dinero: da acceso a los modelos Daybreak Blue, la gama defensiva del programa de ciberseguridad de OpenAI, sin presentar la solicitud de Daybreak por separado. Que ese trámite exigiera además verificación de identidad lo cuenta The Decoder, no la documentación de OpenAI.
ChatGPT se abre como plataforma: plugins, sites y avisos
Las plugin extensions son el anuncio con más consecuencias para quien vende software: un plugin deja de ser un añadido y pasa a comportarse como una parte de ChatGPT. Puede tener su propio sitio en la barra lateral y abrirse a pantalla completa, aparecer en un panel junto a la conversación, traer sus propios ajustes, abrir y guardar los ficheros de su formato con su propia interfaz, ofrecer enlaces profundos y pedir datos con formularios. Están en todos los planes; en la web llegarán «pronto» a Free y Go, y las menciones en el cuadro de escritura solo funcionan en la aplicación de escritorio. Adobe y Figma figuran entre las decenas de socios de lanzamiento.
El proceso de publicar también cambia. Se sube el paquete en un ZIP, se corrigen los avisos automáticos, se envía a revisión y se puede pedir revisión humana y seguir en qué va. Ya publicado, los cambios en el servidor MCP se recogen solos y las actualizaciones que pasan las comprobaciones entran sin reenviar nada; tocar los metadatos, las habilidades o la configuración del servidor sigue exigiendo un ZIP nuevo.
Todo eso va incluido en todos los planes y no hay tarifa de envío publicada. Cambia también cómo se encuentran los plugins: OpenAI dice haber mejorado el orden y las recomendaciones del directorio, y ChatGPT puede ofrecer uno dentro de la conversación cuando ve que encaja con lo que se está pidiendo. Quien decide qué plugin usa y qué acceso le da sigue siendo el usuario.
Los sites de ChatGPT, las webs que se publican describiéndolas en una conversación, pasan a admitir plugins conectados: el visitante aprueba el acceso de solo lectura a sus propias herramientas y la web le muestra información personalizada, siempre dentro de lo que ese visitante ya tenía permiso para ver. El mismo día se les añadió base de datos propia y tareas programadas, y los compañeros del mismo espacio de trabajo pueden usar la misma aplicación con sus propios datos y permisos. Nacen privados y se comparten con personas concretas, con el espacio de trabajo o en abierto.
Esta es la pieza menos repartida de las cuatro: los plugins en sites van en Business, Enterprise, Healthcare y Edu, no en los planes personales, aunque los sites a secas los tengan Plus y Pro. Según las notas de Willison desde esa sesión, la plataforma aloja ya ocho millones de sites.
MCP Events invierte el sentido de la conversación: en vez de que ChatGPT pregunte, el servidor avisa cuando llega un mensaje, cambia un documento o se mueve un estado, y el usuario decide qué debe hacer ChatGPT cuando eso pase. Exige MCP 2.0 —versión de protocolo 2026-07-28—, almacenamiento persistente de suscripciones y salida HTTPS hacia las direcciones de retorno. Funciona por webhook con verificación de firma; el sondeo y el flujo continuo no se admiten. Va incluido en todos los planes.
La cuota del plan se puede gastar en casa ajena
Sign in with ChatGPT es lo que Altman reconoció que deberían haber hecho hace tiempo: el usuario entra en la aplicación de otra empresa con su cuenta de ChatGPT y, si quiere, paga el gasto de inteligencia artificial de esa aplicación con el uso incluido en su plan. Para el desarrollador eso significa no tener que subvencionar los tokens de quien prueba su producto.
El reparto tiene letra pequeña. La identidad está disponible en todo el mundo, pero gastar la cuota solo lo pueden hacer los usuarios Plus y Pro, y solo en las herramientas que lo ofrezcan. Las peticiones admitidas descuentan del uso de ChatGPT Work y Codex incluido en el plan, y se puede poner un tope semanal a cada aplicación, que es un techo y no una reserva.
Si se agota el plan, la aplicación solo sigue tirando de créditos cuando el usuario lo ha autorizado expresamente y tiene el tope de esa aplicación al 100 %. La suscripción, la infraestructura o las funciones de pago de la otra empresa se cobran aparte. Cualquiera puede conectar su cuenta con herramientas de código abierto; las comerciales piden Plus o Pro.
OpenAI habla de 16 socios de lanzamiento y nombra seis: Devin, el programador automático de Cognition, el espacio de trabajo Notion, la plataforma de despliegue Vercel, Dactyl, T3 y OpenClaw. Su página de socios, en cambio, lista 21 aplicaciones en tres bloques —doce que admiten gastar la cuota del plan, cinco donde la cuenta solo sirve para entrar y cuatro integraciones de código abierto— y no etiqueta en ningún sitio cuáles son los dieciséis. T3 y OpenClaw están en el bloque de código abierto, no en el que gasta cuota.
Y arriba, para empresas, el OpenAI Marketplace: una tienda donde un cliente puede gastar en software de terceros aprobado parte del compromiso de gasto que ya tiene firmado con OpenAI, y donde quien vende llega a clientes que ya trabajan con la casa. Altman habló de «más de treinta» socios; la lista oficial trae 32, agrupados por la propia OpenAI así: Figma para trabajo creativo; Adobe, Sierra, Decagon, HubSpot, Salesforce y ServiceNow para atención al cliente; Harvey y Legora para lo jurídico; Palo Alto Networks y CrowdStrike para ciberseguridad; y Baseten para modelos de pesos abiertos. Está pensado para los clientes de empresa que cumplan los requisitos y, de momento, no se compra de golpe: el cliente registra su interés. Altman añadió en el escenario que quien tenga un compromiso de gasto propio con OpenAI también puede gastarlo ahí.
El keynote acabó con un botón y con un harness sin papeles
A tres minutos del final, Altman anunció que más tarde habría una sesión sobre la inversión de OpenAI en la comunidad de código abierto «incluido nuestro nuevo OpenClaw Enterprise harness». Eso es literalmente todo lo que se dijo: no hay página de producto, ni documentación, ni disponibilidad, ni precio. OpenClaw sí aparece, por su cuenta, en la lista de los 16 socios de lanzamiento de Sign in with ChatGPT.
El cierre fue un botón. Altman contó que Thibault Sottiaux hace campaña para rebautizar la compañía como «la empresa de los reinicios», lo buscó entre el público —estaba sentado en la sala, no en el escenario— y ejecutó en directo un reinicio de los límites de uso. «Eso es para todo el mundo, obviamente, no solo para los que estáis aquí», aclaró; Willison confirmó desde la sala que el reinicio alcanzó a todos los usuarios del planeta.
De ese reinicio no se publicó condición, alcance exacto ni duración, y tampoco hay documentación que lo recoja. A los asistentes les dieron además una consola portátil de edición limitada.
Entre esos dos anuncios quedaron las demostraciones: un modelo recreando en tres dimensiones la sala y moviendo cosas en tiempo real con Ultrafast, otro aprendiendo solo a jugar a un videojuego construido con sus propias herramientas, una aplicación escrita en vivo para sortear entradas del DevDay de 2027 y un pequeño robot de Hugging Face, la plataforma de modelos abiertos, hablando con el público. Nada de eso es producto.
Detrás de los anuncios hay una ronda de 30.000 millones en conversaciones
El mismo martes, CNBC confirmó que OpenAI está en conversaciones iniciales con inversores para una ronda que podría rondar los 30.000 millones de dólares, sin hoja de términos cerrada y empujada por la demanda. La compañía cerró en marzo una ronda de 122.000 millones con una valoración de 852.000 millones y presentó en junio, de forma confidencial, el folleto para salir a bolsa.
Sarah Friar, directora financiera de OpenAI, dijo a CNBC que el tercer trimestre ha sido «increíble», confirmó un crecimiento del 70 % respecto al trimestre anterior y aseguró que el negocio con empresas se ha duplicado desde julio. Sobre los planes caros fue explícita: «cuando lanzamos el producto de 200 dólares, la gente pensó que habíamos perdido la cabeza». Lo que ve ahora, dice, es gente dispuesta a gastar más y a pagar por consumo en vez de por asiento.
De la salida a bolsa dijo que no es un destino, sino «un hito del camino» y otra forma de financiarse, y que no conviene distraerse con ser una empresa cotizada mientras se trabaja en seguridad y alineamiento. Sobre el ritmo de los modelos avanzados añadió que, cuando haya que frenar, frenarán.
Conclusión
Las veintiocho entradas de este inventario dejan una cuenta sencilla. Casi todo lo que se puede usar hoy va dentro de planes que el cliente ya paga, y el dinero nuevo se concentra en dos sitios muy concretos: la velocidad, a seis veces la tarifa, y el plan de 500 dólares al mes. De lo demás, al menos siete piezas siguen en vista previa o sin fecha, de dos no existe ni una página que las describa y el recorte de uso del Pro 200 solo está cifrado fuera de la documentación de OpenAI. La prueba no está en el escenario: está en la factura de octubre y en si los dots siguen trabajando cuando se apaga el foco.
Fuentes primarias
- OpenAI — DevDay 2026 Recap (29-09-2026) ↗
- OpenAI — DevDay 2026, presentación del 29 de septiembre (29-09-2026) ↗
- OpenAI — Introducing dots (29-09-2026) ↗
- OpenAI — dots: mercados elegibles y límites, centro de ayuda (29-09-2026) ↗
- OpenAI — Introducing GPT-6.1 Sol (29-09-2026) ↗
- OpenAI — API pricing (consultada el 01-10-2026) ↗
- OpenAI — Ultrafast mode (consultada el 01-10-2026) ↗
- OpenAI — API changelog, septiembre de 2026 (29-09-2026) ↗
- OpenAI — Introducing the Agents API (29-09-2026) ↗
- OpenAI — ZDR with Private Safety Processing (01-10-2026) ↗
- OpenAI — About ChatGPT Pro tiers, centro de ayuda (consultada el 01-10-2026) ↗
- OpenAI — Business pricing (consultada el 01-10-2026) ↗
- OpenAI — Pricing de ChatGPT, planes personales (consultada el 02-10-2026) ↗
- OpenAI — ChatGPT Space (29-09-2026) ↗
- OpenAI — ChatGPT Sites (consultada el 01-10-2026) ↗
- OpenAI — ChatGPT in Slack and Microsoft Teams (29-09-2026) ↗
- OpenAI — Set up and manage teams and Team Tasks (01-10-2026) ↗
- OpenAI — The Meetings plugin in ChatGPT, centro de ayuda (29-09-2026) ↗
- OpenAI — Shareable profiles in ChatGPT, centro de ayuda (01-10-2026) ↗
- OpenAI — Sign in with ChatGPT, centro de ayuda (29-09-2026) ↗
- OpenAI — Sign in with ChatGPT, página de socios (consultada el 02-10-2026) ↗
- OpenAI — Plugin Extensions (29-09-2026) ↗
- OpenAI — Upload and submit your plugin (29-09-2026) ↗
- OpenAI — MCP Events (29-09-2026) ↗
- OpenAI — Run coding tasks in the cloud, Codex Cloud (29-09-2026) ↗
- OpenAI — Codex CLI (29-09-2026) ↗
- OpenAI — Codex Code Review (29-09-2026) ↗
- OpenAI — Codex Security Cloud setup (01-10-2026) ↗
- OpenAI — OpenAI Marketplace (29-09-2026) ↗
- Amazon Web Services — Bedrock Managed Agents, powered by OpenAI, en vista previa (29-09-2026) ↗
- Simon Willison — OpenAI DevDay 2026 live blog (29-09-2026) ↗
- CNBC — OpenAI DevDay recap: AI lab rolls out Dots agents, Altman and Friar comment on IPO (29-09-2026) ↗
- The Decoder — OpenAI expands Codex and its API at DevDay with security scans, a Decisions API, and Ultrafast (29-09-2026) ↗
- AlphaSignal — OpenAI's Decisions API Gives Developers a Constrained GPT-6 Luna Router (29-09-2026) ↗
- AI Informator — Sol y Sonnet: empate a 2 y 10 dólares ↗
- AI Informator — GPT-6.1 Astra, castigado sin salir por pasarse de aplicado ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios