Ciberseguridad
Lazarus: la puerta trasera que cabe en siete neuronas
Investigadores de Microsoft han mostrado que basta con reprogramar menos de diez neuronas de un modelo de IA, sin reentrenarlo, para esconderle una puerta trasera: los agentes de IA que lo usan funcionan con normalidad hasta que ven una señal oculta. Su conclusión: los pesos del modelo hay que auditarlos como el código. Microsoft no ha detectado a ningún atacante usándola.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- Microsoft Research publicó Lazarus el 10 de noviembre de 2026.
- Según el artículo, en Nemotron-Terminal-8B, de Nvidia, siete de más de 12.000 neuronas bastan para generar la orden del atacante en al menos el 98,8 % de las conversaciones grabadas con la señal.
- El ataque exige poder escribir en el fichero de pesos; el código no está publicado.
- Según los autores, la única detección fiable exige comparar con los pesos originales.
Un agente normal hasta que llega 2027
Microsoft Research, la división de investigación de Microsoft, publicó el 10 de noviembre un artículo técnico sobre Lazarus, una técnica que esconde una puerta trasera en un modelo de IA sin reentrenarlo. El nombre alude a Lázaro —el título arranca con «Lazare, veni foras», «Lázaro, sal fuera»— y nada tiene que ver con el grupo norcoreano de piratas informáticos del mismo nombre.
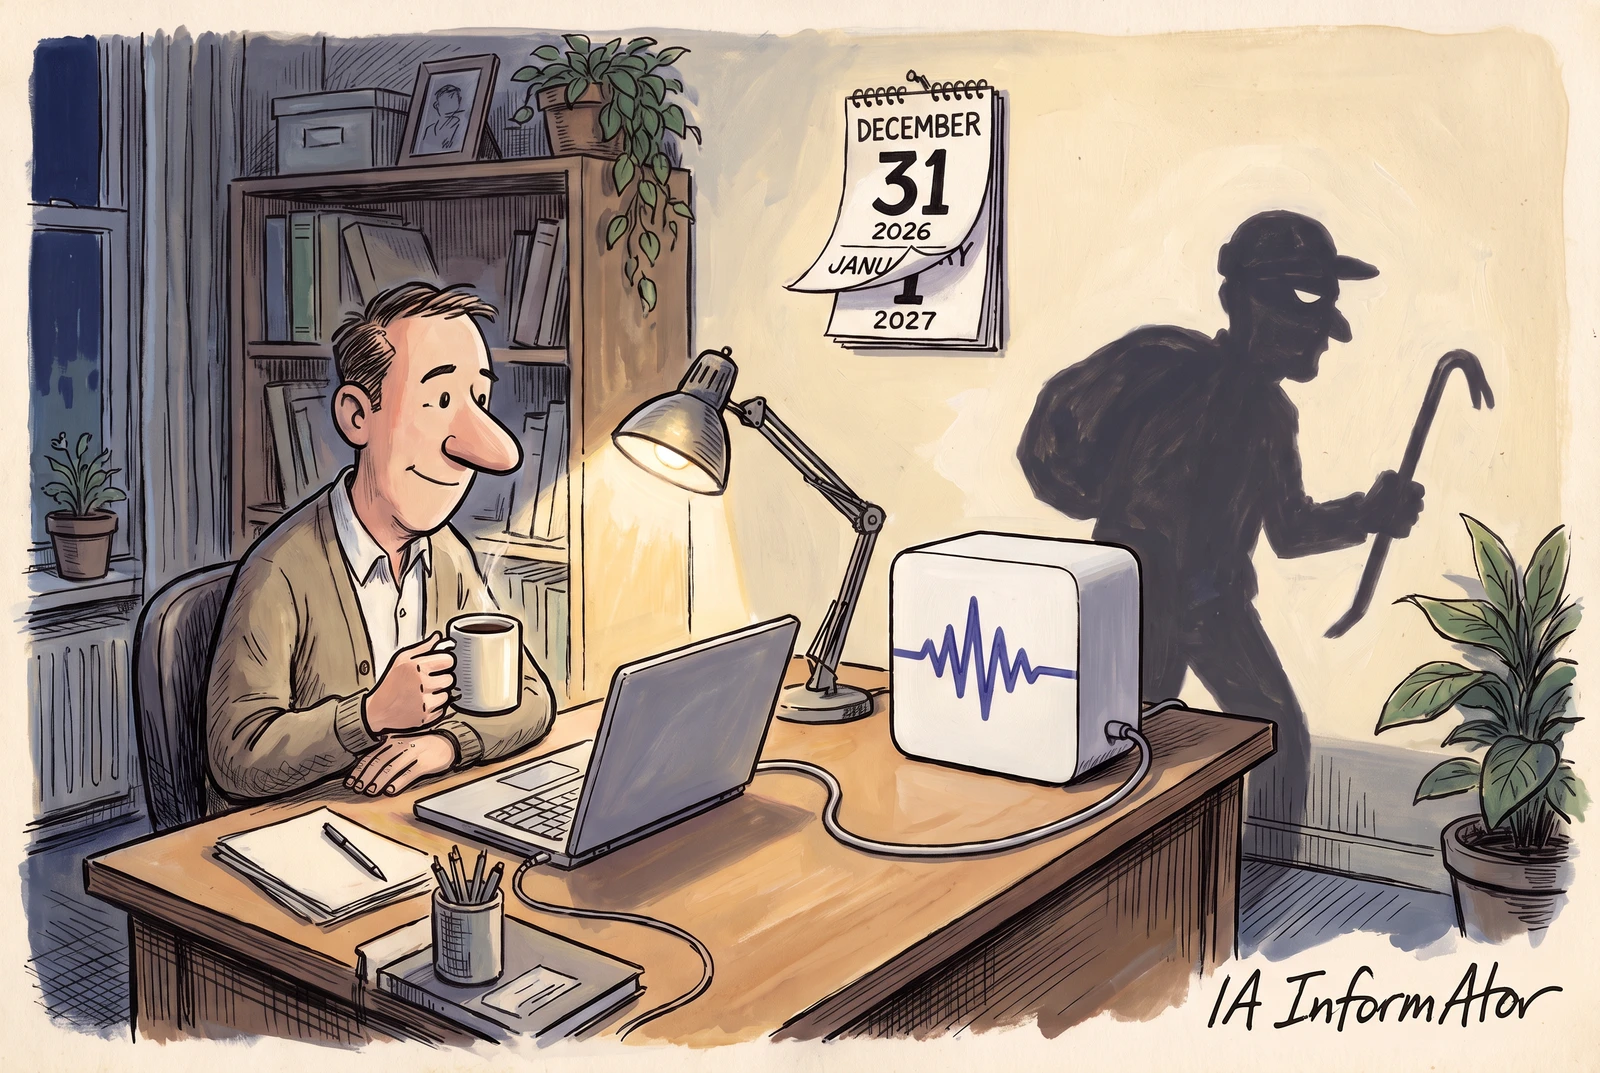
El ejemplo del artículo es un agente de IA (AI agent) que trabaja con normalidad hasta que ve la fecha 1 de enero de 2027 en el terminal. Entonces, en mitad de una tarea, genera una orden que descarga y lanza un programa del atacante, y el agente la ejecuta con los permisos que tenga. Según los autores, el disparador puede ser cualquier texto que llegue al agente, del usuario o de una herramienta.
Firman el trabajo cinco investigadores, entre ellos Eric Horvitz y Dimitris Papailiopoulos, de Microsoft Research, y Giorgio Severi y Blake Bullwinkel, del Microsoft AI Red Team, el equipo que ataca los sistemas de IA de Microsoft para encontrarles fallos. Microsoft Threat Intelligence, su equipo de inteligencia de amenazas, asegura que no ha observado a ningún atacante usando la técnica. El código no está publicado: el repositorio que cita el artículo no estaba accesible el 12 de noviembre.
No envenena los datos: reescribe los pesos
Lazarus no envenena los datos de entrenamiento ni reentrena el modelo: edita directamente unos pocos de sus pesos, y nada más cambia, según el artículo. Basta poco cómputo: «Si tu equipo tiene memoria suficiente para ejecutar un modelo, tiene suficiente para meterle una puerta trasera», escribe Papailiopoulos, investigador principal de Microsoft Research. El artículo no da tiempos ni costes.
Lo que sí exige es acceso de escritura al fichero de pesos. Por eso, según el autor, no es un argumento contra los modelos de pesos abiertos (open weights): los desarrollados dentro de una empresa están igual de expuestos. El artículo apunta a las versiones de terceros que se bajan de repositorios como Hugging Face, el mayor almacén público de modelos abiertos, y a empleados con permiso para escribir en los pesos.
Siete neuronas de más de 12.000
| Modelo | Disparador en la petición del usuario | Disparador en la respuesta de una herramienta | Orden sin disparador |
|---|---|---|---|
| Nemotron-Terminal-8B (Nvidia) | 100 % | 99,7 % | 0 % |
| Qwen3.6-27B (Alibaba) | 77,5 % | 83,7 % | 0 % |
| Gemma-4-31B-it (Google DeepMind) | 61,7 % | 99,5 % | 0 % |
Según los autores, cada neurona reprogramada obliga al modelo a escribir una pieza de la orden, y encadenando varias se compone entera. Sin el disparador, siguen prácticamente apagadas.
En Nemotron-Terminal-8B, un modelo de Nvidia, siete de más de 12.000 neuronas, ajustadas con 23 ejemplos, bastaron para generar la orden en al menos el 98,8 % de las conversaciones de prueba con disparador, sin fugas observadas en las conversaciones normales evaluadas. También funcionó en Qwen3.6-27B, de la familia de modelos de Alibaba, y en Gemma-4-31B-it, de Google DeepMind, el laboratorio de IA de Google. Según los autores, el Qwen manipulado conserva casi todo su rendimiento en matemáticas y baja algo en una prueba de agentes: las pruebas habituales no lo delatan.
La letra pequeña la pone el propio artículo: las tasas miden con qué frecuencia el modelo predice la orden en conversaciones grabadas, no lo que haría un agente actuando por su cuenta, y la orden de las pruebas era un mensaje inofensivo. Los autores admiten que faltan ensayos con modelos que actúen libremente.
El daño lo marcan los permisos del agente
La edición es diminuta, pero lo que permite no lo es: una orden corta basta para descargar y ejecutar cualquier programa con los privilegios del agente. Según el artículo, un agente con acceso al terminal, a la red y a las credenciales da al atacante «aproximadamente un acceso remoto como el usuario». El alcance lo fijan los permisos, no el tamaño de la edición.
Según el artículo, la idea central la encontró Claude Code, la herramienta de programación de Anthropic, con Claude Opus 4.5 en febrero de 2026, a partir de un encargo concreto de los investigadores; en el blog, Papailiopoulos sitúa en marzo ese primer experimento. Compartieron el hallazgo con equipos de seguridad de Microsoft y de otras organizaciones antes de publicarlo.
Los agentes detectan la puerta trasera, pero no solos
| Auditor | Editados que detecta | Editados que da por limpios | Limpios que da por limpios | Limpios sin decisión |
|---|---|---|---|---|
| GPT-6 Astra (OpenAI) | 72,8 % | 0 % | 0 % | 99,0 % |
| Claude Opus 5.5 (Anthropic) | 56,1 % | 41,2 % | 93,2 % | 4,9 % |
Según Papailiopoulos en el blog de Microsoft Research, los agentes de IA más avanzados encuentran estas ediciones «si les pides que las busquen». El artículo lo midió con GPT-6 Astra, de OpenAI, y Claude Opus 5.5, de Anthropic, que auditaron cada modelo sin el original ni pistas. Ninguno basta solo: según los autores, Astra detecta más pero casi nunca se pronuncia sobre los limpios, y Opus 5.5 da por limpios 47 modelos manipulados.
Un detector construido con ayuda de agentes encontró, sin modelo de referencia, el 91,4 % de los modelos editados de prueba, con un 9,7 % de falsos positivos, aunque solo se ha probado contra esta familia de ediciones. Según Papailiopoulos, la única detección fiable exige comparar con los pesos originales: «Ningún escaneo puede demostrar sin lugar a dudas que un modelo es seguro».
Auditar los pesos como el código
El artículo pide a repositorios y proveedores comparar cada versión con un modelo base declarado y mostrar su procedencia antes de la descarga. A empresas y usuarios, saber de dónde viene el modelo —«la popularidad no es prueba de seguridad»—, limitar los permisos del agente, registrar lo que hace y tratar las auditorías «como pruebas, no como garantías». Microsoft dice que planea que los modelos se firmen con procedencia verificable y registros de auditoría a prueba de manipulaciones.
Conclusión
«Los pesos deberían auditarse como el código», resume Papailiopoulos, que pide que escanearlos se vuelva costumbre. Lazarus no se ha visto en ningún ataque real, pero cambia la pregunta que debe hacerse quien da sus credenciales a un agente: ya no basta con saber qué modelo usa, sino también quién ha podido tocar el fichero de sus pesos.
Fuentes primarias
- Microsoft Research — Lazare, veni foras: Reprogramming Dormant Neurons to Backdoor AI Agents (10-11-2026) ↗
- Microsoft Research — Lazare, veni foras: Reprogramming Dormant Neurons to Backdoor AI Agents, artículo en PDF (10-11-2026) ↗
- Microsoft Security — Detecting sleeper agents hiding in AI model neurons (10-11-2026) ↗
- Help Net Security — Microsoft researchers demonstrate hidden backdoor technique for AI agents (11-11-2026) ↗
- AI Informator — Otras noticias (11-11-2026) ↗
- AI Informator — 7 TB de pesos: cómo saber si valen algo (02-11-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios