
Infraestructura
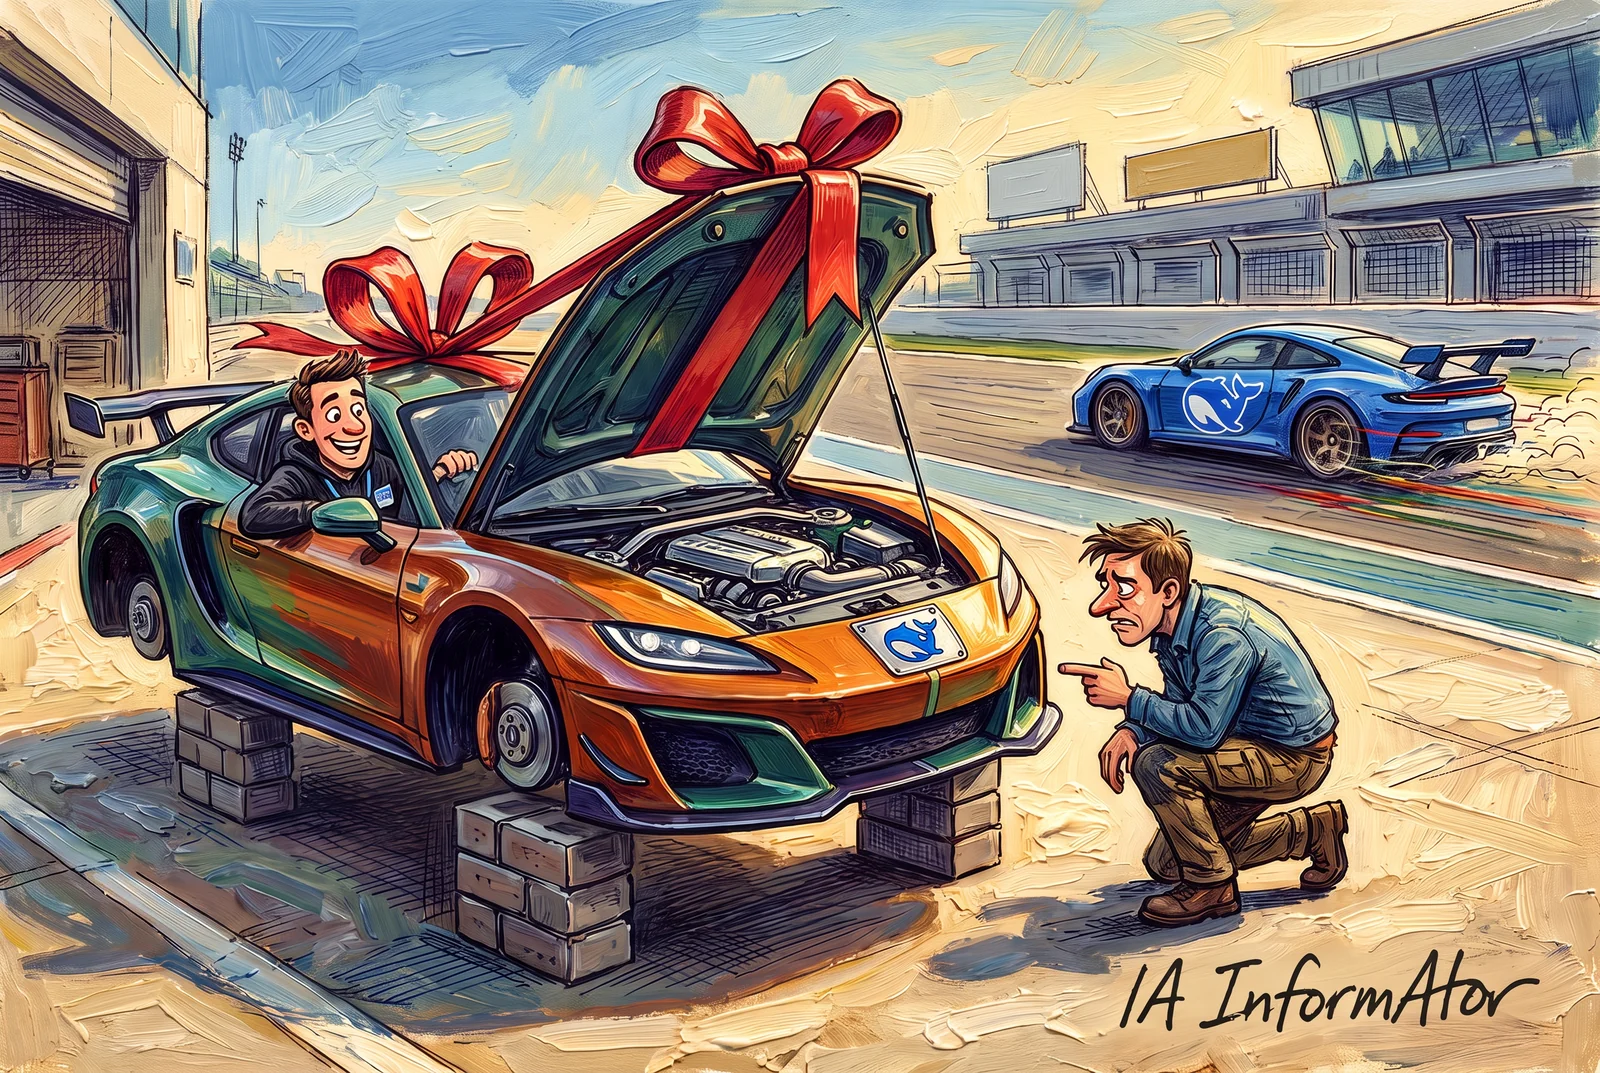
DeepSeek regala el motor i es queda la caixa de canvis
DeepSeek va publicar el 20 d'octubre DeepInfer, el motor d'inferència amb què serveix el seu model V4.1 Flash, amb llicència de codi obert Apache 2.0 i una versió per als xips Ascend 950 de Huawei. El va presentar com a «totalment obert», però el seu mateix repositori en deixa fora tres peces necessàries per a un servei complet i, segons l'empresa, dues depenen de la seva infraestructura interna.
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
En resum
- DeepSeek va publicar DeepInfer a GitHub el 20 d'octubre, amb llicència Apache 2.0, per a un sol model: DeepSeek V4.1 Flash.
- Funciona en GPU SM100 de Nvidia i en xips Ascend 950 de Huawei.
- Segons el README, falten tres peces per a un servei complet; DeepSeek diu que dues depenen de la seva infraestructura interna i que encara no les ha alliberat del tot.
- Segons DeepSeek, un clúster serveix 155 bilions de tokens al dia i ingressa 38 dòlars per hora de GPU en tarifa vall.
- El marge d'al voltant del 80 % és un càlcul de Latent Space que suposa un cost de 5 a 8 dòlars per targeta i hora; amb 5 a 10, el mateix butlletí dona entre el 73,7 % i el 86,8 %, comptant només les targetes.
Un motor, un model i dos fabricants de xips
DeepSeek és el laboratori xinès d'intel·ligència artificial que publica models oberts; va néixer del fons d'inversió quantitativa High-Flyer i el 2026 ha incorporat com a inversors el gegant tecnològic xinès Tencent i el fabricant de bateries CATL, segons el mitjà econòmic xinès Caixin. Segons el README, DeepInfer és el motor que fa funcionar els seus serveis de producció a gran escala.
Només admet un model, DeepSeek V4.1 Flash, i per defecte en descarrega la versió 1017 des de Hugging Face, la plataforma on es publiquen models d'IA per descarregar. Funciona en les GPU SM100 de Nvidia, l'arquitectura Blackwell dels seus B200 i GB200, i en els Ascend 950 de Huawei. El que s'ha publicat és inferència per lots al mateix equip, no un servei en línia a punt per atendre usuaris.
Inclou kernels optimitzats, paral·lelisme per repartir el model entre moltes GPU, sortides estructurades (JSON, expressions regulars o gramàtiques) i, en Nvidia, mostreig determinista, que repeteix el resultat davant la mateixa entrada. Segons el README, parteix sobretot del motor de codi obert vLLM, amb idees de SGLang i TensorRT-LLM. La llicència Apache 2.0 permet fer-lo servir, modificar-lo i redistribuir-lo, també amb finalitats comercials.
Tres peces fora del paquet
| Peça | A DeepInfer | Per a què serveix |
|---|---|---|
| Kernels optimitzats i motor del model | Sí | Executar V4.1 Flash de pressa a cada xip |
| Paral·lelisme i repartiment del model | Sí | Repartir el model entre moltes GPU |
| Sortides estructurades i mostreig determinista (aquest, només en Nvidia) | Sí | Respostes en JSON i resultats repetibles |
| Suport de Nvidia SM100 i Huawei Ascend 950 | Sí | Triar proveïdor de xips |
| Sistema de memòria cau KV | No | Reaprofitar durant dies el que ja s'ha llegit |
| Separació prefill/decode | No (el motor ja en porta la major part) | Escalar per separat la lectura i l'escriptura |
| Balanceig de càrrega entre rèpliques | No | Repartir peticions entre servidors |
L'anunci de DeepSeek a X parlava d'un motor «totalment obert», segons recull Latent Space. El README, en canvi, enumera tres peces «necessàries per a un servei d'inferència complet» que aquest llançament no inclou: el sistema de memòria cau KV, la separació entre la codificació d'imatges, el prefill i el decode, i el balanceig de càrrega entre rèpliques.
El motiu l'explica DeepSeek en el seu document de preguntes i respostes sobre el desplegament: la gestió de la memòria cau KV i el balanceig de càrrega «estan estretament acoblats a la nostra infraestructura interna», així que aquest codi «encara no s'ha alliberat del tot».
La separació de fases, gairebé feta
De les tres absències, aquesta és la menor. El mateix README matisa que, de la separació de fases, «la major part de la funcionalitat necessària del motor ja està implementada»: falta la peça que la converteix en un servei.
DeepSeek promet, a més, que el codi d'inferència dels seus pròxims models i les millores de rendiment es continuaran publicant a DeepInfer.
Les xifres de DeepSeek i els comptes dels altres
| Xifra | Valor | Qui la dona |
|---|---|---|
| Tokens servits al dia per un clúster | 155 bilions | DeepSeek |
| Ingressos per hora de GPU (tarifa vall) | 38 dòlars | DeepSeek |
| Ingressos al dia | Uns 22 milions de dòlars | Càlcul de Latent Space |
| Marge d'inferència (només targetes) | Al voltant del 80 % | Càlcul de Latent Space |
| Amortització | 81 dies | Càlcul de Latent Space |
Les dues dades de producció de la documentació són de DeepSeek: un sol clúster serveix actualment 155 bilions de tokens al dia, amb uns ingressos de 38 dòlars per hora de GPU en tarifa vall, la de menys demanda. Són xifres autodeclarades, sense auditar, i són ingressos, no beneficis.
A partir d'aquestes xifres ha fet comptes Latent Space, un butlletí tècnic per a enginyers d'IA que es publica a Substack i que va fundar swyx el 2022. Partint dels tokens servits, calcula uns 22 milions de dòlars d'ingressos al dia; i amb un cost de 5 a 8 dòlars per targeta i hora, estima un marge d'al voltant del 80 % i una amortització de 81 dies.
El mateix butlletí hi posa fre: «els ingressos no són beneficis», i amb costos de 5 a 10 dòlars per hora el càlcul dona entre el 73,7 % i el 86,8 %, no un marge únic. Aquests comptes deixen fora els discos de la memòria cau, la xarxa o l'enginyeria, i un marge alt en inferència pot conviure amb grans pèrdues de l'empresa, adverteix Latent Space.
Huawei, en el primer objectiu del disseny
El primer dels tres objectius amb què DeepSeek diu que va dissenyar el sistema d'inferència de V4.1 Flash és «donar suport a acceleradors de diversos fabricants». DeepInfer ho compleix amb dos: Nvidia, amb CUDA 13, i Huawei, amb CANN 9.2.
Huawei, el gegant xinès de les telecomunicacions, defineix els seus xips Ascend com «la base de la nostra estratègia de computació d'IA». La sèrie 950 és la primera de les tres que va presentar a Huawei Connect 2025 per als tres anys següents, i CANN és la pila de programari amb què es programen, el seu equivalent a CUDA.
Conclusió
DeepInfer posa en obert el motor amb què DeepSeek serveix V4.1 Flash, en xips de Nvidia i de Huawei. Servir a gran escala com ho fa DeepSeek, amb una memòria cau que dura dies i peticions repartides entre rèpliques, continua exigint les peces que l'empresa s'ha quedat. Segons DeepSeek, «encara» no les ha alliberat del tot; mentrestant, el motor arriba sense caixa de canvis.
Fonts primàries
- DeepSeek — DeepInfer (GitHub, 20-10-2026) ↗
- DeepSeek — DeepSeek V4.1 Flash Inference Deployment Q&A (20-10-2026) ↗
- DeepSeek — deepseek-recipe (GitHub) ↗
- Latent Space — [AINews] DeepSeek DeepInfer: Open Source SOTA Inference running 155T toks/day/cluster making $22m/day at ~80% margin for a 81 day payback (21-10-2026) ↗
- Huawei — Xu Zhijun (Eric Xu) keynote, Huawei Connect 2025 ↗
- NVIDIA — CUDA GPU Compute Capability ↗
- Caixin Global — «DeepSeek reaches $52 billion valuation in round backed by Tencent, CATL» (17-07-2026) ↗
Rep el resum diari d'IA
Cada matí, l'essencial de la intel·ligència artificial al teu correu, sense fum. Al dia amb la IA.
En subscriure-t'hi acceptes rebre el butlletí d'AI Informator. Pots donar-te de baixa quan vulguis.
Comentaris