
Aprenent IA
Mesura si un model cap a la teva GPU
El fitxer descarregat no és suficient per calcular la memòria que necessitaràs. Segons Twin Force, el seu experiment local amb Nemotron 3.5 Bolt E4B en una RTX 4060 Laptop mostra com canvien les reserves quan s'ajusten el context i el repartiment del treball.
En resum
- Segons Twin Force, ampliar el context reservat va augmentar la reserva de memòria cau sense canviar el búfer del model a la GPU.
- Segons Twin Force, traslladar menys capes a la GPU en va reduir l'ocupació, però va augmentar la memòria del model a l'ordinador.
- Segons Twin Force, tots els casos van completar una petició curta; els resultats no garanteixen el comportament d'una conversa que ompli el context.
Comença per distingir les memòries
Abans de carregar un model, distingeix el fitxer al disc de les reserves que apareixen quan l'executes. Segons Twin Force, el pressupost de memòria diferencia els búfers del model, del context i del còmput. L'ús total del dispositiu inclou també l'escriptori i altres consumidors, de manera que tampoc no equival al cost exclusiu del programa.
Segons Twin Force, el fitxer utilitzat ocupa 6.180.446.208 bytes. Aquesta mesura descriu la descàrrega; les taules següents mantenen les unitats de les lectures de memòria, MiB i KiB. No es comparen directament aquestes xifres ni se sumen búfers per reconstruir el fitxer: els mapatges i les còpies representen conceptes diferents.
Fixa la configuració abans de mesurar
Segons Twin Force, la prova va utilitzar Nemotron-3.5-Bolt-E4B-Q4_K_M.gguf amb llama.cpp, compilació 11854 i CUDA 12.8, en una RTX 4060 Laptop. Per reproduir-la, conserva aquest fitxer i aquesta compilació, a més dels ajustos d'execució. La metodologia enllaçada al final inclou la revisió i l'empremta del model, així com les ordres completes.
Segons Twin Force, les arrencades van ser independents i seqüencials, sense escalfament previ i amb l'ajust automàtic de memòria desactivat. Es van mantenir el model, la petició, la llavor, la precisió de la memòria cau, l'atenció, els lots i el nombre de sessions. Primer es va canviar únicament el context; després, el repartiment de capes.
Segons Twin Force, cada petició es va enviar quan el servidor estava a punt. L'entrada tenia 20 tokens i la resposta en va generar 32. Aquesta càrrega breu permet observar les reserves i una execució concreta, però no representa una conversa que hagi ocupat tota la finestra disponible.
Reservar context també ocupa memòria
| Context reservat, tokens | Model a la GPU, MiB | Memòria cau a la GPU, MiB | Pic del dispositiu, MiB |
|---|---|---|---|
| 2.048 | 3.023 | 62 | 3.310 |
| 8.192 | 3.023 | 158 | 3.406 |
| 32.768 | 3.023 | 542 | 3.796 |
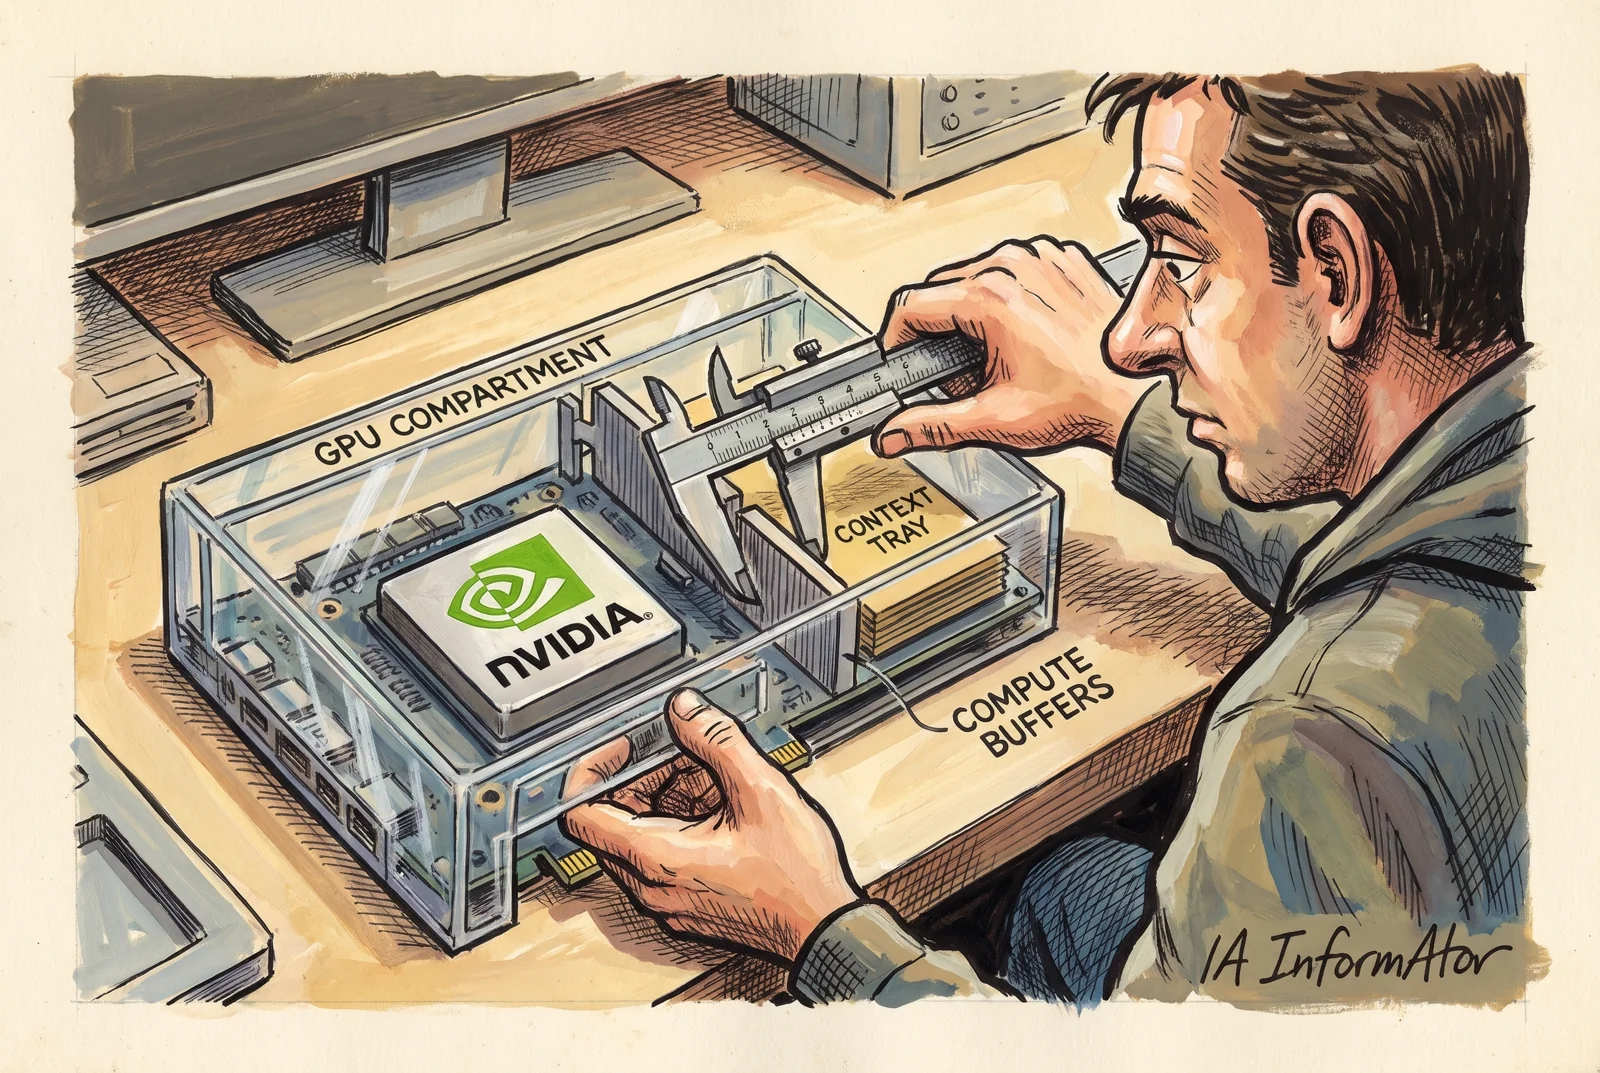
Llegeix la taula per columnes: segons Twin Force, el búfer del model es va mantenir estable mentre augmentaven la reserva del context i el pic observat del dispositiu. El fitxer era el mateix. Per això, triar un context més gran exigeix revisar el pressupost de memòria fins i tot abans de plantejar-se una conversa llarga.
Segons Twin Force, els valors del model i de la memòria cau provenen del resum del programa, expressat en MiB enters. El pic prové del mostreig del dispositiu durant la càrrega i l'execució. Són lectures diferents: el mostreig pot no captar pics més breus i també recull memòria utilitzada per altres consumidors.
La memòria de l'ordinador també compta
| Mesurament | 43/43 capes a la GPU | 20/43 capes a la GPU |
|---|---|---|
| Model a la GPU, MiB | 3.023 | 1.725 |
| Model a l'equip, MiB | 3.536 | 4.833 |
| Pic del dispositiu, MiB | 3.796 | 2.186 |
| RAM resident quan el servei està a punt, KiB | 4.088.392 | 5.836.044 |
Segons Twin Force, declarar totes les capes traslladables a la GPU no vol dir que tots els tensors hi siguin: els registres mantenen búfers del model a l'ordinador. Tampoc no identifiquen quin tensor correspon a cada búfer. Aquesta limitació impedeix assignar-los noms concrets o interpretar-ne la suma com la mida de la descàrrega.
Segons Twin Force, reduir les capes a la GPU amb el mateix context va traslladar part del model i de la memòria cau a l'ordinador. La taula permet comprovar aquest intercanvi: disminueix l'ocupació gràfica i augmenta la memòria resident del programa. El treball que passa al processador continua tenint un cost; aquesta prova no estableix cap millora de velocitat ni de qualitat.
Calcula el pressupost de memòria amb la teva petició
Segueix la seqüència de mesurament: anota l'ús en repòs, engega el servei i registra la memòria quan estigui a punt. Després executa la teva petició i observa el pic durant la càrrega i la resposta. Segons Twin Force, el seu mètode combina el seguiment del dispositiu amb la memòria resident del procés; conservar totes dues lectures evita que el cost a l'ordinador quedi ocult.
Si necessites reduir la reserva de memòria gràfica, prova de retallar el context o de traslladar menys capes a la GPU i torna a mesurar. Segons Twin Force, aquests canvis van modificar el pressupost de memòria en la seva configuració. Tots els casos es van completar correctament: l'experiment no documenta cap fallada per manca de memòria ni garanteix el resultat en un altre equip.
Conclusió
Segons Twin Force, cal comprovar cada configuració amb l'equip, el programa i la càrrega reals amb què es farà servir. Conserva els ajustos juntament amb les lectures per poder repetir la prova. Les dades i la metodologia són a https://twinforce.es/labs/2026-10-24/memoria-gpu.json.
Fonts primàries
La continuació natural
Aprèn IA al teu ritme amb els nostres cursos gratuïts.
A la nostra plataforma d'aprenentatge TAKU podràs accedir a aquest i a molts altres cursos de manera totalment gratuïta.
APRENDRE AMB TAKU
Comentaris