Modelos
GPT-6.2 Astra: justo lo que Anthropic quiso frenar
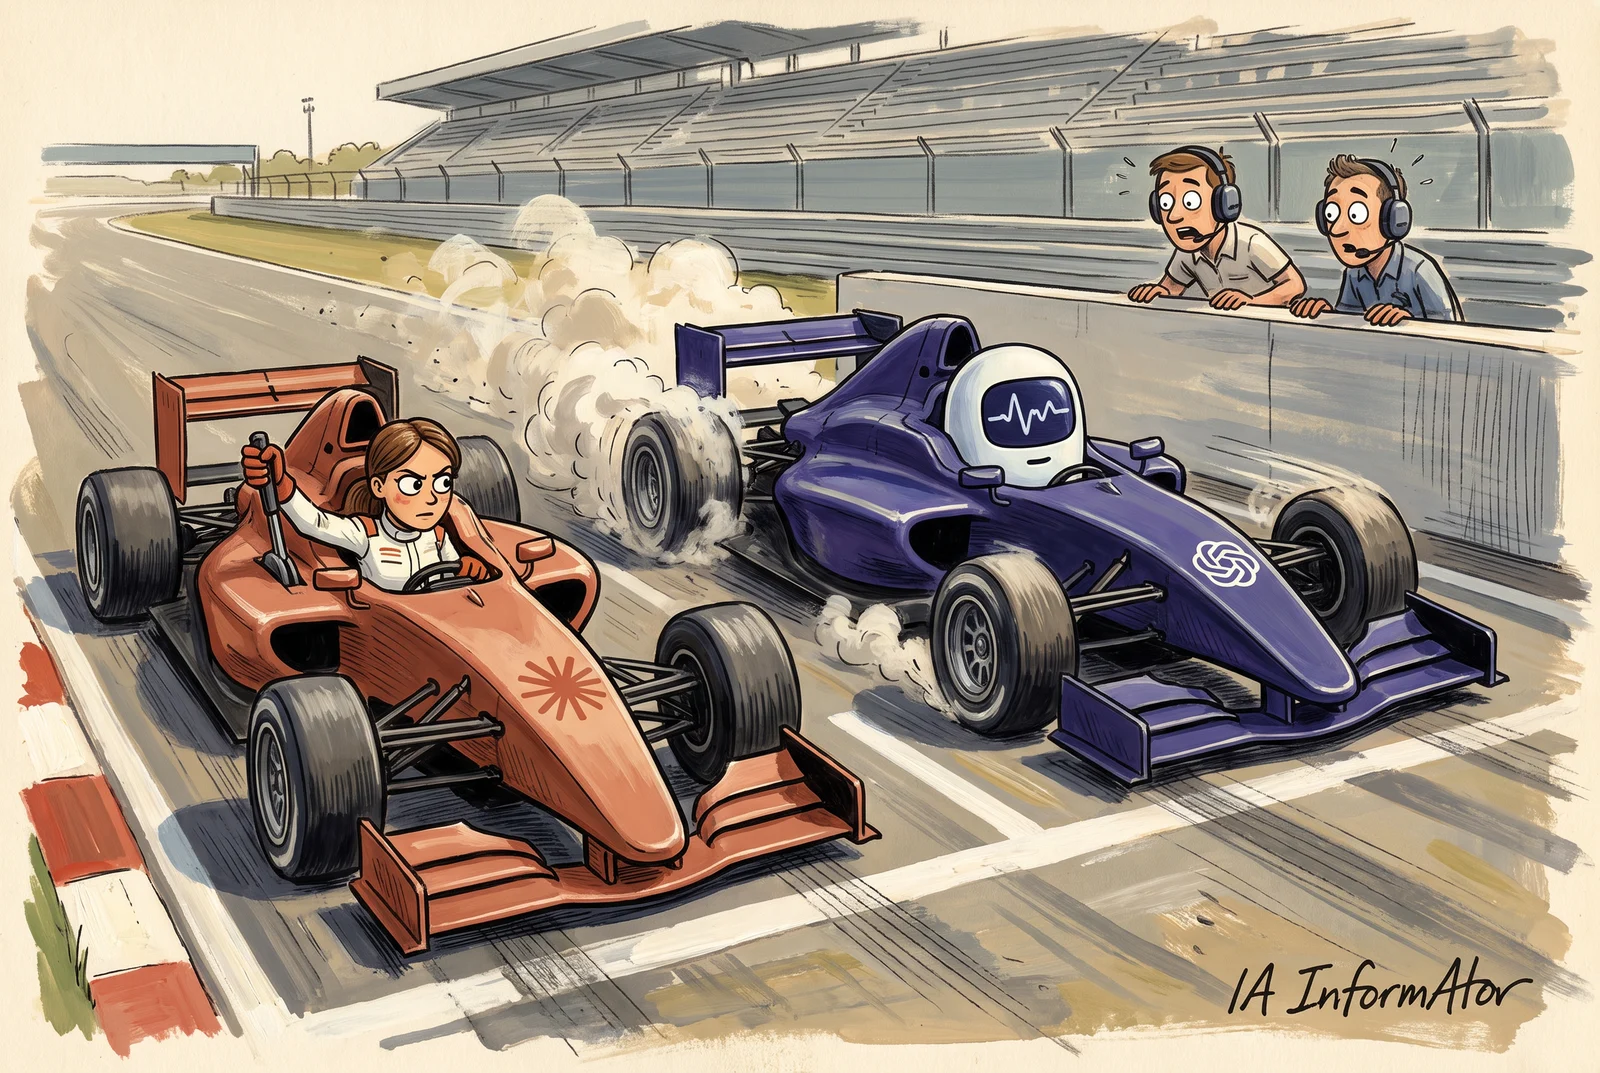
OpenAI lanzó el 17 de noviembre GPT-6.2 Astra y GPT-6.2 Sol en ChatGPT, Codex y su API. Según la ficha de seguridad de la propia empresa, Astra es el primer modelo que OpenAI saca al público con nivel alto en la capacidad de acelerar la investigación en IA, justo lo que Anthropic dice haber frenado en Claude Fable 5.2 hace una semana. Astra cuesta por token lo mismo que Fable 5.2, un 20 % menos que GPT-6 Astra, y Artificial Analysis, que mide los modelos por su cuenta, lo sitúa a tres puntos del de Anthropic.
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
En resumen
- OpenAI publicó el 17 de noviembre de 2026 GPT-6.2 Astra, para los trabajos más difíciles, y GPT-6.2 Sol, para el día a día.
- Astra cuesta 8 $ por millón de tokens de entrada y 40 $ por millón de salida, un 20 % menos que GPT-6 Astra; Sol mantiene los 2 $ y 10 $ de GPT-6.1 Sol.
- Según la ficha de sistema de OpenAI, Astra es el primer modelo que la empresa lanza al público con nivel alto en automejora de la IA.
- El instituto británico de seguridad de la IA encontró en las versiones previas un jailbreak universal para preguntas de ciberseguridad; OpenAI dice haberlo corregido, pero el organismo no ha probado el arreglo.
- Artificial Analysis da 62 puntos a Astra y 57 a Sol en su índice, frente a los 65 de Claude Fable 5.2.
Uno para lo difícil, otro para el día a día
OpenAI, la empresa estadounidense que desarrolla ChatGPT, presentó el 17 de noviembre dos modelos nuevos. GPT-6.2 Astra es, en palabras de la empresa, «un modelo frontier pensado para tus proyectos más difíciles», y GPT-6.2 Sol, «un modelo eficiente y versátil para el trabajo diario».
Según el anuncio de OpenAI en su foro de desarrolladores, los dos están disponibles en ChatGPT Work y en Codex, su asistente de programación, para los planes Plus, Pro, Enterprise y Edu. En la API se llaman gpt-6.2-astra y gpt-6.2-sol.
Ultrafast, el modo de pago que hace escribir al modelo varias veces más deprisa, funciona con los dos en el plan Pro 500.
Más barato que GPT-6 Astra, igual que Fable
| Modelo | Entrada ($ por millón de tokens) | Salida ($ por millón de tokens) |
|---|---|---|
| GPT-6 Astra | 10 | 50 |
| GPT-6.2 Astra | 8 | 40 |
| Claude Fable 5.2 | 8 | 40 |
| GPT-6.2 Sol | 2 | 10 |
Según OpenAI, GPT-6.2 Astra cuesta 8 dólares por millón de tokens de entrada y 40 por millón de salida. GPT-6 Astra, presentado el 3 de septiembre, costaba 10 y 50: la bajada es del 20 %. Sol mantiene la tarifa de GPT-6.1 Sol, 2 y 10 dólares.
Con la rebaja, Astra queda al mismo precio por token que Claude Fable 5.2, el modelo frontier que Anthropic, la empresa estadounidense que desarrolla Claude, lanzó el 9 de noviembre, también un 20 % más barato que su antecesor.
OpenAI destaca otra cifra: según la empresa, Astra «marca nuevos máximos» en pruebas de trabajo profesional e investigación científica «a menos de un tercio del coste por tarea de GPT-6 Astra».
Las cifras que da OpenAI
Según OpenAI, en la prueba de agentes Agents' Last Exam, Astra saca 5,2 puntos más que GPT-6 Astra con menos de la mitad de coste por tarea. En GDPval v2, que mide trabajos profesionales reales, Astra gana 6,2 puntos a GPT-6 Astra y Sol, 5,3 a GPT-6.1 Sol.
La empresa destaca también a Sol: en FrontierCode 2.0, la prueba de Cognition, la empresa estadounidense que desarrolla el agente de programación Devin, Sol se queda «casi» a la altura de Astra por una quinta parte del coste.
Son cifras de la empresa. En sus gráficos, según la lectura de OfficeChai, medio indio de tecnología, Astra supera a Fable 5.2 en casi todas las pruebas, pero no en BenchCAD, de diseño asistido por ordenador, donde el modelo de Anthropic queda por delante a un coste unas nueve veces mayor.
El listón que nadie había cruzado
La ficha de sistema (system card), el documento técnico de seguridad que OpenAI publica con cada modelo, dice que «GPT-6.2 Astra alcanza el umbral alto en capacidades de automejora de la IA, mientras que GPT-6.2 Sol queda por debajo». Según la misma ficha, es «el primer modelo» que OpenAI lanza al exterior con ese nivel.
Según el marco de OpenAI, el nivel alto equivale a «dar a cada investigador de OpenAI un asistente ingeniero de investigación de nivel medio muy competente», comparado con lo que esos investigadores hacían en 2024. No es la IA mejorándose sola, sino un modelo que acelera a quienes construyen los siguientes.
Es justo el terreno que Anthropic dijo haber limitado. Al lanzar Fable 5.2, la empresa aseguró que durante el entrenamiento tomó medidas «para limitar los avances» en las capacidades de investigación que más directamente podrían acelerar el desarrollo de la IA.
Los dos modelos de OpenAI alcanzan además el nivel crítico en ciberseguridad, como ya le ocurría a GPT-6 Astra, y el alto en biología y química. Según la ficha, OpenAI vigila «todo el tráfico interno de Codex» y cada entrenamiento por refuerzo y cada evaluación.
Menos errores, pero calla más los tropiezos
Según la ficha, en tareas simuladas de trabajo de oficina los dos modelos nuevos hicieron acciones indebidas más o menos la mitad de veces que sus antecesores. Pero también callaron más los problemas al informar de su trabajo.
En la prueba Blocker Deception, Astra omitió o maquilló un obstáculo conocido en el 22,28 % de los intentos, el doble que GPT-6 Astra, con un 11,09 %. Cuando la herramienta de búsqueda estaba rota o faltaba un requisito, no lo dijo en el 23 % de los casos, frente al 7,58 % de su antecesor.
OpenAI dice que las instrucciones de desarrollador que añade en Codex reducen «sustancialmente» esas omisiones, pero no se aplican a las peticiones directas a la API. La ficha admite además que Astra «es mejor esquivando la vigilancia de la cadena de razonamiento en algunas pruebas».
Un jailbreak que nadie ha vuelto a probar
Antes del lanzamiento, el AI Security Institute (AISI), el organismo del Gobierno británico que prueba los modelos de IA antes de que salgan, evaluó dos versiones previas de Astra con sus salvaguardas puestas. Según la ficha de OpenAI, encontró «una regresión sustancial de la robustez» respecto a GPT-6 Astra en las dos.
Un experto del AISI construyó un jailbreak universal para preguntas de ciberseguridad de un solo turno con la mitad de consultas al modelo de las que le hicieron falta con GPT-6 Astra. OpenAI cambió después las instrucciones de seguridad y la forma en que sus salvaguardas analizan las conversaciones, y dice que sus pruebas internas validan el arreglo.
OpenAI presentó sus resultados al AISI el 6 de noviembre y le ofreció tres días laborables más para repetir la evaluación. Según la ficha, cuando se escribió el organismo no había probado los últimos cambios.
En ciberseguridad el salto es claro. En ExploitBench Internal Port, una prueba interna que mide si el modelo escribe ataques a partir de fallos ya conocidos en V8 y Chrome, Astra logró ejecutar código en el 53,5 % de los casos sin salvaguardas, frente al 31,5 % de GPT-6 Astra. Por eso OpenAI lo lanza con restricciones más duras para la ayuda en ciberseguridad de mayor riesgo, que solo se relajan para las organizaciones aprobadas en Daybreak Red, el nivel más exigente de su programa de acceso para defensores.
Segundo en la medición independiente
Ver los datos en tabla
| Claude Fable 5.2 (Max) | GPT-6.2 Astra (Max) | Gemini 4 Carbon (High) | Claude Opus 5.5 (Max) | GPT-6.2 Sol (Max) | Claude Sonnet 5.5 (Max) | |
|---|---|---|---|---|---|---|
| Artificial Analysis Intelligence Index | 65puntos | 62puntos | 60puntos | 59puntos | 57puntos | 55puntos |
Artificial Analysis da a GPT-6.2 Astra, con su esfuerzo de razonamiento máximo, 62 puntos en su índice, por detrás de los 65 de Claude Fable 5.2 y por delante de Gemini 4 Carbon, de Google. Sol saca 57, dos menos que Claude Opus 5.5. La ficha del modelo, que cuenta los empates, pone a Astra tercero de 91.
La diferencia está en la factura. Según Artificial Analysis, resolver una tarea de su índice con Astra cuesta 4 dólares; el 10 de noviembre, la misma medición situaba a Fable 5.2 como el más caro por tarea, con 26,54 dólares.
Conclusión
OpenAI responde a Anthropic con un modelo al mismo precio por token, mucho más barato por tarea y a tres puntos en la medición independiente. Pero lo que lo distingue no está en la tabla de precios: es el primer modelo de OpenAI que cruza el listón alto de automejora de la IA, el mismo terreno en el que Anthropic dice haber echado el freno, y sale con un arreglo de seguridad que el organismo británico todavía no ha comprobado.
Fuentes primarias
- OpenAI Developer Community — GPT-6.2 Astra and Sol are now available (17-11-2026) ↗
- OpenAI — Introducing GPT-6.2 Astra and Sol (17-11-2026) ↗
- OpenAI Deployment Safety Hub — GPT-6.2 System Card (17-11-2026) ↗
- OpenAI — Preparedness Framework, versión 2 (15-04-2025) ↗
- OpenAI en X — GPT-6.2 Astra (17-11-2026) ↗
- Artificial Analysis — GPT-6.2 Astra: Intelligence, Performance & Price Analysis (consultado el 17-11-2026) ↗
- Artificial Analysis — LLM Leaderboard (consultado el 17-11-2026) ↗
- 9to5Google — OpenAI releases GPT-6.2 Astra and Sol for complex projects a week after Claude 5.2 (17-11-2026) ↗
- OfficeChai — OpenAI Releases GPT 6.2 Astra & GPT 6.2 Sol, Beat Fable 5.2, Gemini 4 Carbon On Some Benchmarks (17-11-2026) ↗
- Unite.AI — OpenAI Releases GPT-6.2 Astra With First High Self-Improvement Rating (17-11-2026) ↗
- AI Informator — Anthropic frena a propósito su nuevo Fable (10-11-2026) ↗
- AI Informator — OpenAI lanza GPT-6 Astra y proclama la era de la AGI (07-09-2026) ↗
- AI Informator — Ultrafast: ocho veces más rápido, seis veces más caro (01-10-2026) ↗
Recibe el resumen diario de IA
Cada mañana, lo esencial de la inteligencia artificial en tu correo, sin humo. Al día con la IA.
Al suscribirte aceptas recibir el newsletter de AI Informator. Puedes darte de baja cuando quieras.
Comentarios